最新!DeepSeek API 又悄悄变强了?社区实测指向 V4.1 Flash 后台更新
发布日期:2026-10-14
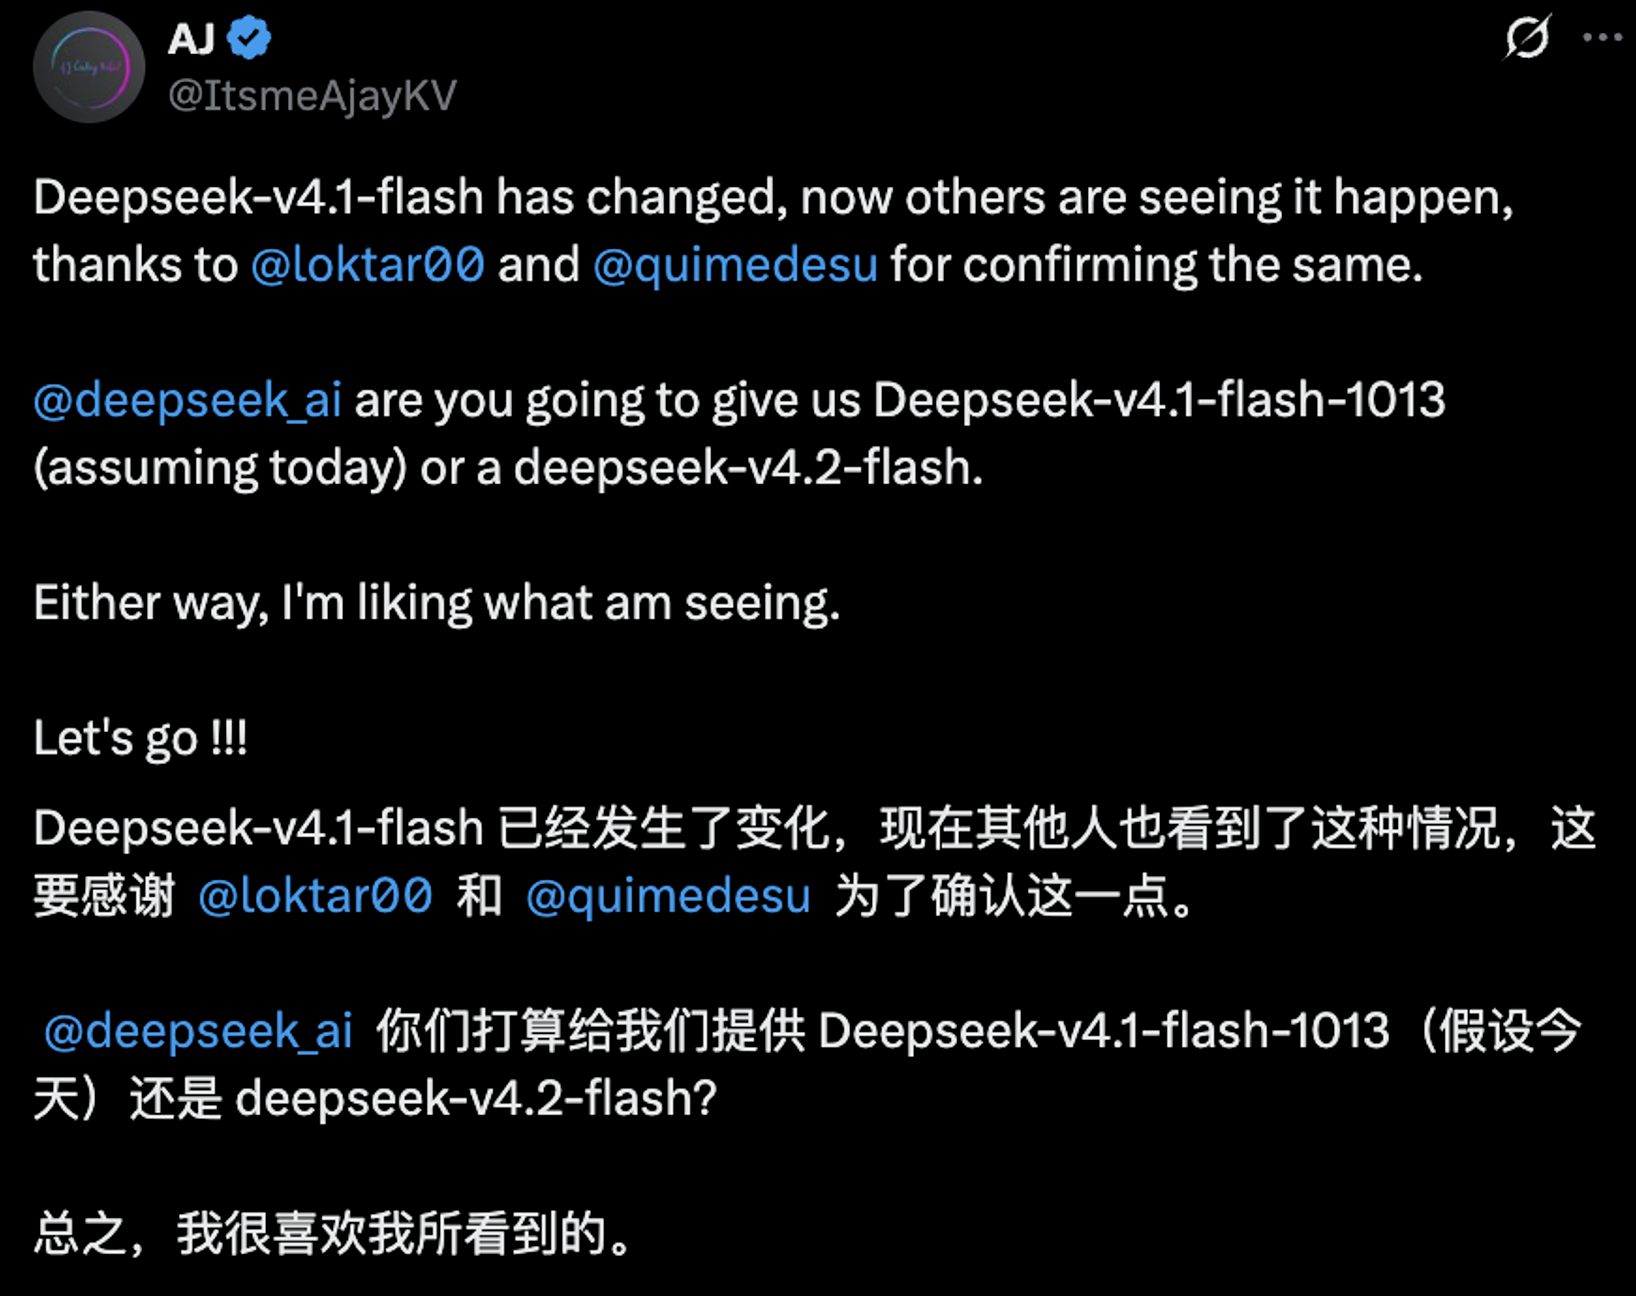
DeepSeek API 最近出现了一波“没有公告的体感变化”:一些开发者发现,官方 deepseek-flash 接口在代码生成、光影细节和动画流畅度上的输出,和 9 月初的记录不太一样,响应速度也似乎慢了一点。现在能确认的是,DeepSeek 官方 API 文档把 deepseek-flash 映射到 DeepSeek-V4.1-Flash;至于 10 月 12 日前后是否换了 checkpoint、是否存在新的内部版本,官方暂时没有公开说明。
先说结论:API 名没变,模型服务可能在变
这次讨论之所以迅速扩散,是因为开发者调用的仍然是熟悉的 deepseek-flash,没有更换 endpoint,也没有看到新的公开模型名,但输出结果出现了可感知的差异。有人反馈生成的前端页面细节更多、动画衔接更顺,另一些人则认为只是随机采样造成的波动。
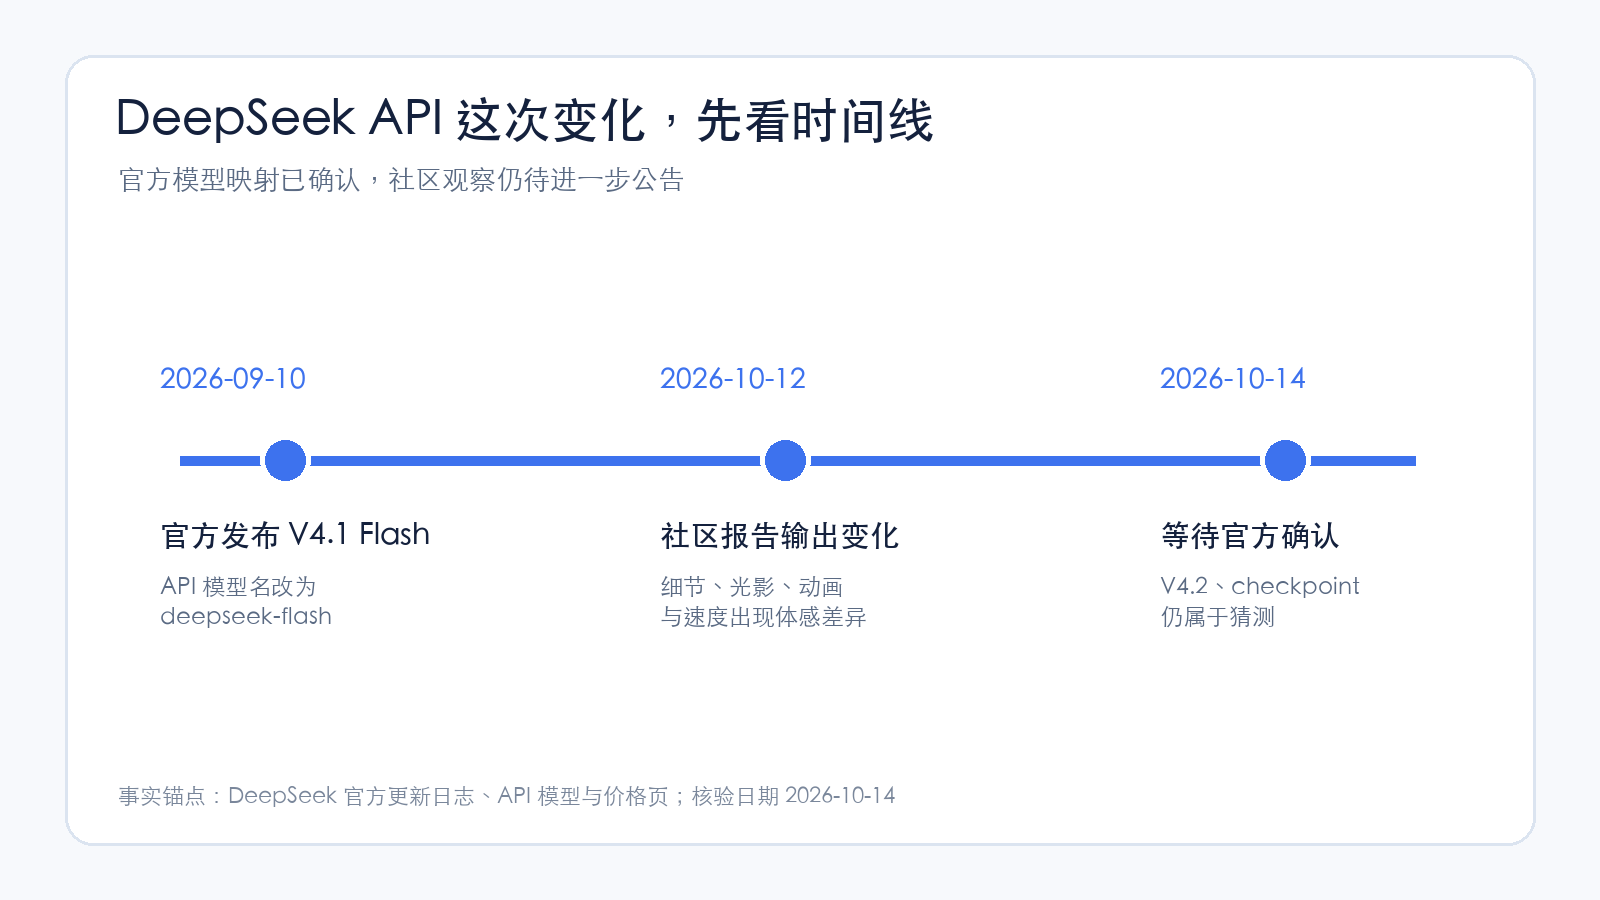
DeepSeek 官方更新日志能确认一条时间线:2026 年 9 月 10 日,V4.1 Flash 正式上线 API,官方要求使用 deepseek-flash 调用;旧的 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 会继续兼容,但请求实际由 V4.1 Flash 提供服务。官方当前模型与价格页也仍把 deepseek-flash 对应到 DeepSeek-V4.1-Flash。
所以,社区现在观察到的变化,可能来自服务端后训练、路由或模型快照更新,也可能只是同一模型在不同随机种子下产生了更好的样本。deepseek-v4.2-flash、deepseek-v4.1-flash-1013 和 “V4.1 Pro 返场”都只是网友提出的猜测,不能当作已经发布的型号。
为什么大家会觉得它“突然变强”
第一个明显感受是细节。相同的网页或游戏场景提示词,在新旧结果对比中,光影层次、材质纹理和 UI 细节更丰富。这类任务对模型的视觉理解、代码组织和多轮修正都很敏感,只要后训练或工具调用策略有小幅变化,最终成品就可能显得更完整。
第二个感受是速度。最早发现变化的测试者提到,10 月 12 日前后的 V4.1 Flash 响应比此前更慢,但仍然比不少其他模型快。速度下降并不必然意味着模型退化,也可能是单次请求生成了更长的思考过程,或者服务端正在采用不同的推理和调度策略。
第三个感受是风格。有人觉得新结果的光影和审美倾向发生了变化,也有人重复测试后没有发现明显差异。模型输出本来就受 temperature、thinking 开关、输入上下文和随机种子影响,单张图或单个页面不足以证明版本升级。
想自己复测,先把变量锁住
最简单的做法,是连续两天使用同一个模型名、同一份提示词和同一组参数,把原始响应完整保存下来。官方 API 使用 OpenAI 兼容格式,下面是一份最小测试命令:
export DEEPSEEK_API_KEY="YOUR_API_KEY"

curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{
      "role": "user",
      "content": "用 JavaScript 制作一个可交互的 Minecraft 风格方块场景,要求有地形、光影、材质层次和流畅的相机移动。请输出可直接运行的单文件 HTML。"
    }],
    "stream": false,
    "temperature": 1.0
  }'
这条命令不要在不同日期里随意改提示词。建议至少记录六项:请求时间、模型名、thinking 设置、首 token 延迟、完整响应耗时、输出文件大小。对于代码类任务,再增加浏览器实际运行是否报错、交互是否可用、人工修复了多少行三个指标。
三个猜测,分别意味着什么
如果是 V4.1 Flash 的新 checkpoint,调用方式大概率不会变化,变化主要体现在输出质量、推理时长和失败率上。开发者无需迁移代码,但需要重新跑一遍自己的回归集。
如果是新的 V4.2 Flash,官方通常会在更新日志、模型与价格页或公告中给出新的模型名、能力说明或计费信息。在这些官方信息出现前,直接把体感变化写成“V4.2 上线”会把猜测误当事实。
如果是临时路由或服务端灰度,测试结果可能随时间、账号和请求负载变化。此时最有价值的不是寻找一张“神图”,而是收集多轮、多任务、多时间点的记录,观察变化是否稳定存在。
对开发者来说,真正值得关注什么
第一是模型名的稳定性。当前官方文档仍建议使用 deepseek-flash,旧模型名虽然兼容,但已被标记为 retired,并由 V4.1 Flash 承接请求。新项目应直接使用当前推荐名称,避免继续依赖旧别名。
第二是成本和延迟的平衡。模型输出更细,往往也意味着生成时间和输出 token 增加。团队应该用自己的任务集计算“每个成功任务的成本”,不要只比较一次调用的速度。
第三是回归测试。把代码生成、网页制作、长文本总结和工具调用各准备一组固定样例,每次 API 观察到变化时重跑。七牛云 Token Plan 页面提供多模型调用的用量管理入口,适合把测试和生产用量分开记录;具体可用模型与计费规则仍以官方页面当前信息为准。
截至 2026 年 10 月 14 日,DeepSeek API“突然变强”的说法有社区实测作为线索,也有官方模型映射作为背景,但还没有官方公告证明这是 V4.2 或某个新 checkpoint。更稳妥的做法,是把它当成一次值得复测的服务端变化:固定变量、保存原始响应、连续测试,再等待 DeepSeek 的正式说明。
参考资料
DeepSeek API 官方更新日志:https://api-docs.deepseek.com/zh-cn/updates
DeepSeek API 官方快速开始:https://api-docs.deepseek.com/
DeepSeek API 官方模型与价格:https://api-docs.deepseek.com/quick_start/pricing
DeepSeek API 官方中文模型与价格:https://api-docs.deepseek.com/zh-cn/quick_start/pricing
七牛云产品
七牛云 Token Plan(deepseekV4最低1.2折):面向多模型调用的用量管理入口,具体套餐、可用模型和计费规则以官方页面当前信息为准:https://www.qiniu.com/ai/plan