开源模型全盘点:2026年10月九大模型家族,编程、多模态与本地部署怎么选
资料核验日期:2026-10-14
开源模型盘点需要同时看模型能力、部署条件和许可证。依据截至2026年10月14日的官方模型卡,DeepSeek、Qwen、GLM、Kimi、MiniMax、gpt-oss、Gemma、Mistral、Llama九个主流家族,已经覆盖编程Agent、长文档和图文理解等需求,但不同版本的开放条款并不一致。选型时既要区分标准许可证与自定义许可证,也要分清总参数、激活参数和实际显存,再用自己的任务验证效果。
模型很多,先把“开放了什么”看明白
公开权重是模型选型的重要起点,完整开源AI的判断还需要看其他发布物。
截至2026年10月核验的OSI《Open Source AI Definition 1.0》,可修改形式涉及训练数据信息、代码和参数。因此,看到MIT或Apache 2.0标注,可以确认对应发布物的许可,不能只凭这一项就宣布整个AI系统满足完整开源定义。
这篇盘点聚焦通用语言模型及原生多模态模型,覆盖九个主流家族的代表发行物。图像生成、视频生成、语音合成、嵌入模型属于另外几条技术路线,需要单独比较。
九大模型家族,一张表先找方向
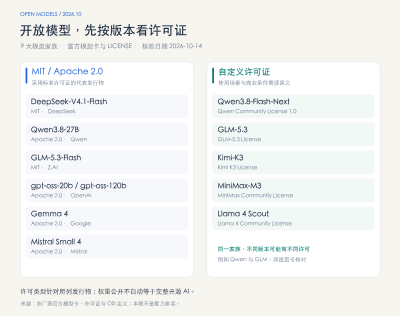
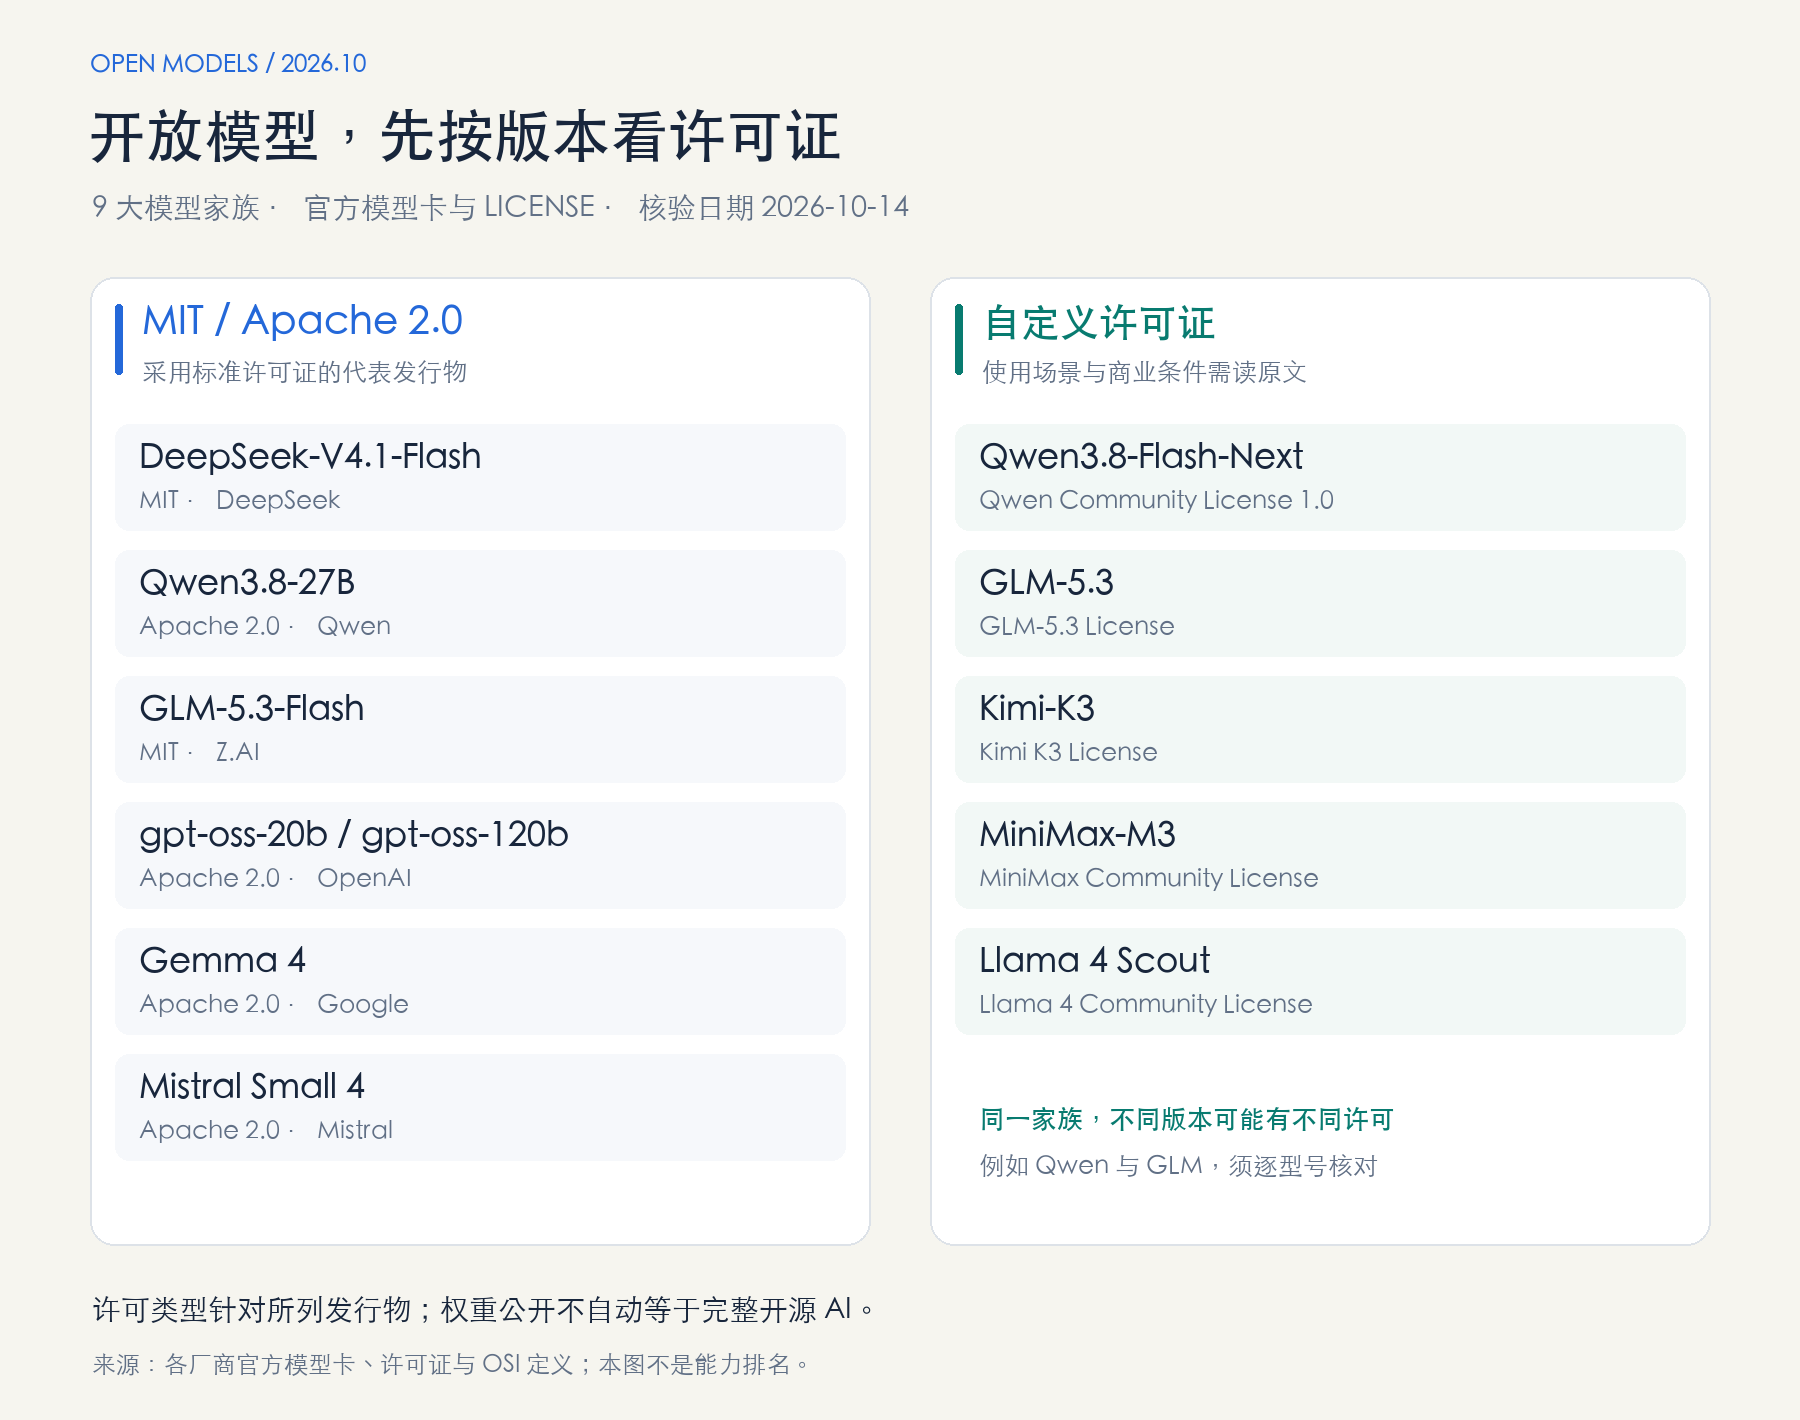
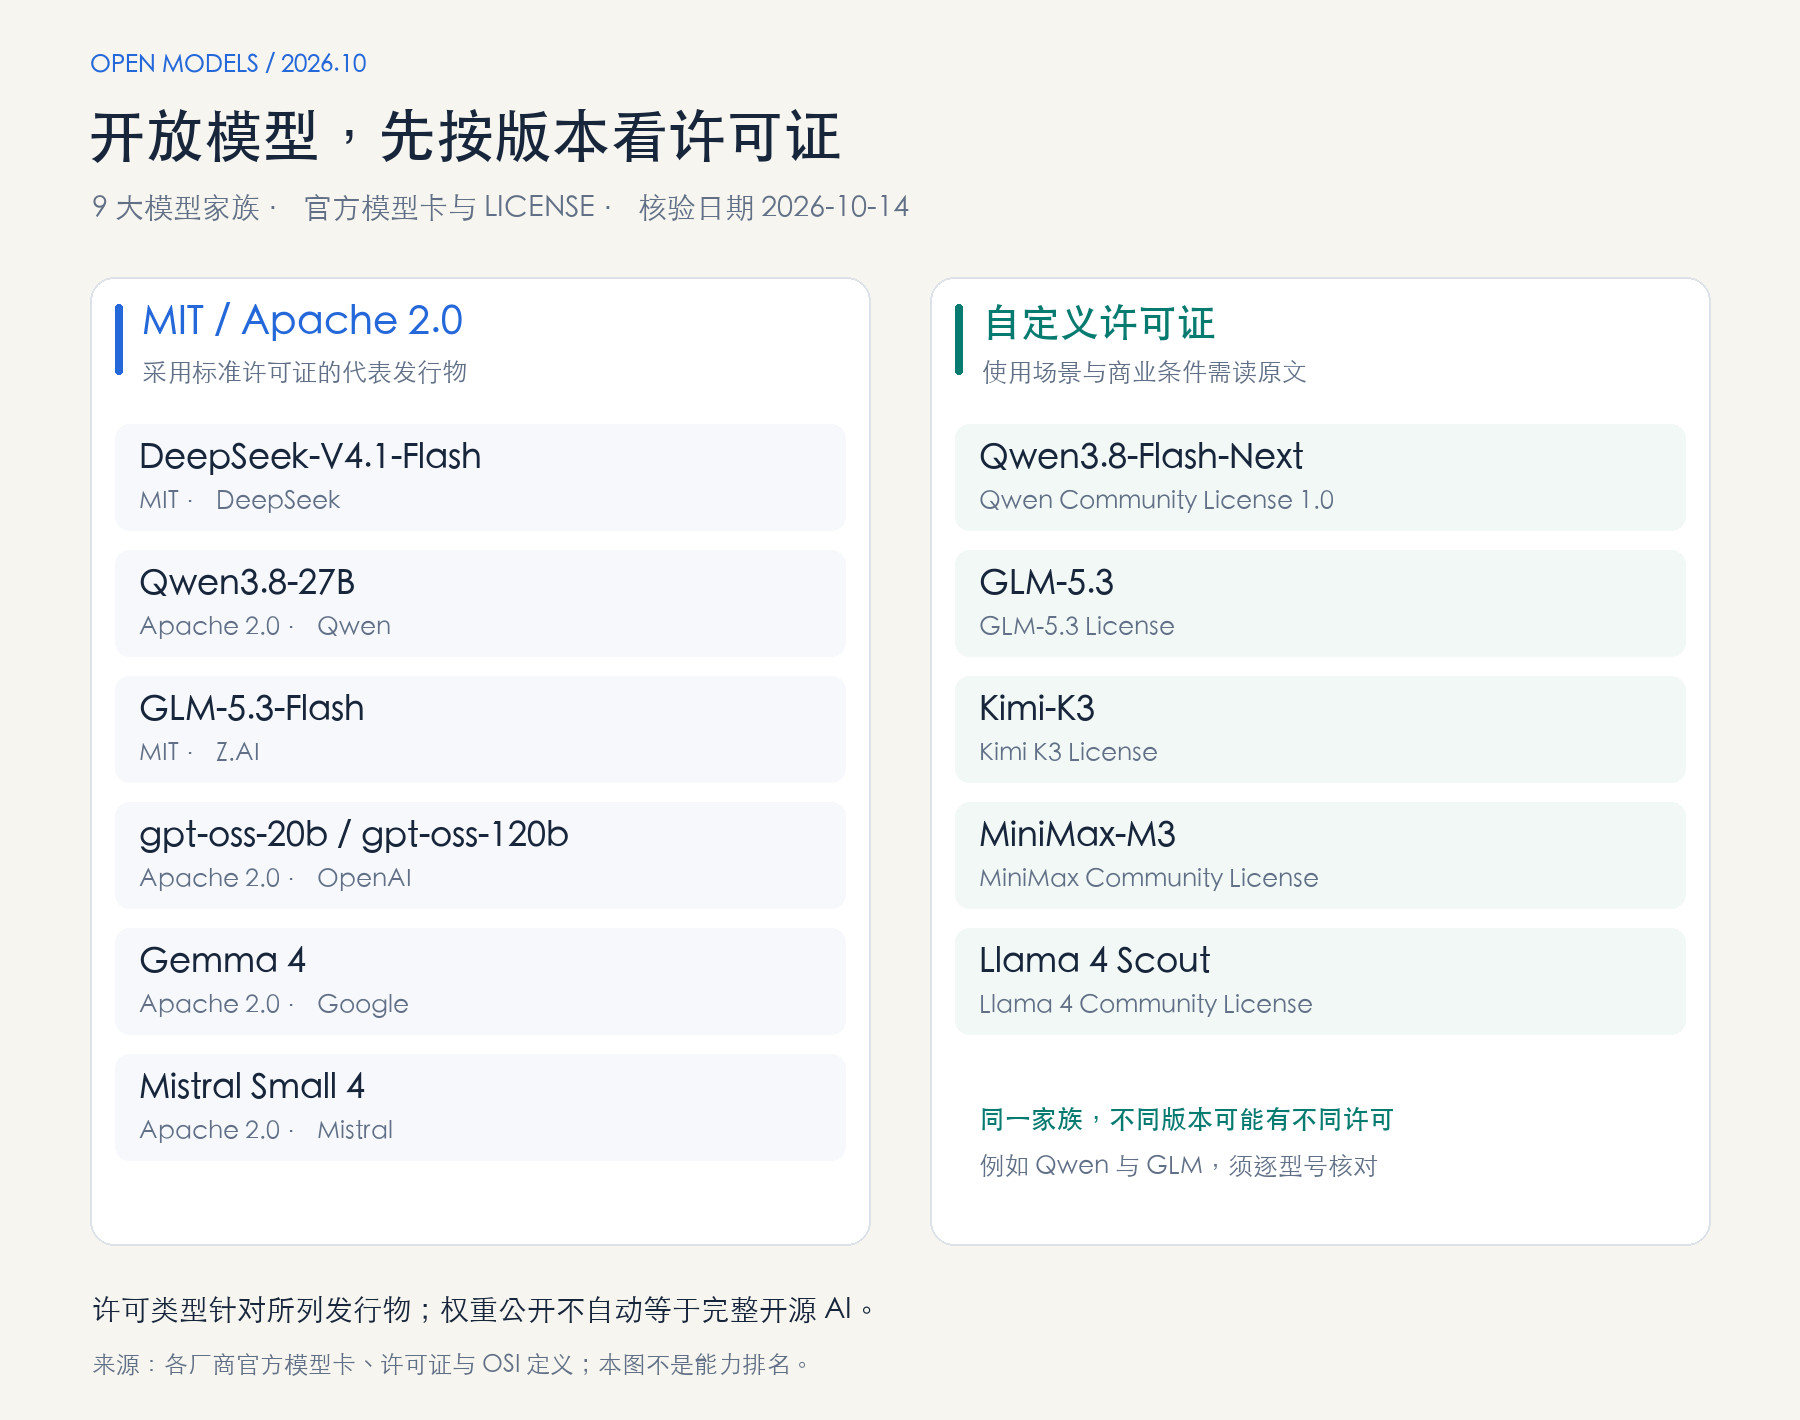
模型许可证必须按具体版本核对,不能用家族名称代替发行物的条款。
下表依据2026年10月14日核验的官方模型卡和许可证整理;“关注方向”表示可以纳入测试的任务,不代表跨厂商排名。
最容易看漏的是同一家族内部的差异:Qwen3.8-27B采用Apache 2.0,Flash-Next采用社区许可;GLM-5.3-Flash采用MIT,GLM-5.3则采用自定义许可。公司名称相同,并不意味着商业使用条件相同。
写代码、跑Agent:先看任务能不能做完
编程Agent选型需要评估跨文件修改、工具调用和任务完成情况,单次生成页面只能覆盖其中一部分。
DeepSeek-V4.1-Flash、GLM-5.3-Flash、GLM-5.3、Kimi-K3和MiniMax-M3,都在各自官方模型卡中强调编程或Agent能力。可以把它们放进同一组实际工程任务,但不要把厂商各自的榜单直接拼成一张“谁最强”排名。
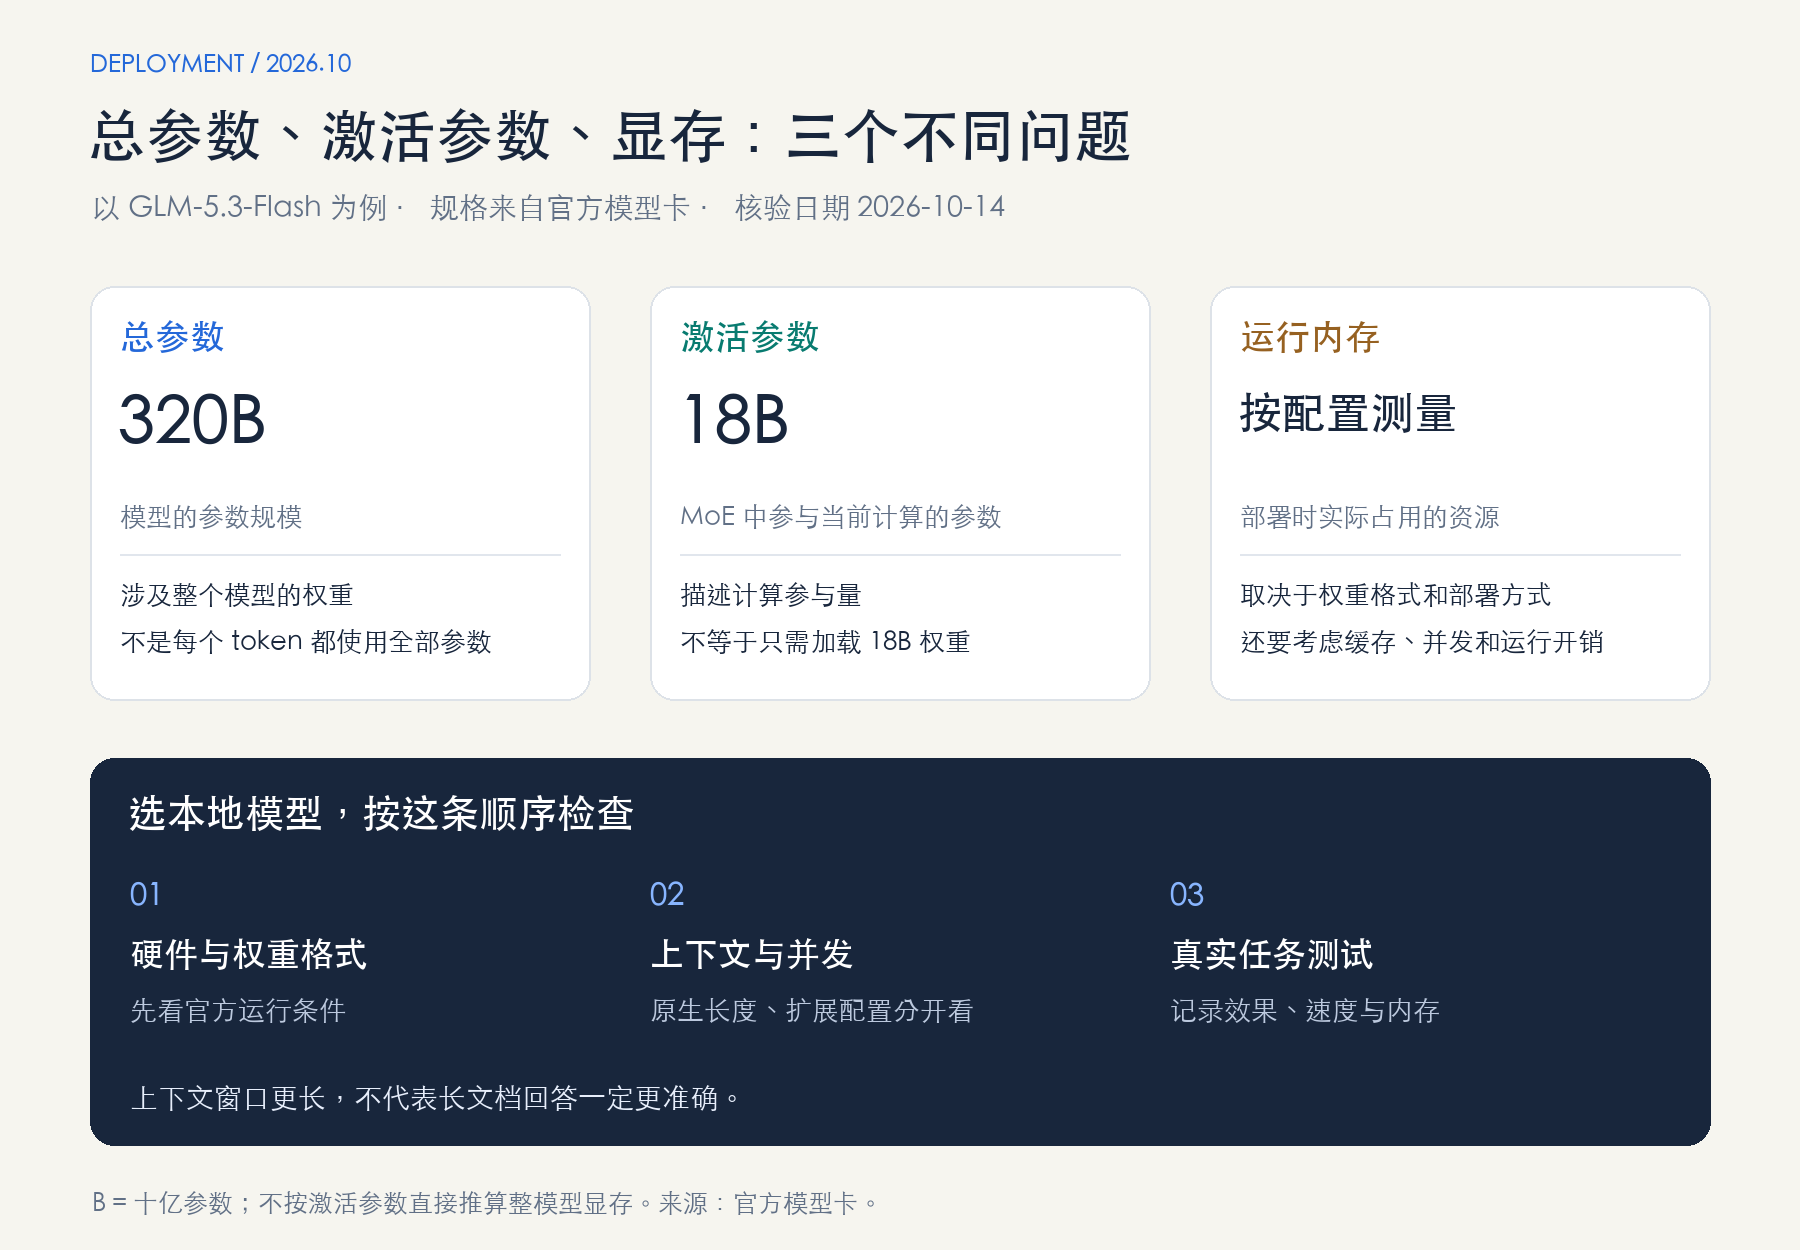
据2026年10月核验的DeepSeek官方模型卡,V4.1-Flash的骨干网络为552B参数,预填充阶段激活8B、解码阶段激活16B,上下文最高支持100万token。这里的激活量描述计算参与量,不是整个模型的加载规模。
据同期Z.AI官方模型卡,GLM-5.3-Flash为320B总参数、18B激活参数;MiniMax官方模型卡标注M3约428B总参数、约23B激活参数。Kimi-K3官方模型卡则标注2.8T总参数,强调原生多模态Agent与长期代码工程。
这些大模型的实际部署还涉及权重格式、推理框架和集群资源。个人开发者可以先在可用的托管环境验证任务效果,再决定是否投入自建部署。
本地部署:从官方运行条件往回选
本地部署应从硬件条件和推理配置筛选模型,不能只看名字里的“Small”或“Flash”。
OpenAI在2025年8月发布的Ollama教程建议,gpt-oss-20b使用至少16GB显存或统一内存。gpt-oss-120b官方模型卡在2026年10月核验时,说明其MXFP4权重可在一块80GB GPU上运行。
这些说明对应各自的推理环境与权重格式,不能当作所有配置的统一硬件保证。长上下文、并发和工具环境仍需另外评估。
Qwen3.8-27B是27B稠密模型,也可以纳入本地部署测试。其官方模型卡在2026年10月核验时标注:原生上下文为262,144 token,可扩展至100万。扩展上限需要相应配置,不能直接当作默认运行能力。
Gemma 4家族提供E2B、E4B、12B、26B A4B和31B等尺寸,可按设备条件缩小候选范围。这里尤其要留意:尺寸名称、实际参数量和显存占用是不同概念。
看图、听音频、读长文:能力要落实到型号
多模态选型必须逐项确认输入和输出,图片理解、视频理解和音频理解不能互相替代。
DeepSeek-V4.1-Flash、Qwen3.8-27B、GLM-5.3-Flash、Kimi-K3、MiniMax-M3、Mistral Small 4和Llama 4 Scout,均有官方图文能力说明。需要处理视频时,再核对具体模型卡中的视频输入方式与限制。
Gemma 4尤其适合用来理解“家族能力不等于单型号能力”:据2026年10月核验的Google官方模型卡,E2B、E4B、12B支持音频输入;31B版本标注的是图文输入、文本输出,不能把其他尺寸的音频能力直接套过去。
长文档也不能只比窗口数字。据同期官方模型卡,Mistral Small 4上下文为256K,Llama 4 Scout标注10M。但实际能否准确找出证据、识别矛盾,仍要用目标文档测试;窗口长度不是答案准确率。
今天就能做的选型测试
相同输入、相同工具和相同验收标准,才能让模型比较对你的业务有用。
先挑一个真实小任务,例如修复现有项目中的CSV导出问题。把同一份代码、需求和测试材料交给候选模型,固定工具权限与推理设置,记录是否完成、改动是否正确、耗时和资源消耗,并进行重复测试。
可以直接使用下面这段任务模板:
任务:修复这个项目的 CSV 导出功能。
验收:支持中文、逗号、双引号和换行;保持现有接口行为。
约束:先阅读相关代码,再修改;不要引入无关依赖。
交付:列出修改文件,提供测试方法,并说明未解决的问题。
输入:在这里提供同一份项目代码和问题复现步骤。
多模态任务则换成同一张扫描件或同一段视频,比较字段提取、引用证据和漏项情况。采用订阅内托管模型做测试时,七牛云Token Plan产品页说明支持用统一API Key接入订阅内多款主流模型,并按积分消耗计量;可测型号以当时的订阅清单为准。
最后,把许可证检查落实到自己的使用方式。Qwen3.8-Flash-Next对商业MaaS及符合定义的独立AI工作助手另设许可要求;Kimi-K3与GLM-5.3对特定规模的MaaS主体设有附加条件;MiniMax-M3还有商业署名、通知或授权要求。
开放模型选型可以先用官方模型卡筛选能力,再用真实任务验证效果,用对应版本的LICENSE确认使用条件。OpenAI与Google的模型卡也说明,部署条件和多模态能力需要落实到具体尺寸与配置。
本文数据截至2026年10月14日,来源见文末参考资料;资料核验日期不代表各模型发布日期。
七牛云Token Plan(AI大模型企业订阅1.2折):https://www.qiniu.com/ai/plan