目录

2026 年 7 月,全球 AI 模型竞争进入史上最密集的发布周期:Google DeepMind 于 7 月 21 日推出 Gemini 3.6 Flash,月之暗面 7 月 16 日发布全球最大开源模型 Kimi K3(2.8T 参数),OpenAI 7 月 10 日正式开放 GPT-5.6 系列(Sol / Terra / Luna 三档),Anthropic 则于 6 月 10 日推出公开版旗舰 Claude Fable 5。本文基于官方数据和实测基准,从性能、定价、上下文、适用场景四个维度做全面横向对比,帮助开发者在 1 个月内新增 4 款主力模型的情况下,快速确定技术选型。
四款模型一览:定位与发布时间
| 模型 | 发布方 | 发布时间 | 核心定位 |
|---|---|---|---|
| Gemini 3.6 Flash | Google DeepMind | 2026-07-21 | 主力工作模型,编程+Agent+token 效率 |
| GPT-5.6 Sol | OpenAI | 2026-07-10 | 旗舰性能,科研级 Agent,成本优化 |
| GPT-5.6 Terra | OpenAI | 2026-07-10 | 企业均衡,性能接近 Sol,价格减半 |
| GPT-5.6 Luna | OpenAI | 2026-07-10 | 轻量低成本,高并发消费场景 |
| Kimi K3 | 月之暗面(Moonshot AI) | 2026-07-16 | 全球最大开源模型,前端编程 Arena 登顶 |
| Claude Fable 5 | Anthropic | 2026-06-10 | 公开旗舰,Agent 编程最强之一 |
性能对比:关键 Benchmark 数据
编程能力(SWE-bench 系列)
| 模型 | SWE-bench Pro / Verified | 备注 |
|---|---|---|
| Claude Fable 5 | SWE-bench Verified 88.6% / SWE-bench Pro 80.3% | 来源:Anthropic 官方,2026-06-10 |
| GPT-5.6 Sol | Coding Agent 指数 80 分(Artificial Analysis) | 超越 Fable 5,来源:OpenAI 官方,2026-07-10 |
| Gemini 3.6 Flash | DeepSWE 49% | 来源:Google DeepMind 官方,2026-07-21 |
| Kimi K3 | 前端编程 Arena 全球第一(1527 分,AA-Briefcase) | 超越 GPT-5.6 Sol Max(1495 分);来源:智源社区,2026-07-17 |
结论:综合编程能力排序(Agent 任务)大致为 GPT-5.6 Sol ≈ Kimi K3 > Fable 5 > Gemini 3.6 Flash。Kimi K3 在前端 Arena 榜中击败所有对手,但综合基准仍稍逊于 Fable 5 和 GPT-5.6 Sol。
综合智能(Agent / 推理类)
| 模型 | 基准测试 | 分数 | 来源 |
|---|---|---|---|
| Claude Fable 5 | GDPval-AA | 1932 | benchlm.ai,2026-06-10 |
| GPT-5.6 Sol | Agents' Last Exam | 53.6(+13.1 vs Fable 5) | OpenAI 官方 |
| Gemini 3.6 Flash | GDPval-AA v2 | 1421 | Google DeepMind 官方 |
| Kimi K3 | AA-Briefcase | 1527(超越 GPT-5.6 Sol Max 1495) | 智源社区 |
计算机使用 / 多模态(OSWorld)
| 模型 | OSWorld-Verified |
|---|---|
| Gemini 3.6 Flash | 83.0% |
| Gemini 3.5 Flash(对比) | 78.4% |
| GPT-5.6 / Fable 5 | [未在官方发布材料中单独披露] |
定价对比:每百万 Token 成本
| 模型 | 输入价 | 输出价 | 相对成本 |
|---|---|---|---|
| Kimi K3 | ¥2(缓存命中)/ ¥20 | ¥100 | 缓存率超 90%,实际成本极低 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 最低成本,高吞吐首选 |
| GPT-5.6 Luna | $1.00 | $6.00 | OpenAI 轻量档 |
| Gemini 3.6 Flash | $1.50 | $7.50 | 低于 3.5 Flash |
| GPT-5.6 Terra | $2.50 | $15.00 | OpenAI 均衡档 |
| GPT-5.6 Sol | $5.00 | $30.00 | OpenAI 旗舰档 |
| Claude Fable 5 | $10.00 | $50.00 | 最贵,约为 GPT-5.6 Sol 的 2× |
数据来源:OpenAI 官方定价页(2026-07-10)、Google DeepMind 博客(2026-07-21)、Anthropic 官方文档、Kimi API 定价页(2026-07-17)
上下文窗口 & 输出能力
| 模型 | 上下文窗口 | 最大输出 |
|---|---|---|
| Claude Fable 5 | 1M token | 128K token |
| Kimi K3 | 1M token | [待官方披露] |
| GPT-5.6 Sol | 1,050,000 token | 128K token |
| Gemini 3.6 Flash | [待官方披露] | — |
Fable 5 和 Kimi K3 均支持 100 万 token 长上下文,GPT-5.6 Sol 官方标注 1,050,000 token 且分短/长上下文两档计价。
Token 效率:同等质量下谁更省钱?
这是 2026 年模型竞争的新维度——不只看分数,更看输出多少 token 能解决问题。
| 模型 | Token 效率亮点 |
|---|---|
| GPT-5.6 Sol | Coding Agent 输出 token 不到 Fable 5 的 1/2,执行时间约 1/2,成本约 1/3 |
| Gemini 3.6 Flash | 输出 token 比 3.5 Flash 减少 17%,代码场景最高削减 65% |
| Kimi K3 | KDA 架构 KV 缓存减少 75%,解码吞吐最高提升 6 倍 |
| Claude Fable 5 | 定价最高,但 Fable 5 的 Low 思考档成本比 Opus 4.8 更低 |
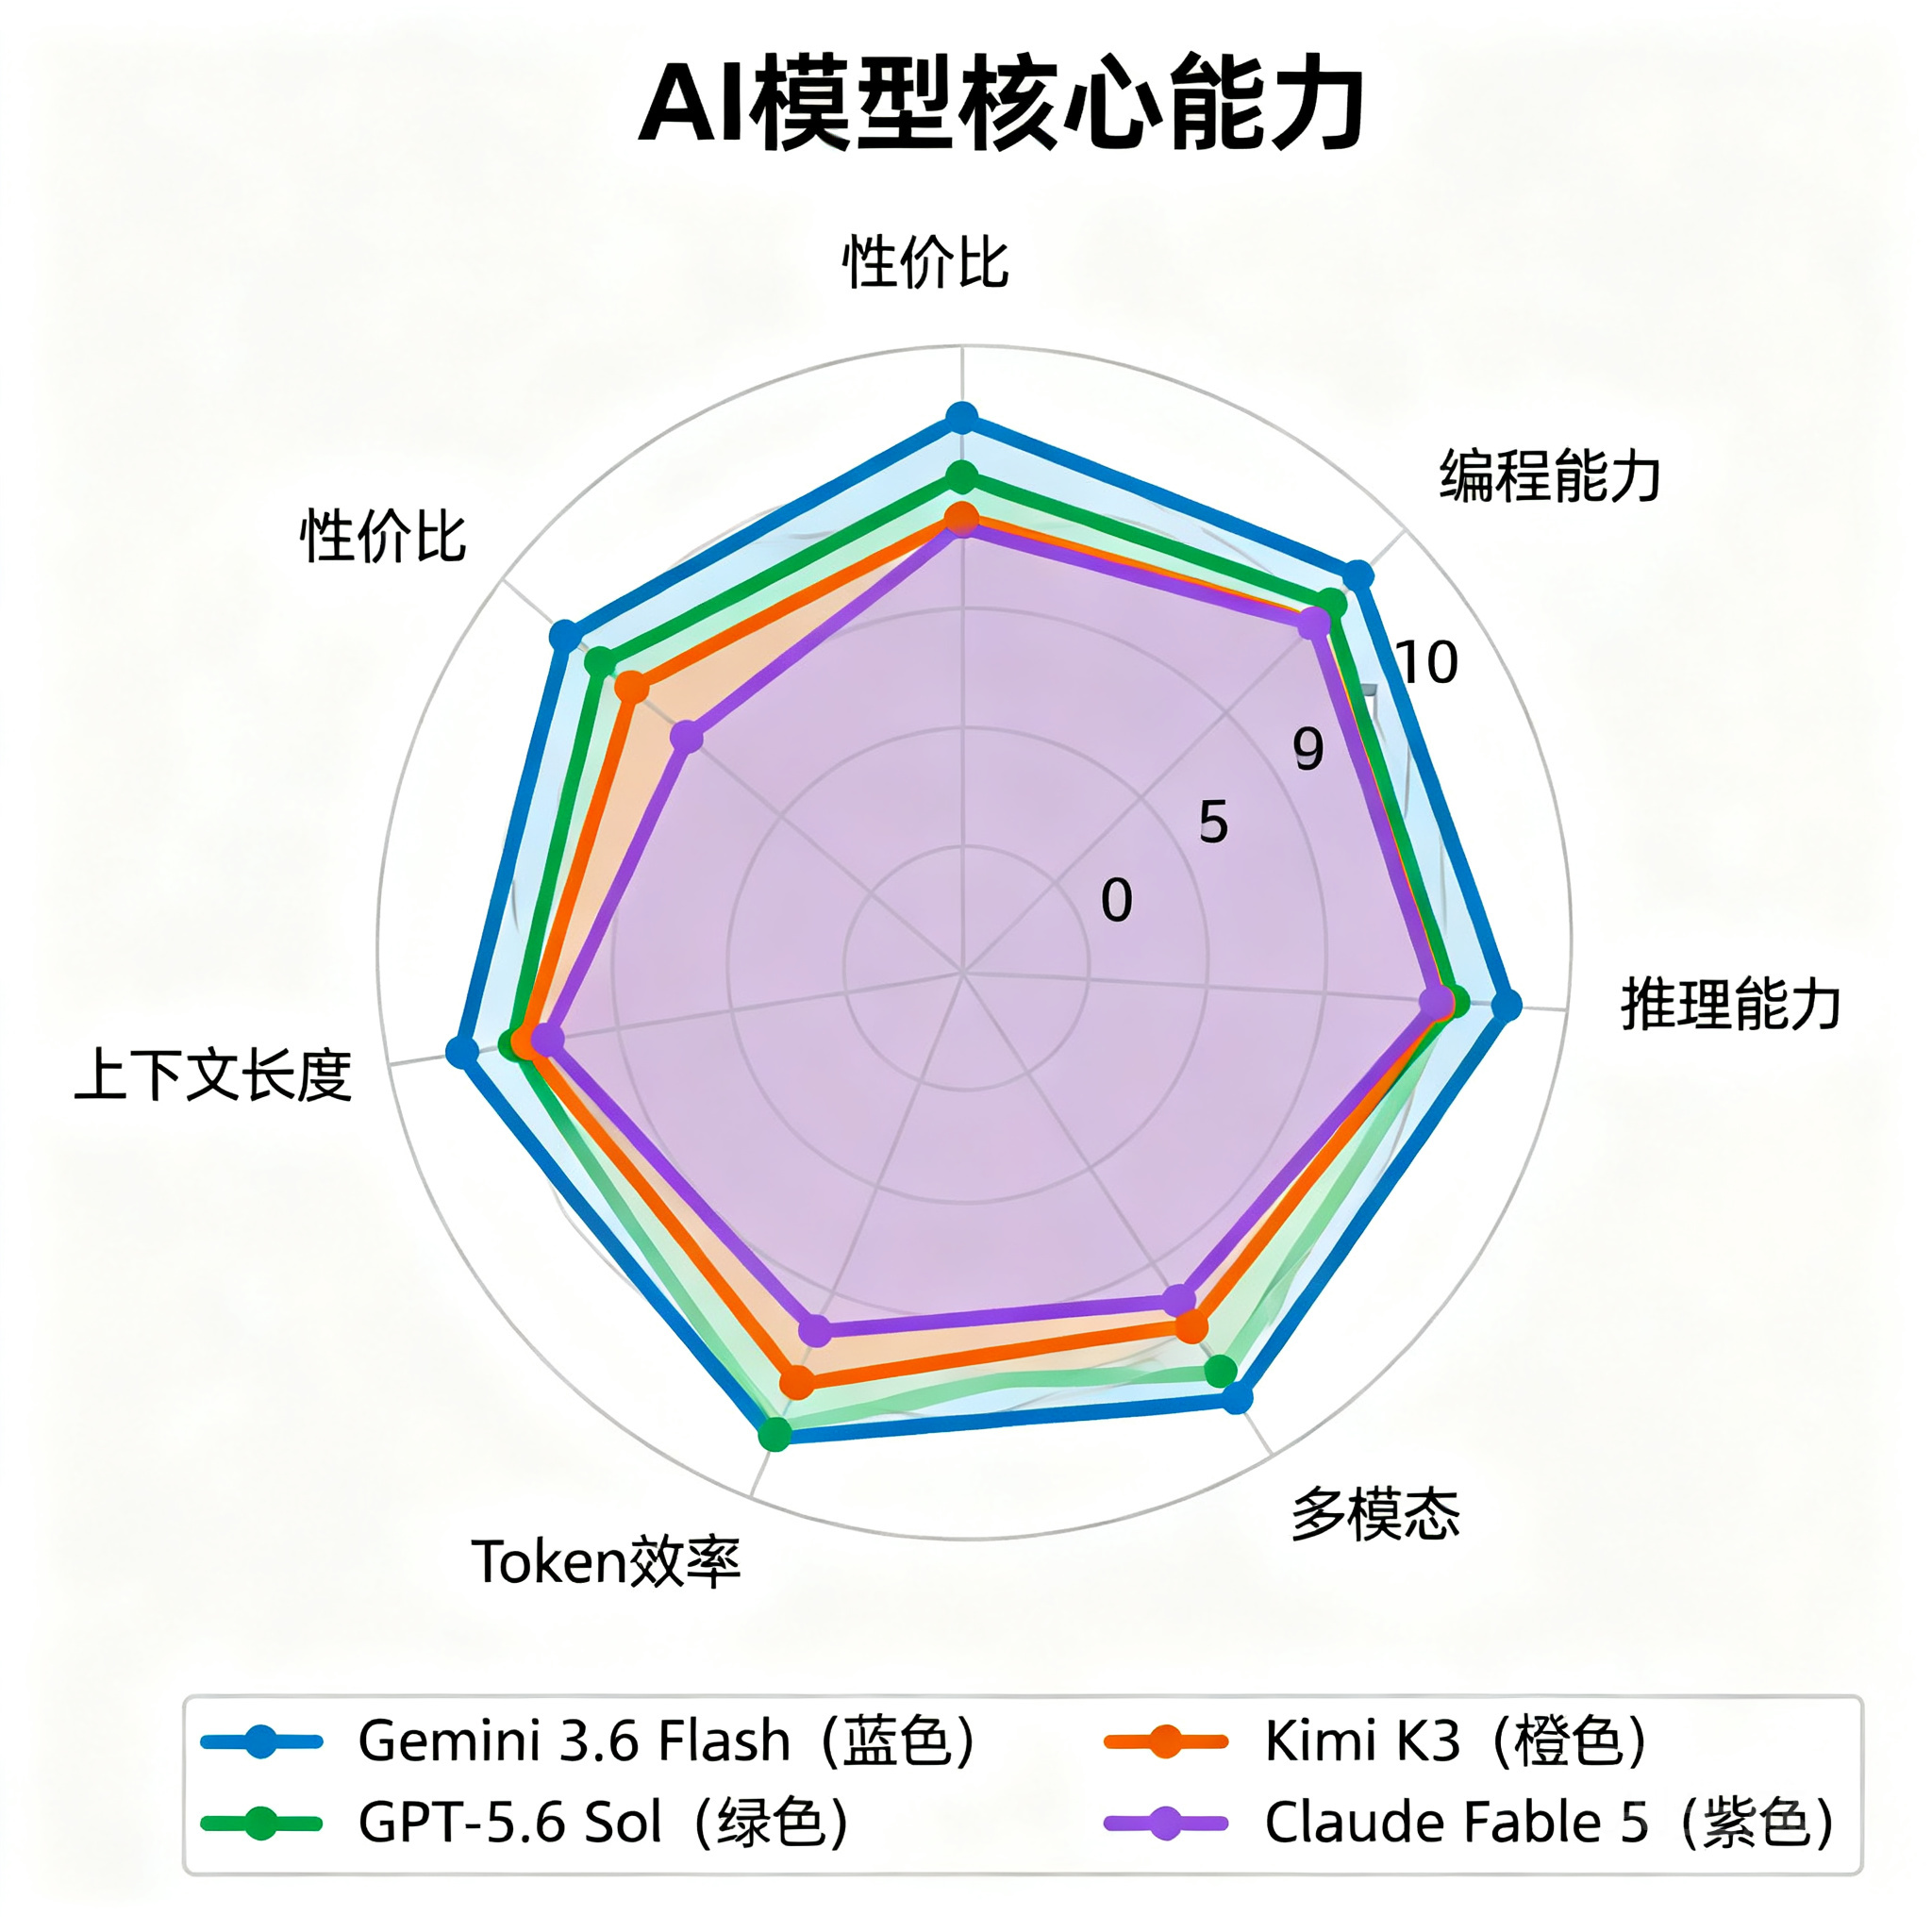
各模型核心能力亮点
Gemini 3.6 Flash:内置 Computer Use,Agent 多模态全能
- Computer Use 内置为客户端工具,无需额外配置即可构建跨平台 Agent
- OSWorld-Verified 83.0%,Flash 系列最高
- MLE Bench 机器学习实验得分 63.9%(+14.2pp vs 3.5 Flash)
- 增强 CBRN + 网络安全防护,企业合规场景友好
- 同期推出 Gemini 3.5 Flash-Lite(350 tok/s,$0.30/$2.50)用于高吞吐轻量任务
GPT-5.6 Sol:三档灵活组合,性价比最强旗舰
- 三款子模型(Sol / Terra / Luna)覆盖不同预算区间,同一 API 切换
- Agents' Last Exam 53.6 分,比 Fable 5 高 13.1 分
- Coding Agent 成本约为 Fable 5 的 1/3,输出 token 减半
- 上下文 1.05M token,提供短/长上下文两档计价
- 定位"AI 操作系统"而非单一模型,与 ChatGPT Work、Codex 深度整合
Kimi K3:全球最大开源模型,前端 Arena 登顶
- 2.8T MoE 参数,896 个专家,每次激活 16 个,全球最大开源权重
- 前端编程 Arena 全球第一(1527 分,超越 GPT-5.6 Sol Max)
- KDA 架构:KV 缓存减少 75%,解码吞吐提升最高 6×
- 1M token 上下文,支持原生视觉、长任务 Agent
- 定价 ¥2-20/¥100 每百万 token(缓存命中率超 90%,实际成本极低)
- 完整权重将于 7 月 27 日前开源,可本地部署
Claude Fable 5:Agent 编程最高精度,企业长任务首选
- SWE-bench Verified 88.6% / Pro 80.3%,编程精度仍是公开模型最高之一
- GDPval-AA 1932 分,综合智能领先
- 1M token 无溢价长上下文(同价计费)
- 实测:5000 万行 Ruby 代码库迁移,1 天完成 vs 人工团队 2 个月
- 游戏 AI(《杀戮尖塔》)较前代 Opus 4.8 提升 3 倍
- 已正式纳入 Max 和 Team Premium 订阅套餐
如何选择?四大场景选型指南
场景 1:AI Agent 编程开发(追求最高正确率)
→ Claude Fable 5(SWE-bench Pro 80.3%,长上下文无溢价)或 GPT-5.6 Sol(成本约 Fable 5 的 1/3,Coding Agent 超越 Fable 5)
场景 2:前端开发 / 代码生成(需要全球最强前端能力)
→ Kimi K3(Arena 全球第一,且即将完整开源,可私有化部署)
场景 3:多模态 Agent / 计算机使用(桌面/浏览器自动化)
→ Gemini 3.6 Flash(Computer Use 内置,OSWorld-Verified 83%,成本远低于 Fable 5)
场景 4:高并发、成本敏感型应用(分类、摘要、简单问答)
→ Gemini 3.5 Flash-Lite($0.30/$2.50,350 tok/s)或 GPT-5.6 Luna($1/$6)
混合调用架构:按任务路由降低总成本
大部分企业应用不需要"全程用最贵模型"。参考以下路由策略:
PYTHON
def route_to_model(task_type: str, complexity: str) -> str:
    """
    根据任务类型和复杂度路由到最合适的模型
    """
    routing = {
        # 高精度编程任务
        ("code", "complex"):    "claude-fable-5",
        ("code", "standard"):   "gpt-5.6-sol",
        # 前端/UI 开发
        ("frontend", "any"):    "kimi-k3",
        # 多模态/计算机使用
        ("computer_use", "any"): "gemini-3.6-flash",
        # 文档处理、摘要(高吞吐)
        ("summarization", "any"): "gemini-3.5-flash-lite",
        # 轻量问答
        ("qa", "simple"):       "gpt-5.6-luna",
    }
    return routing.get((task_type, complexity), "gpt-5.6-terra")  # 默认均衡档

# 示例用法
model = route_to_model("code", "complex")  # → "claude-fable-5"
model = route_to_model("summarization", "any")  # → "gemini-3.5-flash-lite"
显示更多
国内开发者可通过七牛云 AI 大模型广场统一接入以上模型,支持标准 OpenAI SDK 格式,国内可直接访问,无需为每家厂商分别申请 API Key。
开源 vs 闭源:Kimi K3 的战略意义
Kimi K3 是本轮发布中唯一的开源模型(权重将于 7 月 27 日前公开),这带来闭源模型无法提供的优势:
| 维度 | Kimi K3(开源) | 其他三款(闭源) |
|---|---|---|
| 私有化部署 | ✅ 本地运行,数据不出境 | ❌ 依赖云端 API |
| 自定义微调 | ✅ 可在专有数据上微调 | ❌ 禁止或受限 |
| 成本上限 | 一次性硬件成本 | 按 token 持续计费 |
| 审计透明度 | 权重可检查 | 黑盒 |
| 依赖风险 | 无厂商锁定 | 受 API 政策变动影响 |
适合考虑 Kimi K3 开源版的场景:金融、医疗、政府等对数据合规要求严格的行业;以及有高并发推理需求、希望控制长期成本的企业。
FAQ:选型常见问题
Q1:GPT-5.6 Sol 真的比 Claude Fable 5 更强了吗?A:在 Agents' Last Exam 上 GPT-5.6 Sol 高出 13.1 分,Coding Agent 效率也更高;但 Fable 5 在 SWE-bench Pro(80.3%)和 GDPval-AA(1932 分)上仍有优势。两者差距取决于具体任务类型,不能一概而论。
Q2:Kimi K3 的 2.8T 参数是全部同时运行吗?A:不是。K3 采用 MoE(混合专家)架构,共 896 个专家模块,每次推理仅激活 16 个,实际计算量远小于 2.8T 全参数规模,推理效率有保障。
Q3:Gemini 3.6 Flash 和 Fable 5 价格差多少?A:输入端 Gemini 3.6 Flash($1.50)约为 Fable 5($10)的 1/7;输出端($7.50 vs $50)约为 1/6.7。结合 token 效率提升,综合成本差距更大。
Q4:Kimi K3 何时可以本地部署?A:月之暗面官方承诺完整权重将于 2026 年 7 月 27 日前开源发布,届时可在本地 GPU 集群部署。
Q5:企业应用该如何在这四款模型间分配预算?A:推荐分层策略——高价值复杂任务(代码审查、法律文档、科研分析)用 Fable 5 或 GPT-5.6 Sol;日常编程辅助用 Gemini 3.6 Flash 或 Kimi K3;大量简单任务(分类、摘要、翻译)用 Gemini 3.5 Flash-Lite 或 GPT-5.6 Luna,整体可节省 60-80% API 成本。
小结
2026 年 7 月的模型格局标志着 AI 竞争从"谁最聪明"转向"谁最划算":GPT-5.6 Sol 以 Fable 5 三分之一的成本超越其 Coding Agent 指标;Gemini 3.6 Flash 在保持主力性能的同时削减 17-65% token 消耗;Kimi K3 用开源策略将前沿能力带入私有化部署;Claude Fable 5 则以最高精度守住企业长任务场景的阵地。没有一款"放之四海皆准"的模型,最优策略是根据任务类型动态路由。信息来源:各官方发布博客及第三方基准平台(benchlm.ai、llmcosthub.com、智源社区),数据截至 2026 年 7 月 22 日,模型能力随版本更新持续变化。
参考资料
- GPT-5.6 官方发布页 — OpenAI,2026-07-10
- Gemini 3.6 Flash 官方博客 — Google DeepMind,2026-07-21
- Claude Fable 5 发布说明 — Anthropic,2026-06-10
- 七牛云 AI 大模型广场 - 多模型统一接入
- Token Plan:https://www.qiniu.com/ai/plan