突破逻辑天花板:Claude4与GPT-5.5推理能力深度解析及选型指南
面对复杂的业务逻辑和海量代码重构,开发者常常发现常规大模型容易在多步推演中“断片”。这就引出了行业内备受瞩目的焦点:Claude 4与GPT-5.5推理能力深度解析。这不仅是参数规模的较量,更是底层架构对复杂任务拆解能力的硬核碰撞。为了真正把控业务质量,进行大模型推理能力深度解析已经成为技术团队的核心必修课。
如何评估Claude 4与GPT-5.5的逻辑推理性能?
要精准衡量这两款顶尖模型的真实水准,传统的常识问答已经捉襟见肘,必须引入严苛的AI模型逻辑推理性能基准测试。Claude 4 在测试中展现出了极强的链式思考(Chain of Thought)稳定性,特别是在处理长链条的数学证明和法律条文交叉比对时,其逻辑连贯性极少出现跳跃。而 GPT-5.5 则在非线性推理和动态纠错方面表现抢眼,能够在推演中途发现前提假设的错误并自行修正。
为了直观感受这种差异,开发者往往需要进行实战演练。这种直观的结果比对,能极大缩短技术选型的周期。
大语言模型长上下文处理能力在编程中的应用方案
在实际的研发流中,推理能力往往与上下文窗口深度绑定。探讨大语言模型长上下文处理能力在编程中的应用方案时,Claude 4凭借其超大容量的上下文窗口,能够一次性吞吐整个中型项目的代码库,在寻找跨文件变量污染或深层回调Bug时犹如拥有“上帝视角”。GPT-5.5则通过优化的注意力机制,在提取核心逻辑片段时展现出极高的信噪比过滤能力。
要将这种强大的编程辅助能力无缝接入现有工作流,选择合适的平台至关重要。
企业如何选择高性价比AI模型推理解决方案?
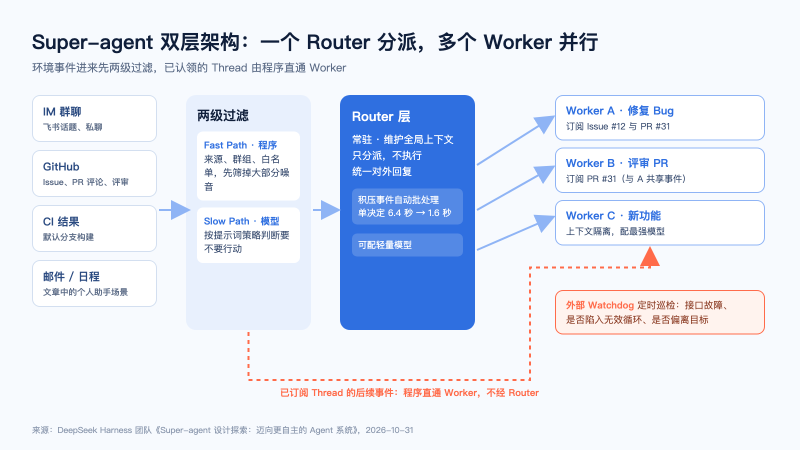
技术再强,最终也要回归商业本质。面对动辄上亿 Token 的消耗,企业如何选择高性价比AI模型推理解决方案?盲目追求最强模型往往会导致算力成本溢出。合理的策略是采用路由机制:将高难度的核心算法推演交给 Claude 4 或 GPT-5.5,而将基础的日志分析和日常问答分流给轻量级模型。
多模型方案应分别按各模型提供商的官方文档配置接口、凭证与配额。七牛云 AI 推理服务文档可用于了解 DeepSeek、Qwen、Kimi 等国产模型的接入与 Token 计费;Claude 和 GPT 的接口与计费应分别遵循 Anthropic 和 OpenAI 官方说明。并发控制和缓存策略需要通过实际任务验证。
精准匹配业务场景与模型特性,才是技术落地的终极法则。剥离对单一巨头模型的盲目崇拜,构建灵活、可插拔的多模型推理架构,将为企业在激烈的智能化竞速中构筑起坚实的底层护城河。