破局AI代码助手数据安全危机:从Meta封禁Claude看企业架构防线
当开发者习惯于让大模型补全数百行核心业务逻辑时,安全团队的警报却在后台疯狂作响。近期,Meta限制在内部核心代码库直接使用部分外部生成式大模型,彻底引爆了业界对AI代码助手数据安全危机的担忧。这并非针对单一产品的抵制,而是科技巨头在面对核心资产可能外泄时采取的断腕之举。Meta封禁Claude等外部模型的核心逻辑在于,公共云端模型在处理海量私有代码时,极易产生不受控的记忆效应,甚至被用于下一代模型的隐性训练。企业亟需一套既能保障研发效率,又能守住代码底线的全新架构防线。
核心资产保卫战:企业如何防范AI大模型代码泄露
开发者将包含数据库凭证、核心算法的片段粘贴到公共AI对话框的那一刻,风险便已产生。为了阻断这种无意识的资产流失,企业必须从架构底层重新设计数据流向。面对复杂的合规要求,实施AI代码助手私有化部署架构方案成为大中型研发团队的首选。
这种架构通过在内网建立独立的代码推理节点,确保所有补全请求和上下文分析均在企业防火墙内闭环流转。同时,针对外部模型的调用,建立严格的网关拦截机制,是实现企业级AI模型知识蒸馏防范的关键步骤。通过清洗掉Prompt中的敏感变量与私有API定义,企业可以在享受大模型提效的同时,切断代码被逆向还原的路径。
统一接入与权限管控:重塑大模型调用边界
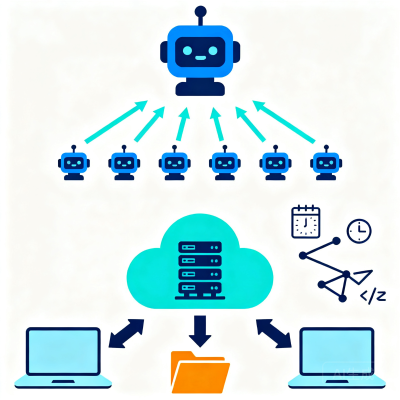
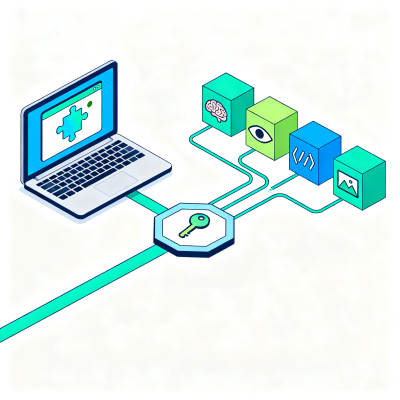
单一的封堵策略往往会引发开发者的反弹,建立合规的替代通道才是长久之计。研发团队需要一个能够平滑对接多种大模型,同时具备细粒度审计能力的网关。通过部署统一的API分发层,安全团队可以实时监控每一个Token的流向,并对高风险请求进行动态熔断。
对于希望快速建立这种合规通道的团队,采用成熟的网关服务能够大幅降低研发成本。例如,借助企业级AI模型统一安全接入能力,开发者不仅能获得兼容主流标准的高效入口,还能在不改变原有开发习惯的前提下,实现所有AI推理请求的集中审计与密钥隔离,彻底杜绝开发者私自使用个人账号带来的影子IT风险。
夯实数据底座:七牛云存储保障AI训练数据合规教程
在构建企业专属的辅助编程模型或RAG知识库时,底层数据的存储安全直接决定了上层AI应用的安全水位。海量的历史代码、架构文档和内部讨论记录,需要一个既能支撑高吞吐训练,又能提供严格权限隔离的存储基座。在这一环节,选择具备完善加密和审计机制的对象存储至关重要。
通过查阅相关的七牛云存储保障AI训练数据合规教程可以发现,构建多版本的非结构化数据管理体系是防止训练数据被恶意篡改的核心。依托七牛云对象存储AI训练数据安全方案,企业能够为海量代码语料配置细粒度的生命周期管理和访问控制策略,确保中心到边缘的每一次数据读取都符合严格的合规审计要求。
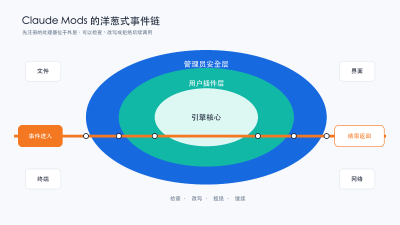
代码是科技企业的生命线,而AI赋能则是不可逆转的效率革命。面对大模型带来的数据边界模糊问题,一刀切的禁用只会让安全风险转入地下。构建从存储基座到统一安全网关,再到端侧插件的纵深防御体系,才是破局之道。企业应当立足于自身的数据资产级别,在物理隔离与云端协同之间找到平衡点,让AI真正成为安全可控的生产力引擎。