DeepSeek对比Qwen:国产大模型本地推理选型完整指南
在企业级数据隐私要求日益严格的当下,将大语言模型私有化部署到本地服务器已成为众多业务场景的刚需。面对市面上琳琅满目的开源模型,DeepSeek对比Qwen:国产大模型本地推理选型完整指南是每位架构师必须攻克的课题。这两款模型代表了当前国产开源生态的顶尖水平,但在底层架构、显存占用及并发处理上存在显著差异。本文将从实战角度拆解两者的技术特性,为你提供一份避坑指南。
架构差异决定算力分配策略
要理解DeepSeek与Qwen大模型推理效率深度对比,核心在于看透两者的架构路线。Qwen系列(如Qwen1.5/2.0)主打Dense(稠密)架构,其优势在于全尺寸覆盖极广,从0.5B到72B应有尽有。对于中小企业而言,如果只有单张RTX 4090或A800,部署Qwen-14B/32B量化版是极为稳妥的选择,其推理输出的延迟非常稳定。
相比之下,DeepSeek-V2/V3则在MoE(混合专家)架构上大放异彩。MoE的特点是参数量极大,但每次推理只激活部分专家网络。在查阅企业级MoE大模型本地部署教程时你会发现,虽然DeepSeek激活参数少、推理速度快,但它的总参数量需要极大的显存来加载模型权重。如果你的硬件集群拥有多张80G显存的GPU,DeepSeek能提供远超同等激活参数模型的逻辑推理能力。
算力优化与私有化部署方案
在进行Qwen与DeepSeek私有化部署方案对比时,成本控制是绕不开的话题。如何降低DeepSeek本地推理算力成本?最有效的手段是采用AWQ或GPTQ等低位宽量化技术,结合vLLM推理框架的PagedAttention机制,可以显著降低KV Cache的显存占用,从而在有限的显存下跑通更大规模的模型。
对于尚未决定采购何种硬件的团队,建议在实施企业级AI大模型私有化部署与算力优化方案前,先进行云端验证。你可以利用七牛云提供的模型对比服务,一键调取多款主流模型进行同步对话与性能实测。通过直观的业务数据跑分,能更精准地测算出本地部署所需的真实算力水位,避免盲目采购导致的资源浪费。
长文本与高并发场景的破局点
当业务涉及文档分析、代码审查等场景时,长上下文大模型推理并发优化策略显得尤为关键。Qwen在长文本处理上表现出了极强的鲁棒性,特别是其针对RoPE(旋转位置编码)的优化,使得在32k甚至128k上下文时依然能保持较高的信息检索召回率。而DeepSeek则通过其特有的Yarn机制优化长文本,在代码和数学逻辑的长链条推理上具有极高的性价比。
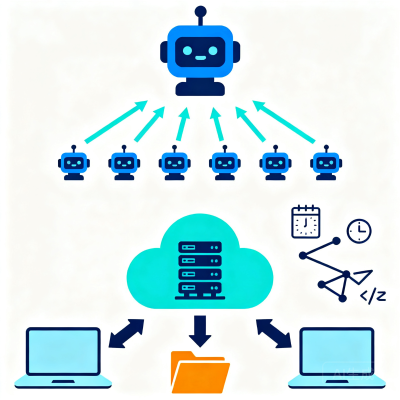
在实际的高并发生产环境中,纯本地算力往往难以应对突发的流量洪峰。此时,采用本地加云端的混合架构是最佳实践。开发者可以参考AI大模型推理服务的接入指南,将常规请求留在本地处理,而在算力瓶颈时将非涉密的长文本请求路由至云端API。这种策略不仅保障了核心数据的绝对安全,又兼顾了系统的弹性扩展能力。
无论是选择Qwen的稳扎稳打,还是拥抱DeepSeek的极致性价比,最终的选型都必须回归到具体的业务场景与硬件预算。建议团队先用量化小模型跑通业务闭环,再逐步向大规模集群扩展,用最小的试错成本找到最契合的AI基座。