
这篇能帮你做什么
本指南面向开发人员,旨在厘清面向终端用户的 ChatGPT 网页/应用产品与面向开发者的 OpenAI API 之间的定位差异。通过本篇内容,你将掌握在服务端规范集成 OpenAI Responses API 发起文本生成请求的标准流程,正确提取模型生成的结构化内容,并掌握 401 鉴权失效与 429 配额或限流错误的排查与处理方式。
准备工作
在服务端接入前,先确认以下事项:
- 单独设置 API 计费:ChatGPT 与 API 平台分别计费。ChatGPT 订阅不包含 API 用量;请在 API 平台核对组织的计费设置与可用额度。预付费账户余额不足时,需要补充积分;不能把所有账户的计费方式都写成必须预付。
- 配置服务端密钥:在开发者平台取得 API Key,通过
OPENAI_API_KEY等服务端环境变量提供给程序,不把密钥写入网页或提交到代码仓库。 - 准备调用环境:下文使用官方 OpenAI Node.js SDK。先安装 SDK,并将
OPENAI_MODEL设置为本账户可用、支持 Responses API 的模型 ID。原生 HTTP 请求通过Authorization: Bearer $OPENAI_API_KEY鉴权。
操作步骤
依据官方文本生成文档,使用 Responses API 发起文本生成请求。先确认输入内容和账户可用的模型 ID,再选择 SDK 或原生 HTTP 调用。
以下 Node.js 示例保存为 .mjs 文件,在已安装官方 SDK、设置 OPENAI_API_KEY 和 OPENAI_MODEL 后运行:
import OpenAI from 'openai';

const model = process.env.OPENAI_MODEL;
if (!model) throw new Error('请设置 OPENAI_MODEL');

const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

async function generateText() {
  return client.responses.create({
    model,
    input: '请说明如何进行服务端接口集成。',
  });
}

const response = await generateText();
console.log(response.output_text);
原生 HTTP 方式使用同一端点。先将 YOUR_AVAILABLE_MODEL 替换为本账户可用的模型 ID;它是占位符:
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "YOUR_AVAILABLE_MODEL",
    "input": "请说明如何进行服务端接口集成。"
  }'
验证结果
沿用上一节调用返回的 response。使用官方 Node.js SDK 时,response.output_text 可聚合文本输出。
需要检查原生结构时,遍历 output 内的消息和内容块;不要假定文本固定在第一个数组元素中。
// response 来自上一节的 await generateText()
console.log(response.output_text);

const texts = [];
for (const item of response.output ?? []) {
  if (item.type !== 'message') continue;
  for (const block of item.content ?? []) {
    if (block.type === 'output_text') texts.push(block.text);
  }
}
console.log(texts.join('\n'));
常见误区
以下判断依据计费说明与错误码文档:
- 把 ChatGPT 订阅当成 API 额度:两者分别计费,应在 API 组织的计费设置中核对,不能依据 ChatGPT 订阅状态判断 API 是否可用。
- 把所有 429 都当成充值问题:先检查
error.code。credit_balance_exhausted表示预付积分耗尽;支出上限和用量上限则需处理各自的限制,不能统一写成充值即可恢复。重试不会修复这些账户限制。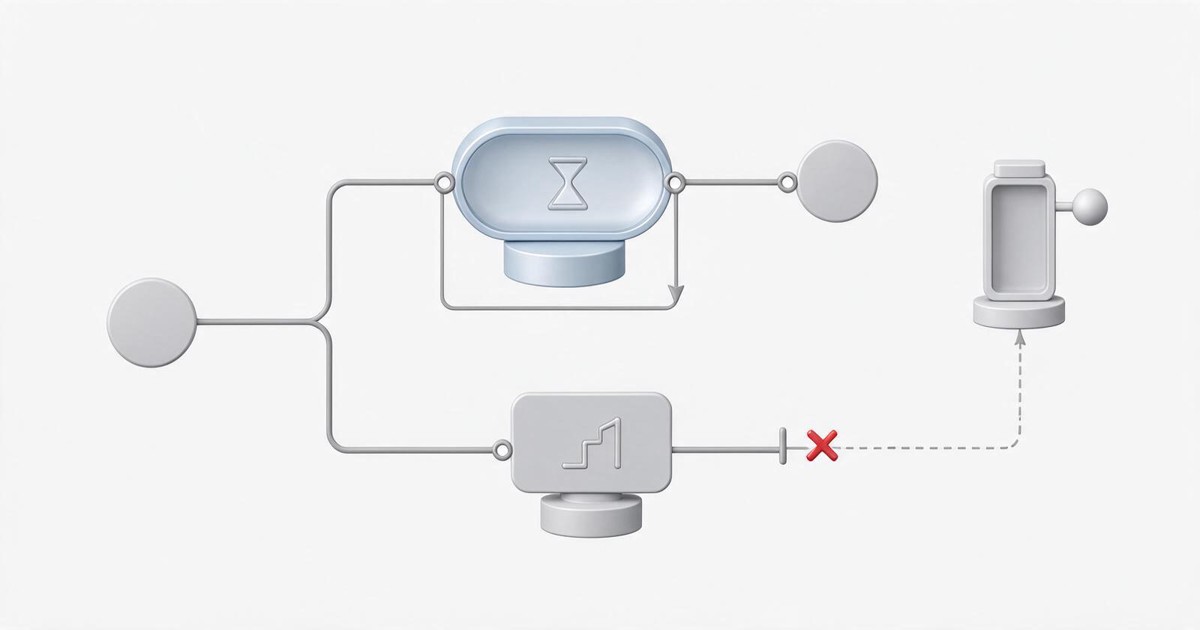
速率超限与配额耗尽处理逻辑分流示意 - 把限速与额度耗尽混为一谈:速率限制应降低请求速率;存在
Retry-After时,至少等待其指定时间再尝试。缺少该标头时采用带随机抖动的退避,并限制重试次数。
常见问题
调用 API 遇到 401 Invalid Authentication 报错时,如何核对密钥与组织设置?
当收到 HTTP 401 状态码且提示 Invalid Authentication 时,官方文档指出的原因为 API Key 无效或请求组织错误。排查时应核对环境变量中的 API Key 是否复制完整、是否已被撤销,并检查多组织账户中是否正确指定了关联的组织标识。
接口返回 429 credit_balance_exhausted 时,具体的解决步骤与充值流程是什么?
当接口返回 HTTP 429 且错误代码为 credit_balance_exhausted 时,表明该组织的预付费积分已经用尽。解决此问题无法依赖代码重试,须由具备权限的管理员登录 OpenAI 控制台的计费管理页面(settings/organization/billing),充值相应的预付积分后方可恢复接口调用。
当 API 返回 429 速率限制错误时,如何解析并依据 Retry-After 标头执行退避等待?
当接口因请求发送过快返回 HTTP 429(Rate limit reached for requests)时,需要主动放缓请求节奏。若响应标头中附带了 Retry-After 字段,服务端程序应严格按照该标头指定的等待时间(秒数或具体时间戳)进行休眠等待,之后再发起重试。
参考资料
(3 条)
- https://developers.openai.com/api/docs/guides/error-codesdevelopers.openai.com · 查阅于 2026-10-21
- https://help.openai.com/en/articles/9039756-managing-billing-for-chatgpt-and-the-api-platformhelp.openai.com · 查阅于 2026-10-22
- https://developers.openai.com/api/docs/guides/text.mddevelopers.openai.com · 查阅于 2026-10-21
本文由 AI 辅助生成,经编辑审核后发布。
本文相关产品
AI Large Model Inference七牛云 AI 大模型平台,提供大模型推理 API 与模型广场查看产品Qiniu AI Agent面向开发者与企业的智能体开发与编排能力查看产品