目录
发布日期:2026-11-19 | 信息截至:2026-11-19
腾讯混元于 2026 年 11 月 16 日正式发布 Hy4 flash,11 月 18 日同步开源三个版本(Hy4 flash、Hy4 flash-FP8、Hy4 flash Base),可从 GitHub、Hugging Face、ModelScope、GitCode 四个平台获取权重。腾讯官方披露,Hy4 flash 上线首日 Token 调用量已突破 50 万亿,创混元系列首日调用历史新高;同日,OpenRouter LLM 日榜数据显示 Hy4 flash 登顶首位,成为当天被全球开发者调用最多的模型。模型总参数量 224B(其中 Engram N-gram 嵌入表 64B),每个 Token 仅激活约 12B 参数,支持文本和图像输入、100 万 Token 上下文;内置 DFly2 投机解码草稿模型(0.85B),结合 4bit 量化和 megakernel 加速,解码速度可超 150 tps。内部盲测中,单任务成本 0.26 元、端到端完成时间中位数 6.7 分钟,用户满意度接近同期对比的国际主流轻量级模型。本文梳理模型核心架构差异、官方基准数据,并给出 Transformers 本地推理和 vLLM/SGLang 生产部署的完整操作步骤。
Hy4 flash 是什么:旗舰 Hy4 的轻量版,不是简单缩参
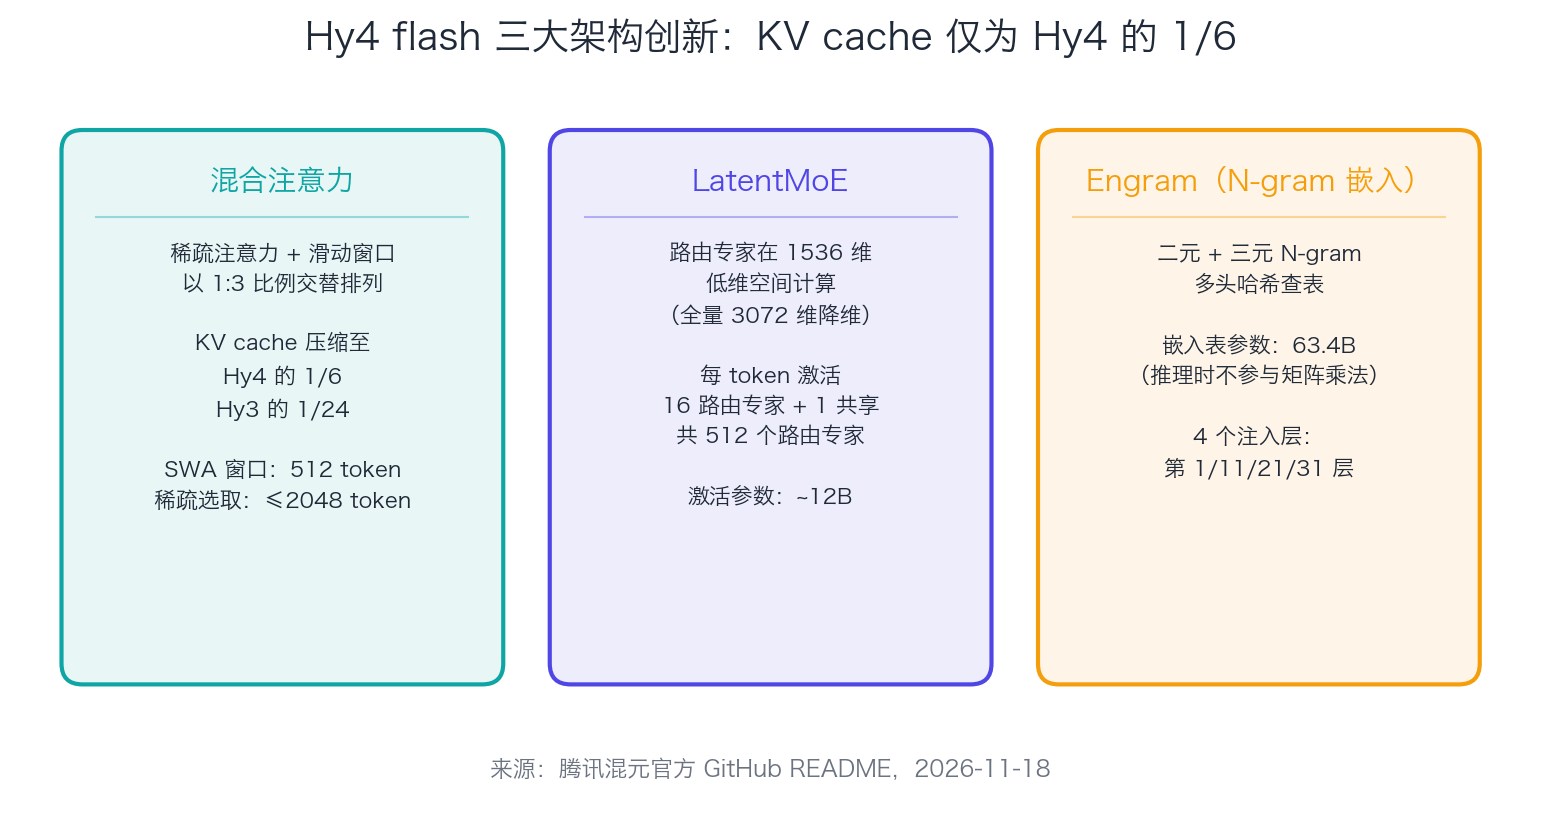
Hy4 flash 的定位是多模态推理模型,架构层面有三个在 Hy4 基础上的新变化,而非单纯缩减参数规模。(来源:腾讯混元官方 GitHub README,2026-11-18)
三处主要变化:
1. 混合注意力(Hybrid Attention):用滑动窗口注意力(SWA,512 token 窗口)捕捉相邻 token 关系,用 IndexPool 稀疏注意力(最多 2048 个 token)从更长上下文中挑选相关片段。两者以 1:3 的比例交替,KV cache 因此压缩至 Hy4 的 1/6、Hy3 的 1/24,是降低显存和推理成本的核心机制。
2. LatentMoE:路由专家在 1536 维的低维潜空间里计算,而不是在 3072 维的全量空间。每个 token 从 512 个路由专家中激活 16 个,加 1 个共享专家,激活参数总量约 11.3B(文本)+ 0.43B(视觉)。
3. Engram(N-gram 嵌入):用多头哈希表存储二元和三元 N-gram 的学习表示,根据最近两三个 token 的组合查表取出片段表示融入当前隐藏状态。这部分嵌入表参数量达 63.4B,是模型总参数大的主要原因,但推理时不参与矩阵计算,对激活参数量影响极小。
三个变化加在一起的效果:在 WorkIndex 内部评测集(覆盖 PPT 制作、文档编辑、音视频处理、表格修复等 8 类办公任务)上,Hy4 flash 以 42.1 分略高于 Hy4 preview 的 39.7 分,同时单任务成本仅为 Hy4 preview 的 1/13、Hy4 的 1/20。
基准数据:登顶 OpenRouter 背后的真实数字
OpenRouter 日榜登顶反映的是开发者的实际选择,而不仅是跑分表现;以下数据来源于腾讯官方披露和独立评测集,非单一榜单。
用户盲测(259 个任务 × 85 位 WorkBuddy 内部用户,27 类任务):
- 用户满意度:2.79/4
- 端到端任务完成时间中位数:6.7 分钟
- 单任务成本:0.26 元
- 来源:腾讯混元官方 GitHub,2026-11-18
WorkIndex 内部评测(8 类办公生产力任务):
- Hy4 flash:42.1 分
- Hy4 preview:39.7 分
- Hy4:51.4 分(上限参照)
公开基准(few-shot,预训练 Base 模型口径)中有代表性的几项:
- MMLU(5-shot):88.7(Hy4 Base 91.6,DeepSeek-V4-Pro-Base 91.1)
- MMLU-Pro(5-shot):71.1(Hy4 Base 73.9)
- C-Eval(5-shot):92.0(Hy4 Base 95.0)
- U-MATH(5-shot):69.8(Hy4 Base 71.6)
有一点需要明确: 上面这些分数是 Base 模型的 few-shot 评测,不是指令微调后的模型分数。腾讯在 README 中也特别说明,因为基座模型接触了大量合成指令数据,few-shot 评测中偶尔不能按格式作答,分数可能有所失真。日常使用的是指令微调版(Hy4 flash),效果对齐的参照是 WorkIndex 和盲测数据。
推理强度: Hy4 flash 支持两种模式——reasoning_effort: "high"(默认,思考启用)和 reasoning_effort: "no_think"(直接输出,不产生推理链 Token,适合低延迟场景)。
快速开始:本地 Transformers 推理
Hy4 flash 对 Transformers 的支持尚未合并主分支,需从指定 PR 安装。
第一步:安装依赖
pip install "transformers[torch,vision] @ git+https://github.com/huggingface/transformers.git@refs/pull/50903/head"
第二步:文本推理示例(no_think 模式,低延迟)
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "tencent/Hy4-flash"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForImageTextToText.from_pretrained(model_id, device_map="auto")

messages = [
    {
        "role": "user",
        "content": [{"type": "text", "text": "用一句话介绍量子纠缠。"}],
    }
]

inputs = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="no_think",   # 关闭思考链,降延迟
).to(model.device)

outputs = model.generate(**inputs, max_new_tokens=256)
print(processor.decode(outputs[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True))
推荐采样参数:temperature=0.9,top_p=1.0。若需要思考链,把 reasoning_effort 改为 "high"(默认值)。
图文混合推理(传入图片 URL):
messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "url": "https://example.com/chart.png",
            },
            {"type": "text", "text": "这张图表反映了什么趋势?"},
        ],
    }
]
生产部署:vLLM 和 SGLang 两条路线
生产环境推荐 vLLM 或 SGLang,两者均已集成 DFly2 投机解码和 FlashMLA 稀疏注意力支持,均使用官方预构建镜像。 FP8 量化版(Hy4-flash-FP8)显存占用更低,适合 8 卡 A100/H100 服务器;本地测试用 GGUF 版(AngelSlim/Hy4-flash-GGUF)。
vLLM 部署
docker run --gpus all \
  -p 8000:8000 \
  --ipc=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \
    --tensor-parallel-size 8 \
    --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \
    --attention-backend FLASHMLA_SPARSE \
    --tool-call-parser hy_v4 \
    --reasoning-parser hy_v4 \
    --enable-auto-tool-choice \
    --port 8000 \
    --served-model-name hy4-flash
关键参数说明:
--speculative-config '{"method":"dfly"}':启用 DFly2 投机解码(内置草稿模型,无额外显存)--attention-backend FLASHMLA_SPARSE:启用 FlashMLA 稀疏注意力核--tensor-parallel-size 8:8 卡张量并行,FP8 模型在 8 × A100 80GB 上可运行
SGLang 部署
docker pull lmsysorg/sglang:hy4-flash

docker run --gpus all \
  -p 8000:8000 \
  --ipc=host \
  lmsysorg/sglang:hy4-flash \
  sglang serve \
    --trust-remote-code \
    --model-path tencent/Hy4-flash-FP8 \
    --tp 8 \
    --cuda-graph-backend-prefill disabled \
    --speculative-algorithm DFLY \
    --speculative-dfly-block-size 6 \
    --host 127.0.0.1 \
    --port 8000
注意 --cuda-graph-backend-prefill disabled 是针对 DFly2 的必要参数,不加可能导致预填充阶段出错。
启动后调用(OpenAI 兼容接口)
服务启动后通过标准 OpenAI 接口调用:
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="hy4-flash",
    messages=[{"role": "user", "content": "帮我写一个 Python 冒泡排序。"}],
    temperature=0.9,
    top_p=1.0,
    extra_body={"chat_template_kwargs": {"reasoning_effort": "no_think"}},
)
print(response.choices[0].message.content)
如果需要在同一套业务系统里同时接入多个模型并统一管理调用量和计费,七牛云 Token Plan 支持用单个 API Key 对接多款主流大模型,兼容 OpenAI 接口,适合需要对比不同模型效果的团队。
三个部署场景的选型建议
场景一:本地测试或个人开发机用 GGUF 版(AngelSlim/Hy4-flash-GGUF)+ llama.cpp 或 Ollama,不需要多卡。显存要求取决于量化位宽,Q4_K_M 版本在约 32GB 统一内存的 Apple Silicon 上可运行。
**场景二:小批量 API 服务(单节点 8 卡 A100/H100)**用 FP8 版 + vLLM 或 SGLang 官方镜像。启用 DFly2 和 FlashMLA_SPARSE,实测解码速度可超 150 tps。
**场景三:大规模生产集群(多节点)**参考 vLLM Recipe(recipes.vllm.ai/tencent/Hy4-flash)或 SGLang Cookbook(docs.sglang.io/cookbook/autoregressive/Tencent/Hy4-flash),两份官方文档有多节点配置细节和 PD 分离(Prefill-Decode 分离)部分。DFly2 的 KV Share 和 Index Share 机制在 PD 分离部署下只需传输最后一层 hidden state,对网络带宽压力较小。
常见问题
**Q:Tencent Hy License 是开源协议吗,能商用吗?**Tencent Hy License 是腾讯自定义协议,不是 Apache/MIT/GPL 等标准开源协议。商业使用条款以 GitHub 仓库 LICENSE 文件为准(来源:github.com/Tencent-Hunyuan/Hy4-flash/blob/main/LICENSE),使用前需自行核对是否符合你的业务场景。
**Q:Hy4 flash 和 Hy4 分别适合什么任务?**官方建议:深度搜索、文档处理、PPT 制作、简单前端展示、computer use 等日常高频任务用 Hy4 flash;长程软件工程等复杂任务用智能上限更高的 Hy4。从内部数据看,Hy4 flash 的 WorkIndex 42.1 分略高于 Hy4 preview 的 39.7 分,说明在日常任务上 flash 版经过了专项强化。
**Q:no_think 和 high 推理模式怎么选?**对延迟敏感的场景(聊天助手、实时补全)用 reasoning_effort: "no_think",不产生推理链 Token,响应更快;对精度要求高的场景(复杂分析、多步推理)用 "high"(默认),模型先思考再输出。两种模式在同一个模型权重上切换,不需要换模型。
结论
Hy4 flash 在同一天登顶 OpenRouter LLM 日榜、首日调用量突破 50 万亿,背后是架构层面三个务实的降本设计:KV cache 压缩到 Hy4 的 1/6、LatentMoE 低维专家计算、Engram N-gram 表增强知识密度,共同把单任务成本压到 0.26 元。从部署角度,官方已提供 vLLM 和 SGLang 预构建镜像,核心命令就是本文第三节的两段 docker run;本地测试用 GGUF 版更简单。许可证使用 Tencent Hy License 而非标准开源协议,商用前需核对条款。本文数据基于 2026 年 11 月 19 日腾讯混元官方披露及 GitHub README,框架版本和镜像 tag 可能随迭代更新。
延伸阅读
- Hy4 flash GitHub:github.com/Tencent-Hunyuan/Hy4-flash
- Hy4 flash HuggingFace:huggingface.co/tencent/Hy4-flash
- Hy4 flash-FP8:huggingface.co/tencent/Hy4-flash-FP8
- GGUF 量化版:huggingface.co/AngelSlim/Hy4-flash-GGUF
- vLLM 部署手册:recipes.vllm.ai/tencent/Hy4-flash
- SGLang 部署手册:docs.sglang.io/cookbook/autoregressive/Tencent/Hy4-flash
- DFly2 投机解码框架:github.com/Tencent/AngelSpec
- 量化工具 AngelSlim:github.com/tencent/AngelSlim
- 七牛云大模型广场(含混元):https://www.qiniu.com/ai