目录
发布日期:2026-11-20 | 信息截至:2026-11-20
同一份月度调用量,全用 Kimi K3 旗舰按量付费是 99,840 元;换成合适的模型档位 + 命中缓存 + 错峰调用 + 七牛云 Token Plan 4,999 元订阅,落地月支出 4,999 元,降至起点的 5%。这不是理论极限,是 2026 年 11 月国内各平台公开定价下可操作的真实路径。省钱的逻辑很简单:大模型 API 的成本不是由单价决定的,而是由"用了哪档模型 × 缓存命中率 × 是否错峰 × 买的是按量还是订阅"四个变量共同决定。每一层都有 2 至 10 倍的降幅空间,叠加起来就能让账单缩水 95%。本文以 ithome 2026 年 11 月实测数据为基础,拆解四个降本层次,给出模型选型对比、平台横评和七牛云 Token Plan 的适用判断。
先看结论:同等任务量,五步操作降至 5%
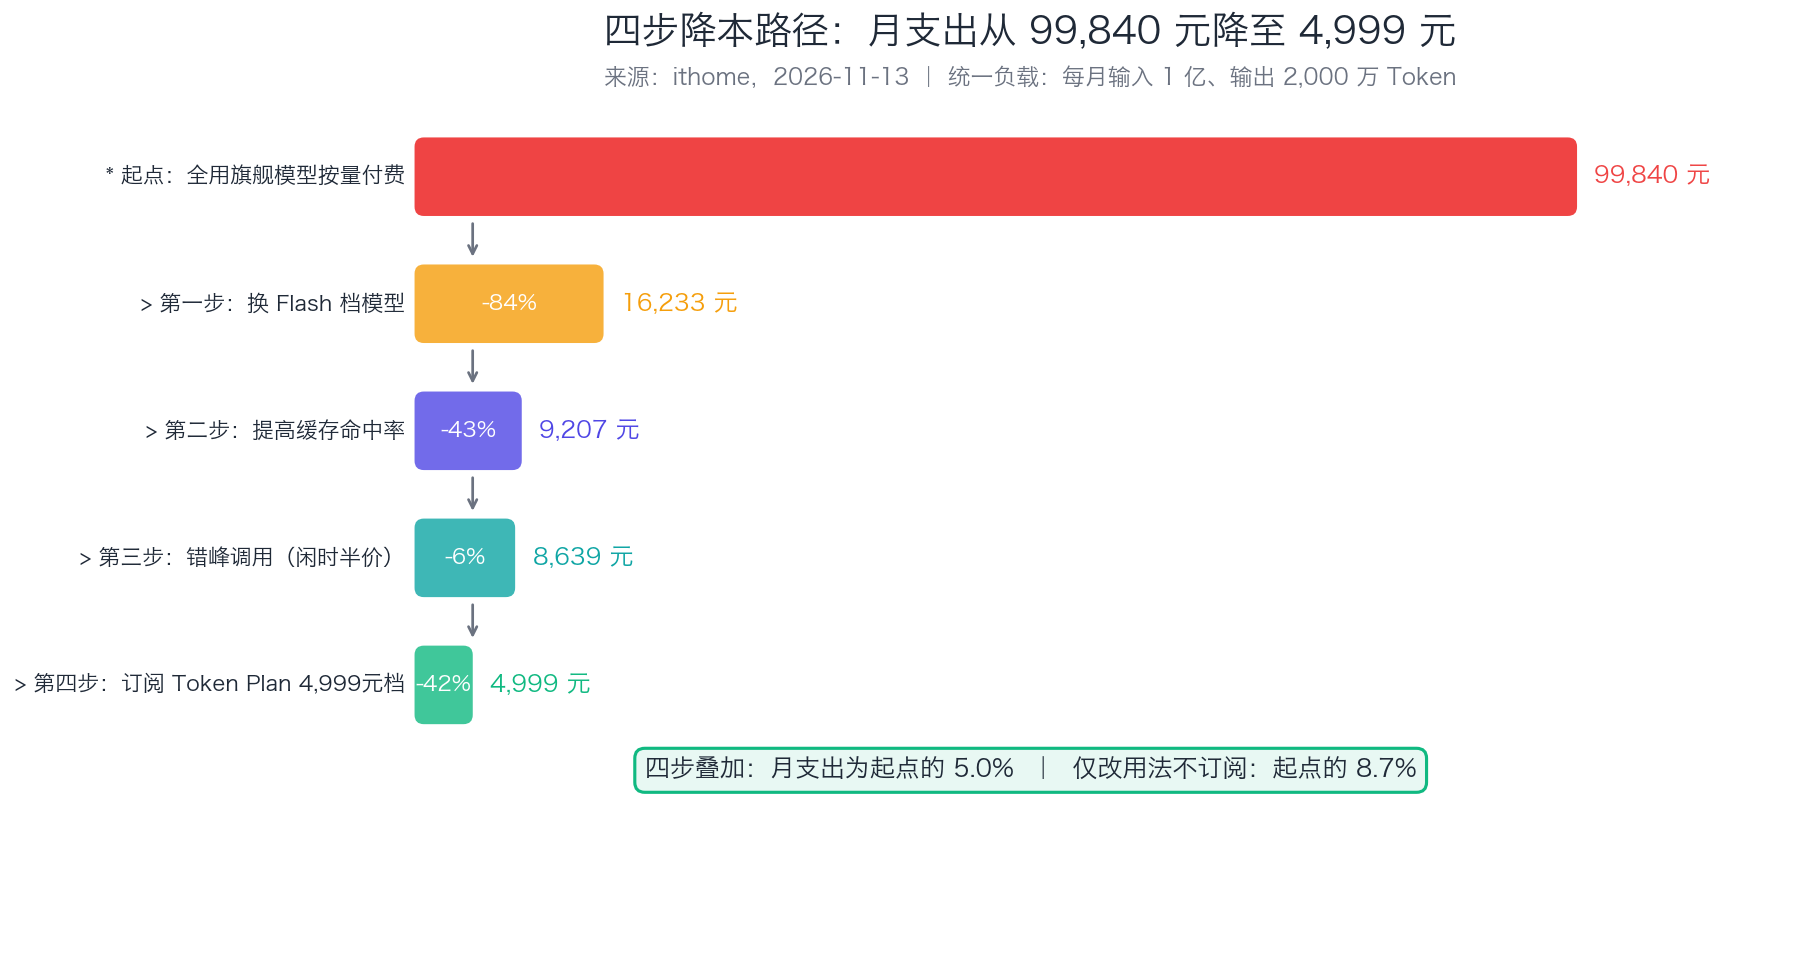
不改业务逻辑,只改"用什么模型、怎么买",月支出可以从 99,840 元降到 4,999 元。 以下数据来自 ithome 对国内七家平台的实测算例(2026-11-13),统一负载为每月输入 1 亿 Token、输出 2,000 万 Token。
| 步骤 | 操作 | 月支出 | 本步节省幅度 |
|---|---|---|---|
| 起点 | 全用 Kimi K3 旗舰,按量付费 | 99,840 元 | — |
| 第一步 | 换成合适档位模型(DeepSeek V4.1 Flash / GLM-5.3-Flash) | 16,233 元 | -84% |
| 第二步 | 提高缓存命中率(固定提示词前置) | 9,207 元 | -43% |
| 第三步 | 错峰调用(闲时价约为高峰的 50%) | 8,639 元 | -6% |
| 第四步 | 订阅七牛云 Token Plan 4,999 元档 | 4,999 元 | -42% |
四步叠加:月支出为起点的 5.0%。仅改用法不订阅:起点的 8.7%。
这组数字的前提是任务允许用 Flash 档模型处理(内容分类、摘要、格式转换等)。如果全是复杂推理任务,起点模型也换不了,降幅会收窄——但前三步的节省空间仍然成立。
第一层降本:模型选型,单价差 10 倍以上
成本浪费最大的来源是用旗舰模型处理不需要旗舰的任务。 2026 年国内主流大模型均有旗舰档和 Flash/Lite 档两个层次,同厂商内两档单价差 10 至 12.5 倍。(来源:ithome,2026-11-13)
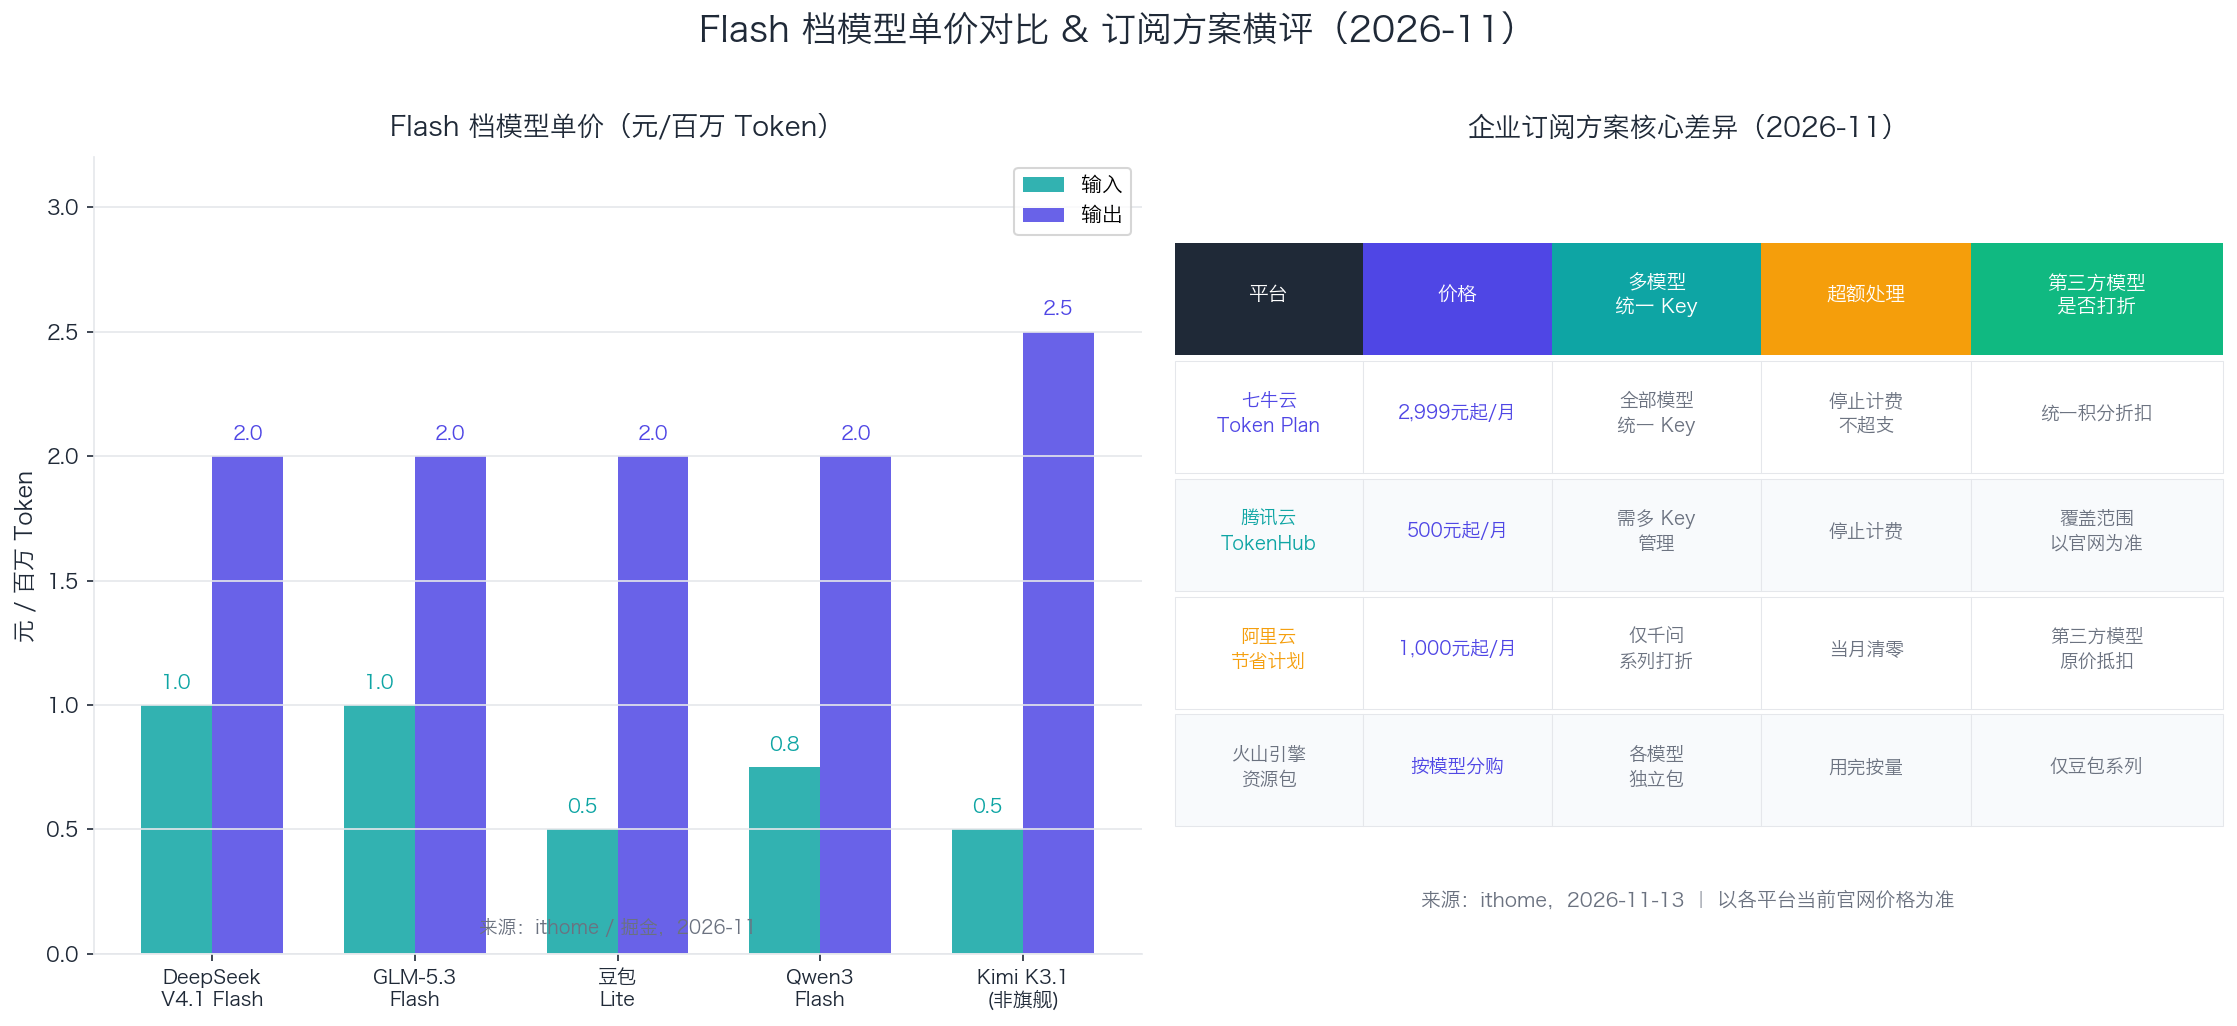
主流 Flash 档模型价格对比(2026-11)
| 模型 | 输入(元/百万 Token) | 输出(元/百万 Token) | 缓存命中输入 | 来源 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | 约 1 元 | 约 2 元 | 约 0.02 元(2%) | ithome,2026-11-13 |
| GLM-5.3-Flash | 约 1 元 | 约 2 元 | 约 0.02 元 | 掘金,2026-11-10 |
| 豆包 Lite | 约 0.5 元 | 约 2 元 | — | 网易,2026-11-18 |
| Qwen3-Flash | 约 0.5–1 元 | 约 2 元 | — | CSDN,2026-11-13 |
| Kimi K3.1(非旗舰档) | 约 0.5 元 | 约 2.5 元 | — | ithome,2026-11-13 |
注:各厂商定价随时调整,以各平台当前官网为准。同一模型在不同平台的刊例价基本一致,差异主要来自订阅折扣。
怎么选:分类、意图识别、摘要、格式转换 → Flash 档完全够用;复杂推理、多步代码生成、长文档深度分析 → 才需要旗舰档。先在自己的业务数据集上跑 Flash 档,对比旗舰档的输出质量,大多数日常任务在 Flash 档结果里挑不出明显差异。
第二层降本:缓存命中,输入成本直降 98%
如果你的系统提示词(角色设定、工具说明、背景知识)每次请求都原样重发,你在为重复的内容持续付费。 DeepSeek V4.1 Flash 的缓存命中输入价是未命中的 2%——同一段 10,000 Token 的系统提示词,命中缓存每次只花 0.02 元,不命中要花 1 元。每天 5,000 次调用,这一项每月差出约 1,500 元。
操作方式:把系统提示词放在请求最前面,每次调用内容完全一致(不要在系统提示词里插入动态内容,比如当前时间或用户名)。对话历史放在系统提示词之后追加。检查响应里的 cache_read_input_tokens 字段,不为零说明已命中。各平台均自动缓存,不需要额外配置,只需保证前缀稳定。
第三层降本:错峰调用,空闲时段约半价
主流平台对离线/非实时任务提供闲时折扣,空闲时段调用价格约为高峰时段的 50%。 文档批量处理、知识库向量化、离线数据标注等任务没有实时响应要求,把这类任务排到晚上或周末运行,不改一行业务代码,每月账单直接少一成以上。
各平台高峰时段定义不同:DeepSeek 开放平台、腾讯云 TokenHub、火山引擎方舟每周约 35 小时为高峰段;阿里云百炼每周约 98 小时为高峰段,相对更宽松。七牛云 Token Plan 的闲时(非 08:00–18:00)按 0.3 倍积分扣减,相当于同等用量成本只有高峰的三成。(来源:ithome,2026-11-13)
第四层降本:订阅套餐,月用量稳定后锁定折扣
按量付费没有任何折扣,订阅套餐是把稳定用量兑换成折扣的机制。 判断标准只有一个:月用量是否稳定,且大于订阅档的价值门槛。
七牛云 Token Plan——多模型混用的核心优势
七牛云 Token Plan 的设计逻辑是"单 Key 对接平台内全部模型,积分统一扣减":同一个 API Key 可以调用 DeepSeek、Qwen、GLM、豆包、Kimi、MiniMax、混元等十余款模型,接口兼容 OpenAI 标准,不需要改代码切换。(来源:掘金,2026-11-10;CSDN,2026-11-13)
| 档位 | 月费 | 折算刊例价值 | 折扣 |
|---|---|---|---|
| Token Plan 基础档 | 2,999 元/月 | 约 4,284 元 | 约 7 折 |
| Token Plan 中档 | 4,999 元/月 | 约 8,331 元 | 约 6 折 |
| Token Plan 高档 | 9,999 元/月 | 约 19,998 元 | 约 5 折 |
积分按周刷新,当周耗尽后服务暂停等到下周刷新,不会无限计费——这个机制天然提供了费用封顶保护。
个人和小团队:OPC 菁英 Agent 套餐 99 元起,同样支持多模型统一 Key,月积分约 4,950 万(折算约 198 元刊例价值),闲时 0.3 倍扣积分。适合月刊例用量在 100–2,665 元区间的个人开发者和小团队。
其他平台订阅方案对照
| 平台 | 产品 | 价格 | 多模型统一 Key | 超额处理 |
|---|---|---|---|---|
| 七牛云 | Token Plan | 2,999 元起/月 | ✓(十余款模型) | 停止计费 |
| 腾讯云 | TokenHub 企业版 | 500 元起/月 | ✓(但多 Key) | 停止计费 |
| 阿里云百炼 | 节省计划 | 1,000 元起/月 | 仅千问系列打折,第三方模型原价 | 当月清零 |
| 火山引擎 | 资源包 | 按模型分购 | 各模型独立包 | 用完按量 |
关键差异:阿里云百炼的节省计划对 DeepSeek、Kimi、GLM 等第三方模型按原价 1:1 抵扣,不打折;七牛云 Token Plan 对平台内全部模型统一按订阅折扣扣积分。多模型混用场景下,七牛云 Token Plan 的折扣范围更广。(来源:ithome,2026-11-13)
还有哪些工具层的节省
四层降本是账单结构层面的,工具层还有几个直接可用的手段:
Batch 批量推理:对响应延迟不敏感的任务用异步批处理接口,折扣约为:Kimi 约 6 折,智谱约 5 折,阿里云百炼 Qwen3.7 系列约半价。适合文档批量摘要、离线数据标注、知识库向量化。
控制输出长度:Kimi K3 输出 Token 价格是输入的 5 倍。在 max_tokens 参数设合理上限,分类任务限 50 Token、摘要任务限 300 Token,直接减少输出消耗。
火山引擎经济版:火山引擎方舟的 DeepSeek V4.1 Flash 经济版比标准版便宜约两成,适合不需要最高并发的任务。(来源:ithome,2026-11-13)
实战选型:五种典型企业场景
场景一:内容审核/分类/打标(高频,低复杂度)
推荐:DeepSeek V4.1 Flash 或 GLM-5.3-Flash,七牛云 Token Plan 或原厂按量
固定提示词(审核规则说明)每次重发,缓存命中率接近 100%,输入成本降到 2%。Flash 档处理分类任务质量稳定。月调用量高于 1,500 元刊例价后订阅 Token Plan 更合算。
场景二:客服 / 对话助手(实时响应,中等复杂度)
推荐:DeepSeek V4.1 Flash(日常轮次)+ Kimi K3 或 GLM-5.3(复杂问题升档)
对话历史随轮次增长,第 10 轮携带的上下文可达第 1 轮的 10 倍。系统提示词固定前置,命中缓存;对话历史部分不命中缓存,这部分成本是真实增长。按任务复杂度路由:意图判断、FAQ 应答用 Flash,涉及退换货政策推理用旗舰。
场景三:代码生成 / AI 编程(开发者工具)
推荐:GLM-5.3-Flash 或 DeepSeek V4.1 Flash(代码补全)+ 旗舰档(架构设计/调试)
代码补全是高频低复杂度任务,Flash 档可以覆盖 80% 以上场景。旗舰档留给架构级问题和复杂 bug 分析。工具调用(Function Calling)两档均支持。
场景四:批量文档处理(法律合同/财报分析)
推荐:Kimi K3 长上下文 Batch 接口,或 GLM-5.3 Batch
这类任务对延迟不敏感,启用 Batch 接口降价 40–50%,再叠加错峰调用,实际成本约为实时按量的 25–30%。
场景五:多模型 A/B 测试 / 评估
推荐:七牛云 Token Plan(统一 Key 切换模型,不改代码)
同一个 API Key 对接平台内十余款模型,调换模型只改 model 参数,不需要维护多套认证体系。适合评估阶段不确定最终用哪款模型的团队。
常见问题
Q:Flash 模型和旗舰模型的质量差距有多大? 取决于任务类型。内容分类、简单摘要、格式转换、FAQ 匹配:Flash 档结果与旗舰基本无差异,大量团队实测确认。复杂多步推理、高难度代码生成、数学证明:旗舰档明显更准。建议先把你自己的核心任务在 Flash 档上跑一遍,对比旗舰档的输出,不要凭感觉做判断。
Q:七牛云 Token Plan 的积分用不完怎么办? 积分按周刷新,本周未用完的积分不结转到下周。用不完说明订阅档过高,或者根本不适合订阅方案,直接切回按量付费更合算。订阅方案只在月用量稳定、能消耗掉大部分积分时有价值。
Q:这些省钱方法可以同时用吗?
可以,而且叠加效果是乘法关系。最快落地的顺序:先换 Flash 档模型(-84%,改 model 参数)→ 固定系统提示词前缀提高缓存命中(-43%)→ 离线任务排到闲时(-6%)→ 月用量稳定后评估订阅 Token Plan(-42%)。每一步都可以独立上线,不需要整体重构。
Q:只用一款模型,订阅七牛云 Token Plan 还划算吗? 只用单一厂商自研模型时,直接在原厂按量购买是简单选择——原厂有最直接的刊例价,不引入额外平台层。Token Plan 的优势在多模型混用场景,以及需要费用封顶保护的团队。
结论
企业大模型成本里有 90% 以上的节省空间,分布在四个层次:换对模型档位(-84%)、命中缓存(-43%)、错峰调用(-6%)、订阅套餐锁定折扣(-42%)。四步叠加可以把同等任务量的月账单从 10 万元降到 5,000 元以内。任何一步都可以单独落地。对月用量稳定、同时调用多款国产模型的团队,七牛云 Token Plan 2,999 元起,积分覆盖 DeepSeek、Kimi、GLM、豆包等十余款模型,单 Key 统一管理,超额自动停止计费,是当前折扣范围最广的多模型订阅方案之一。本文数据来自 ithome(2026-11-13)、掘金(2026-11-10)、CSDN(2026-11-13)对国内平台的实测,以各平台当前官网价格为准。
延伸阅读
- 七牛云 Token Plan 订阅方案:qiniu.com/ai/plan
- CSDN 企业 MaaS 平台横评:csdn.net/article/2026-11-13/170739248
- 掘金 GLM-5.3-Flash 全平台价格对比:juejin.cn/post/7706350973791764480