AI 生成代码审查实操指南:为什么"看起来没问题"最危险
AI 生成代码审查困难的核心原因由学者 Diomidis Spinellis 在 2026 年 5 月的技术博客中系统提出:使用生成式 AI 辅助编程时,开发者反而需要比完全手写代码时更深入地理解系统,因为传统编程里"不理解就没法改代码"这道天然闸门在审查环节消失了,人可能在自以为理解的情况下接受了错误的改动。文章从元认知监控能力不足、邓宁-克鲁格效应、解释深度错觉、大模型输出的天然流畅性叠加自动化偏见四个角度解释了这种困难的成因,同时开源社区也出现了 Vibe Coding Review Checklist 这类结构化审查框架,用加权评分和风险分级把"审代码的感觉"转化为可执行的检查项。这篇文章把这些理论和工具落到实操层面:审查 AI 生成代码具体要看什么、按什么顺序看、怎么避免"读起来很顺就放行"的陷阱。
为什么 AI 生成的代码更难审查
传统代码审查有一个隐性保护机制:如果你没看懂一段逻辑,你没法把它改对,这个"卡壳"本身会提醒你要停下来搞清楚。但审查 AI 生成的代码时,这个机制不起作用了——AI 写出来的代码往往语法工整、命名规范、逻辑表面自洽,读起来"顺",但顺不代表对。
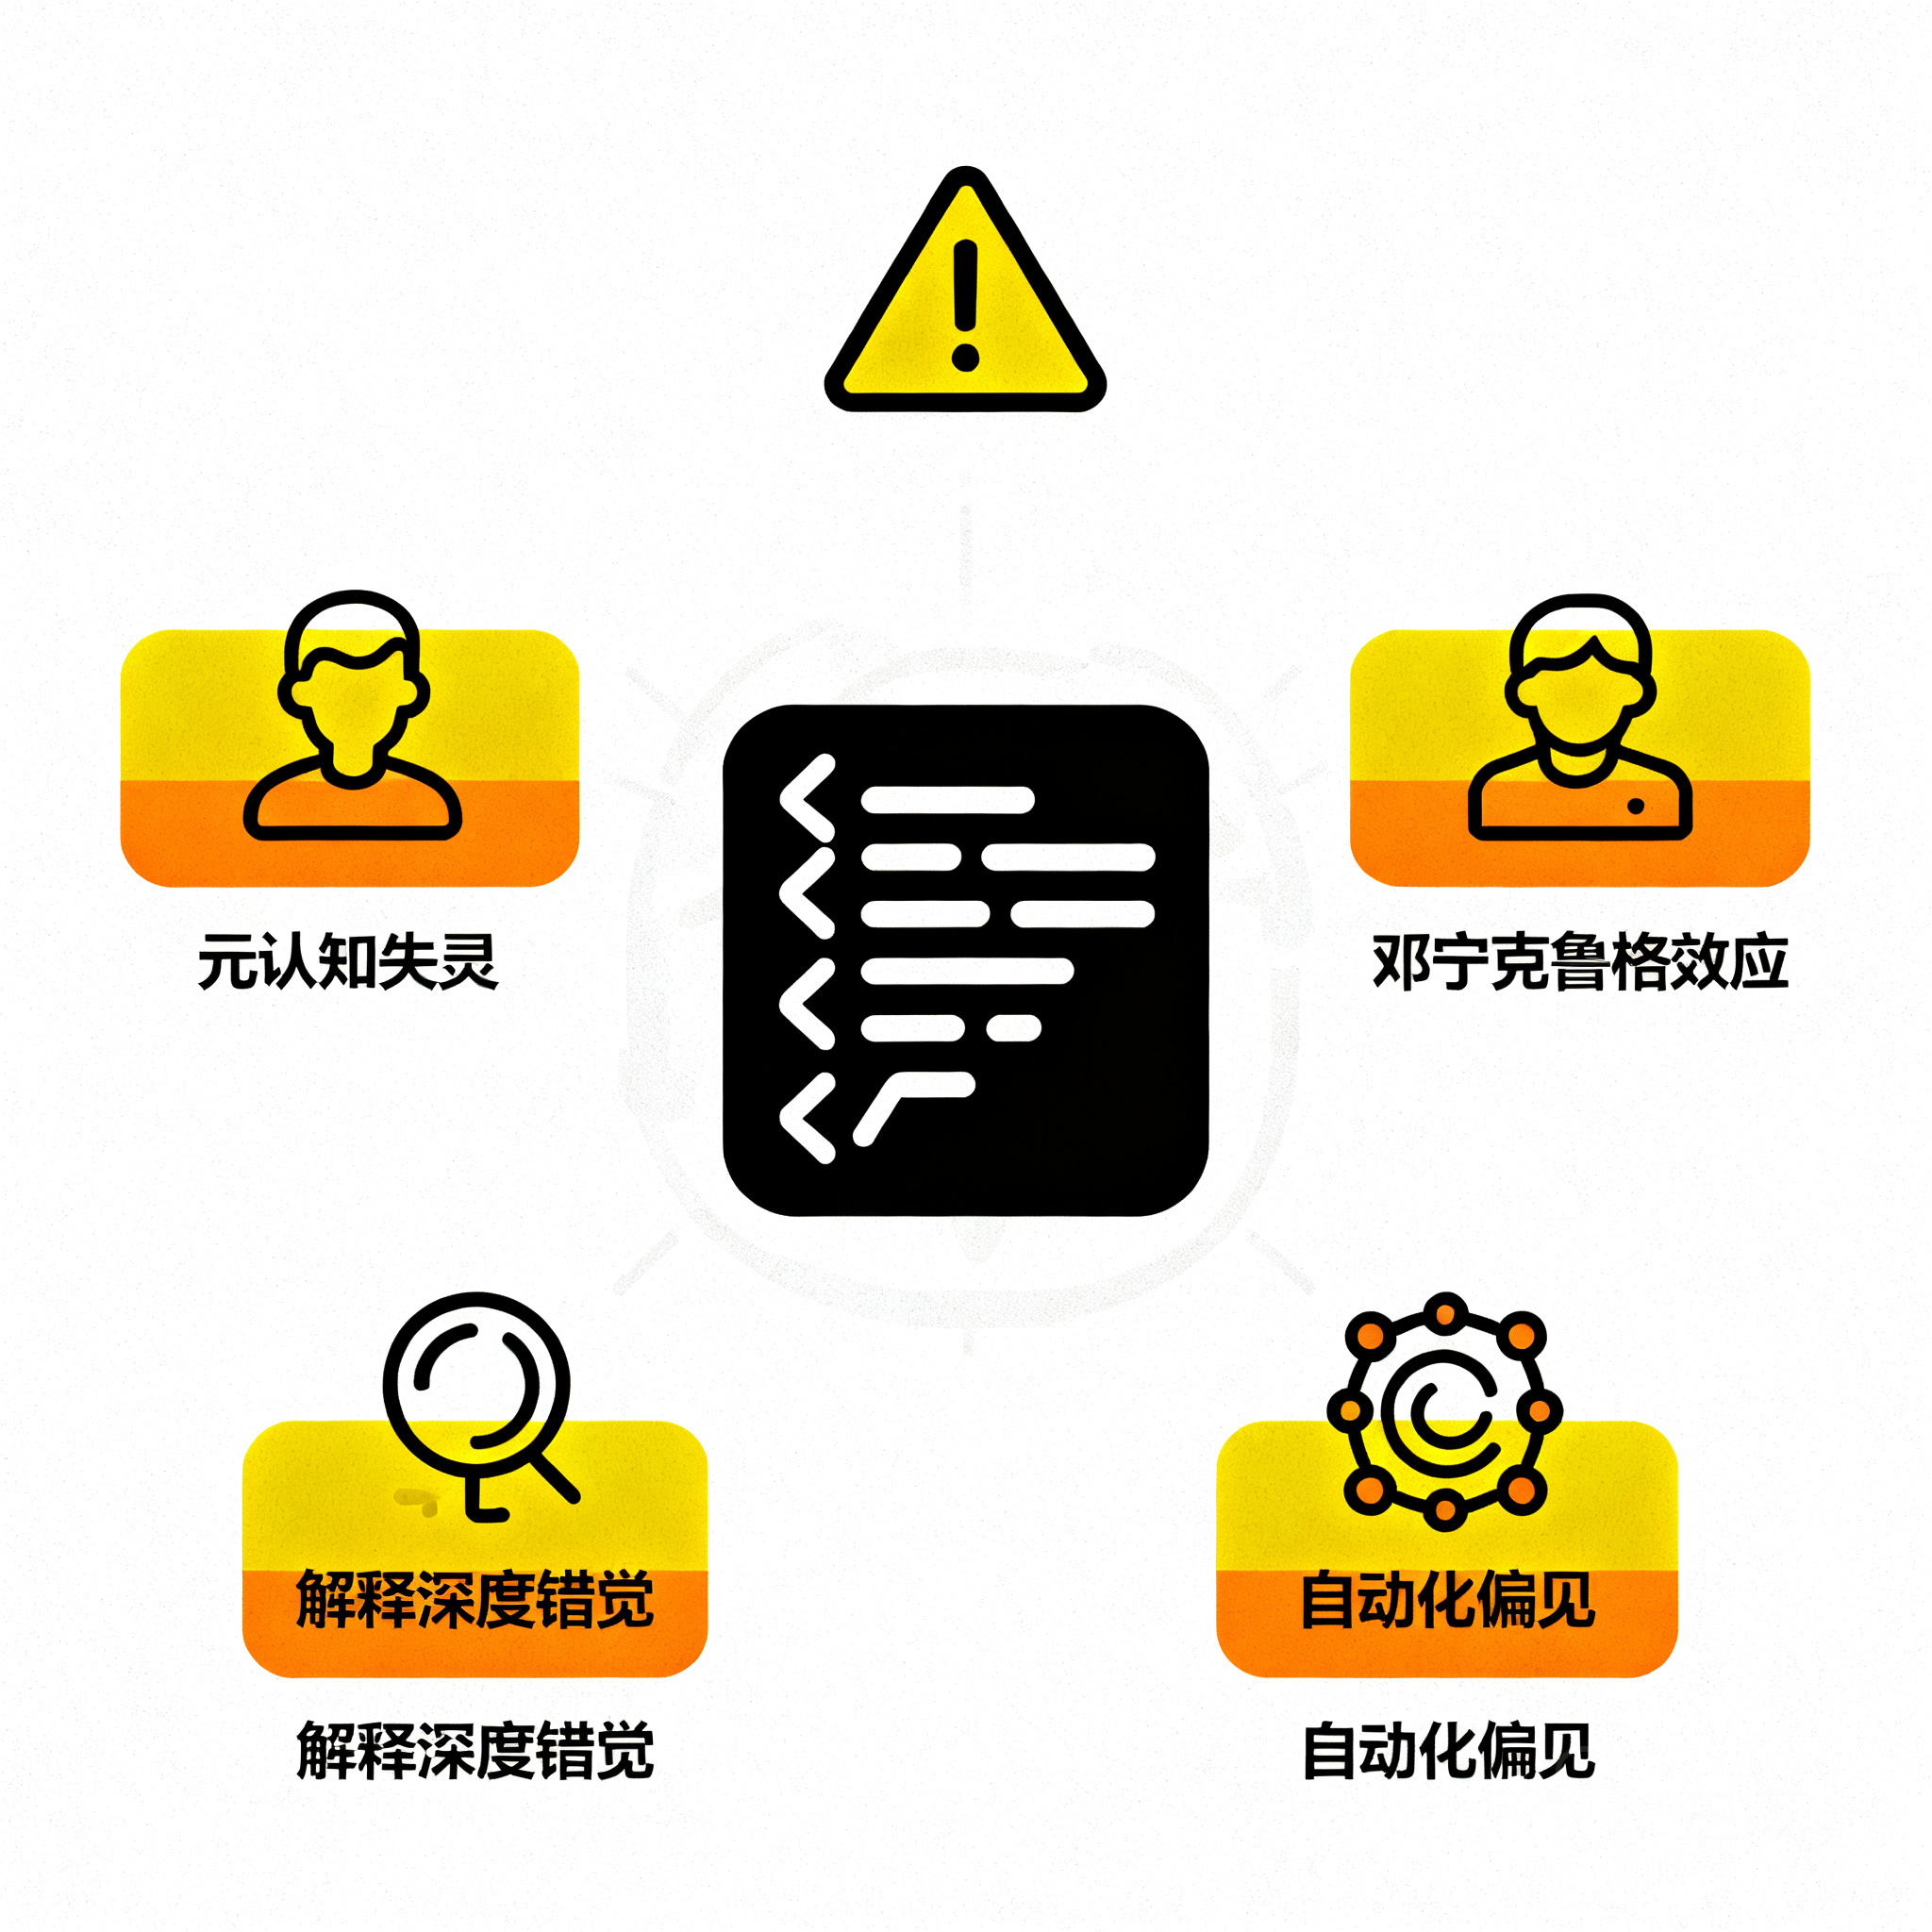
Spinellis 把这种困难拆成四个具体机制:
元认知判断失灵。审查代码本质上需要一种"评估自己理解程度"的能力——你要能察觉到"我其实没看懂这一段"。但人对自己理解程度的判断本身就不准,尤其在处理流畅、逻辑自洽的文本时,更容易产生虚假的"知晓感"。
邓宁-克鲁格效应被放大。完成一项任务所需的技能,恰好也是评估这项任务完成质量所需的技能。这意味着经验越少的开发者,越容易高估自己判断 AI 代码正确性的能力,也越容易放行有缺陷的代码。
解释深度错觉。人们对"机制类知识"(算法为什么这样设计、架构为什么这样分层)的理解程度,普遍被自己严重高估,而这恰恰是编程里最重要、最难靠工具核实的部分——相比之下,具体的 API 用法、语法细节反而是最容易查证的。
流畅性掩盖错误 + 自动化偏见叠加。大模型是逐个预测"最可能的下一个词"生成代码的,所以输出天生看起来像是对的,就算逻辑有问题,也不会出现人类常犯的那种"一眼能看出不对劲"的口误式错误。加上人对自动化系统本身存在过度信任的倾向,两者叠加会导致两类审查失败:错误地接受了不该接受的代码(比如冗余的重复逻辑),或者遗漏了本该发现的问题(比如缺失的异常处理、缺失的测试用例)。
实操审查清单:七个维度逐项过
开源项目 Vibe Coding Review Checklist(v2.0.0,MIT 协议)给出了一套可执行的结构化框架,把"审代码的直觉"拆成七个明确维度,配合权重和评分做量化判断:
| 审查维度 | 权重 | 核心检查点 |
|---|---|---|
| 上下文与目的 | ⭐⭐⭐ | 这段代码要解决什么问题,AI 是否理解偏了需求 |
| 技术栈选择 | ⭐⭐⭐⭐ | 引入的框架/依赖是否合理,版本是否兼容 |
| 功能完整性 | ⭐⭐⭐⭐⭐ | 界面/接口看起来完整,但背后逻辑是否只是占位符(stub) |
| 代码质量 | ⭐⭐⭐⭐ | 结构、命名、可维护性 |
| 安全性 | ⭐⭐⭐⭐⭐ | 密钥是否硬编码、鉴权是否缺失 |
| 部署就绪度 | ⭐⭐⭐ | 是否只是能跑的 demo,离生产环境还差多少 |
| 审查范围界定 | — | 明确这次审查覆盖到哪里,避免遗漏边界 |
七个维度中安全性和功能完整性权重最高(各 5 星),符合 AI 生成代码最容易出问题的两个方向。
三类高频"AI 代码特有坑",人工审查时优先看
结合上述框架和实际踩坑经验,审查时应该优先排查以下三类问题,这些是传统人工代码里较少见、但 AI 生成代码里高频出现的:
-
看起来完整、实际是空壳的实现:界面渲染完整,按钮能点,但点击后触发的逻辑只是一个
TODO或者直接返回假数据。AI 倾向于先把"看起来能跑"的部分写完整,核心业务逻辑反而容易被简化或跳过。 -
虚构的依赖包:AI 有时会引用实际不存在、或者已经改名/废弃的第三方库,写代码时看起来语法正确,但安装阶段直接报错,或者安装到了同名但功能完全不同的包。装依赖前先查证包名和版本是否真实存在。
-
默认假设"happy path",缺失异常处理:AI 生成的代码往往只覆盖了最常见的成功路径,输入校验、异常捕获、边界条件处理经常缺失或写得非常薄弱,需要审查者主动去想"这段代码在什么输入下会崩"。
审查顺序建议:从粗到细,从功能到安全
按下面的顺序审查,能更早发现致命问题,避免在细枝末节上耗费精力:
- 先确认目的是否理解正确:AI 写的代码逻辑再漂亮,如果理解错了需求,等于全部推翻重来
- 再验证功能是否真的完整:重点排查上面提到的"空壳实现",凡是核心业务逻辑必须逐行读完,不能只看接口签名
- 然后查安全边界:密钥、鉴权、输入校验,这三类问题一旦上线出事故成本最高
- 最后看代码质量和可维护性:命名、结构、重复逻辑,这类问题不会导致立即出故障,但会拖慢后续迭代速度
常见问题
AI 生成的代码语法正确、能跑起来,是不是就说明没问题?
不能。能跑通只代表覆盖到了 happy path,不代表覆盖了异常情况,也不代表业务逻辑理解正确。前面提到的"空壳实现"很多时候表面上完全能运行。
为什么资历浅的开发者更容易被 AI 生成代码"坑"?
邓宁-克鲁格效应决定了判断代码质量所需的能力,本身就是完成开发任务所需的能力,经验不足时这两种能力同时不足,导致更容易高估自己对 AI 输出的判断准确度。
审查 AI 代码有没有工具能辅助,而不是纯靠人工?
可以借助结构化审查框架(比如上文提到的加权评分清单)把审查标准化,也可以借助多模型交叉验证的方式——用另一个模型去复核第一个模型的输出逻辑是否自洽,作为人工审查前的一道筛子,但最终判断仍需要人工介入,不能完全依赖工具。
审查 AI 生成代码需要比审查人写的代码花更多时间吗?
通常需要更谨慎,尤其是在功能完整性和异常处理这两块要格外投入时间,因为 AI 代码的"流畅性错觉"会让审查者本能地放慢警惕。花在理解逻辑本身的时间未必更多,但花在"确认自己真的理解了"这件事上的时间应该更多。
参考资料与延伸阅读
本文关于审查困难成因的分析主要参考 Diomidis Spinellis 的技术博客,审查框架部分参考开源项目 Vibe Coding Review Checklist(v2.0.0,MIT 协议)。如果团队协作中需要多个大模型交叉验证代码逻辑,可以参考七牛云 AI 大模型广场的多模型同屏对比功能,用不同模型的输出互相校验来辅助人工判断。审查方法论仍在快速演进中,具体清单条目可能随实践积累调整,建议结合团队实际场景灵活取舍。