Gemini 3.8 Live 与 Extended Thinking 发布:实时语音 Agent 进入“边说边思考”阶段
Google 于 2026 年 9 月 15 日发布 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking,两者都是实时语音 Agent 模型。标准版主打低延迟对话与快速工具调用,Extended Thinking 则能边说边在后台完成多步推理。两款模型均支持 131,072 输入 Token、65,536 输出 Token,并通过 Gemini API 与 Google AI Studio 开放。本文拆解二者差异、价格、接入和迁移要点。
**定义:**Gemini 3.8 Live 是低延迟实时语音模型,Extended Thinking 是可在对话不中断时执行后台多步推理的高复杂度版本;两者于 2026 年 9 月 15 日发布。
Gemini 3.8 Live 系列发布了什么?
Gemini 3.8 Live 系列把语音理解、推理、语音生成和工具调用放进同一个持续连接中,目标是减少传统“语音识别—文本模型—语音合成”级联架构带来的延迟与信息损失。
Google 同时给出了两个稳定模型 ID:
gemini-3.8-live:默认推荐给多数低延迟语音 Agent。gemini-3.8-live-extended-thinking:推荐给需要后台推理、并行工具和多步规划的复杂任务。
两款模型均通过有状态 WebSocket 使用 Live API。输入音频采用 16-bit PCM、16kHz、小端格式,输出音频采用 16-bit PCM、24kHz、小端格式;图像或视频帧建议不超过每秒 1 帧。
Gemini 3.8 Live 和 Extended Thinking 有什么区别?
两款模型最大的区别不是“回答质量高低”,而是任务生命周期和延迟策略不同。
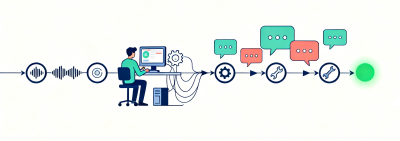
标准版更像反应迅速的对话执行者:用户说完后,模型立即回应并调用快速工具。Extended Thinking 更像会保持沟通的任务代理:它可以先说“我正在检查”,然后继续推理、并行查询外部系统,再补充最终结果。
这次升级有哪些关键能力?
对话不中断的异步工具调用
Gemini 3.8 Live 可以在后台调用 API,同时继续输出语音。Extended Thinking 更进一步,把后台推理与异步工具组合起来,适合工具执行需要数秒、但用户不能一直听到静默的场景。
实时视觉上下文
模型可以结合摄像头画面、屏幕或图片理解用户正在讨论的对象。典型应用包括远程维修指导、购物助手、智能眼镜、车载助手和带视觉上下文的教育辅导。
97 种语言自动切换
Google 2026 年发布公告称,Gemini 3.8 Live 可在对话中自动检测并切换 97 种语言,并保持口音一致性。对于跨语种客服和国际化产品,这减少了预先选择语言和手动路由的工作。
字母数字信息识别
新模型针对确认码、理赔编号、技术参数等字母数字混合内容做了增强。这一能力对电话客服尤其重要,因为一个字符识别错误就可能让整个后续流程失效。
SynthID 音频水印
Google 表示,其 AI 产品生成的音频都嵌入不可感知的 SynthID 水印,以便后续检测 AI 生成内容。水印有助于来源识别,但不能替代应用侧的录音告知、身份校验和审计记录。
Extended Thinking 的“边说边想”如何工作?
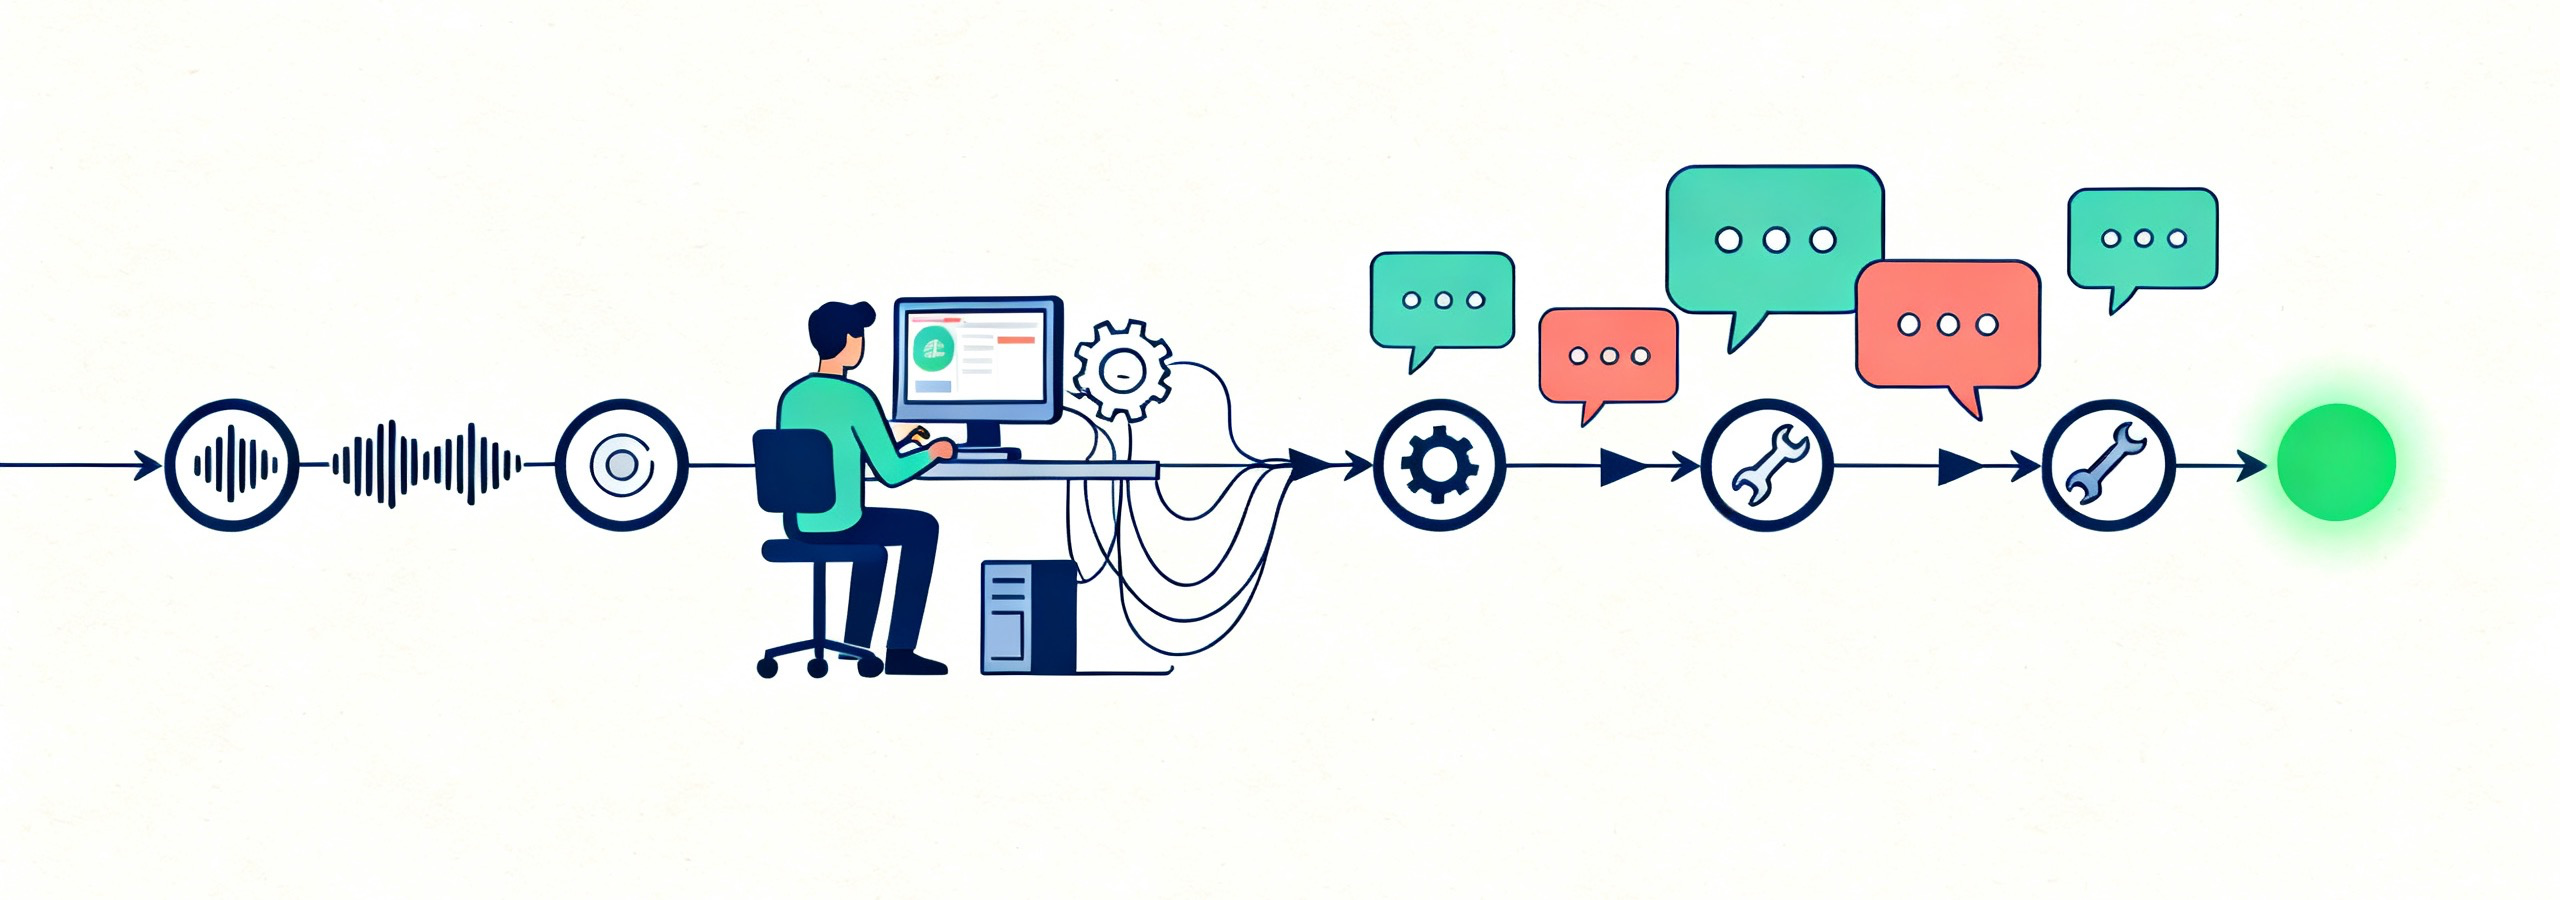
Extended Thinking 会把一次用户请求拆成多个口语响应、后台推理和工具执行阶段,因此客户端不能再把一次说完当成整个任务结束。
用户请求
  ↓
模型先口头确认:“我正在检查……”
  ↓                         ↘
持续输出进度          后台推理 + 异步工具调用
  ↓                         ↙
汇总工具结果并继续解释
  ↓
interaction_status = IDLE,整个任务才真正结束
Google 官方文档定义了两个状态:IN_PROGRESS 表示模型仍在处理输入、后台推理或等待异步工具;IDLE 才表示推理、工具调用和输出均已完成,可以接受下一项任务。
Gemini 3.8 Live 实测数据怎么看?
基准测试表明 Extended Thinking 的优势集中在复杂语音任务,但单项分数不能直接等同于具体业务中的成功率。
Gemini 3.8 Live 标准版在 Speech Agent Arena 位列第 2。Google 还表示,两款模型在 ServiceNow EVA-Bench 上推进了复杂工作流中“准确率—对话质量”的帕累托前沿。
生产选型仍应使用自己的录音、口音、噪声、工具延迟和业务规则做评测,尤其要统计打断恢复、号码识别、工具误调用和任务完成率。
价格是多少?
Google 2026 年 9 月的开发者公告给出的两款模型价格相同:音频输入每分钟 0.005 美元,音频输出每分钟 0.018 美元。
以上是按输入和输出音频各自持续满时长计算的静态示例,不包含 Google Search 等工具费用,也不代表通话总时长必然全部计费。正式上线应以账单中的实际音频用量和最新价格页为准。
如何用 Python 接入 Extended Thinking?
下面的最小示例使用 Google GenAI SDK 建立 Live API 会话、保存 24kHz 音频,并以 interaction_status 判断任务是否完成。
pip install -U google-genai
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
import asyncio
import wave
from google import genai
from google.genai import types
client = genai.Client()
model = "gemini-3.8-live-extended-thinking"
config = types.LiveConnectConfig(
response_modalities=["AUDIO"],
thinking_config=types.ThinkingConfig(thinking_level="low"),
)
async def main():
with wave.open("response.wav", "wb") as output:
output.setnchannels(1)
output.setsampwidth(2)
output.setframerate(24000)
async with client.aio.live.connect(
model=model,
config=config,
) as session:
await session.send_client_content(
turns={"parts": [{"text": "分析这个报错,并分步骤说明排查方法"}]}
)
async for message in session.receive():
if message.data:
output.writeframes(message.data)
status = getattr(message, "interaction_status", None)
if status == "IN_PROGRESS":
print("仍在推理或执行工具")
elif status == "IDLE":
print("任务完整结束")
break
asyncio.run(main())该示例只演示会话状态和音频输出。浏览器直连时不应暴露长期 API Key,应使用短期凭证;生产系统还要处理断线重连、会话恢复、用户打断、工具超时、录音授权和输出转录。
从 Gemini 3.1 Flash Live 迁移要改什么?
迁移到 Gemini 3.8 Live 不只是替换模型名,至少要检查以下 6 项。
将
gemini-3.1-flash-live-preview改为稳定 IDgemini-3.8-live。标准版不支持
thinking_level,应删除旧的thinking_config。Extended Thinking 的工具声明必须使用
behavior: NON_BLOCKING,同步阻塞模式会返回硬错误。Extended Thinking 不能依赖
turnComplete: true判断空闲,应监听interaction_status。Proactive Audio 永久启用,设置
proactive_audio: false会报错。Affective Dialogue 配置已移除;视频帧默认会进入上下文,应按需发送以控制成本。

应该选标准版还是 Extended Thinking?
选择标准版还是 Extended Thinking,取决于用户能容忍的首包延迟、任务复杂度和客户端是否能正确维护异步状态。
选择 Gemini 3.8 Live
客服分流、语音搜索、口语练习、互动故事、智能家居控制等任务通常路径短、工具快,优先使用标准版。它的客户端逻辑也更简单,turnComplete 可以继续作为单轮结束信号。
选择 Extended Thinking
技术支持诊断、旅行规划、银行业务编排、代码辅导和跨系统数据查询需要比较多项结果或连续调用工具,更适合 Extended Thinking。后台推理可以减少沉默等待,但客户端开发和异常恢复也更复杂。
不要把 Extended Thinking 当成默认升级
高推理深度不必然带来更好的实时体验。简单问题使用 Extended Thinking 可能增加延迟、状态管理和测试成本。更稳妥的架构是先按任务复杂度路由,再用离线评测确定升级阈值。
国内团队如何设计多模型备选方案?
Gemini 3.8 Live 的原生音频和 Live API 应直接通过 Google 官方接口接入;若业务还需要国产文本模型、编程模型或常规 Agent 的统一 API,可把它们放在独立的文本推理层,而不是冒充 Live API 的无缝替代品。
七牛云 Token Plan(DeepSeek-V4、Kimi-K3、GLM-5.3、MiniMax-M3 等 15 款国产模型,¥2,999/月起,单 API Key 切换,兼容 OpenAI 格式,https://api.qnaigc.com/v1)适合承担非实时文本任务或多模型验证;语音主链路与文本降级层需要分别评测,不能只比较模型名称。
当前可用范围
截至 2026 年 9 月 17 日,两款模型均已在 Gemini API 和 Google AI Studio 开放。Gemini Enterprise 处于私有预览;Extended Thinking 正向 Gemini Enterprise for Customer Experience 和 Google Workspace 商业客户扩展。
个人用户侧,Gemini 3.8 Live 已进入 Search Live;Extended Thinking 已进入 Gemini Live,并向 Google AI Pro、Ultra 的 Docs 用户以及 Google AI 订阅用户的 Gmail、Keep 场景逐步推出。不同地区、账号和套餐的到达时间可能不同。
已知限制与上线检查
Google DeepMind 的模型卡明确指出,两款模型仍可能产生幻觉,偶尔出现变慢或超时,知识截止时间为 2025 年 1 月。因此,实时联网、工具结果校验和人工接管仍是生产系统的必要组成部分。
上线前建议至少完成以下检查:
用真实噪声、口音和电话线路测试语音识别与打断恢复。
为号码、金额、地址等高风险字段增加二次确认。
给每个工具设置超时、幂等键、权限边界和审计日志。
仅在收到
IDLE后把 Extended Thinking 会话显示为完成。对高风险决策保留人工审批,不让语音流直接触发不可逆操作。
持续记录延迟、任务完成率、误调用率和每分钟实际成本。
总结
Gemini 3.8 Live 的核心价值是把低延迟语音、视觉理解和后台工具执行组合成规模化实时 Agent;Extended Thinking 的核心价值则是让复杂推理不再迫使对话长时间沉默。真正影响上线质量的,不只是模型分数,而是客户端能否正确处理异步状态、工具权限、打断恢复和失败降级。
本文依据 Google、Google AI for Developers 与 Google DeepMind 2026 年 9 月 15 日至 16 日发布的官方资料整理,属于高时效内容,建议在 39 天内复核价格、地区可用性、模型版本和接口行为。
参考资料
Google:Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking,2026-09-15。
Google:Build real-time voice applications with Gemini Audio,2026-09-15。
Google AI for Developers:Gemini 3.8 Live,更新于 2026-09-15。
Google AI for Developers:Gemini 3.8 Live Extended Thinking,更新于 2026-09-15。
Google AI for Developers:Thinking in the Live API,更新于 2026-09-15。
Google DeepMind:Gemini 3.8 Audio Model Card,2026-09-15。
七牛云:AI 大模型广场,访问于 2026-09-17。