Hermes Agent MOA 教程:让多个模型同时答题再合并,实测超过单一顶级模型
关键词:Hermes Agent / MOA / Mixture of Agents / 多模型协作
MOA(Mixture of Agents)是 Together AI 联合斯坦福、芝加哥大学、杜克大学于 2024 年提出的多模型协作推理架构,核心思路是:同时让多个参考模型独立回答问题,把它们的输出匿名后交给一个聚合模型合并提炼,最终得到超越任何单一模型的答案。论文(arXiv:2406.04692)在 AlpacaEval 2.0 上验证:纯开源模型组合的 MoA 得分 65.1%,超过 GPT-4 Omni 的 57.5%,同时在 MT-Bench 和 FLASK 达到 SOTA。Hermes Agent(Nous Research 出品)是目前对 MOA 支持最完整的 AI Agent 框架之一,内置 MoA 预设,三条命令可开启。本文覆盖 MOA 原理、Hermes 安装、MoA 配置、全本地方案和零成本云端方案两种玩法。
MOA 到底怎么工作?
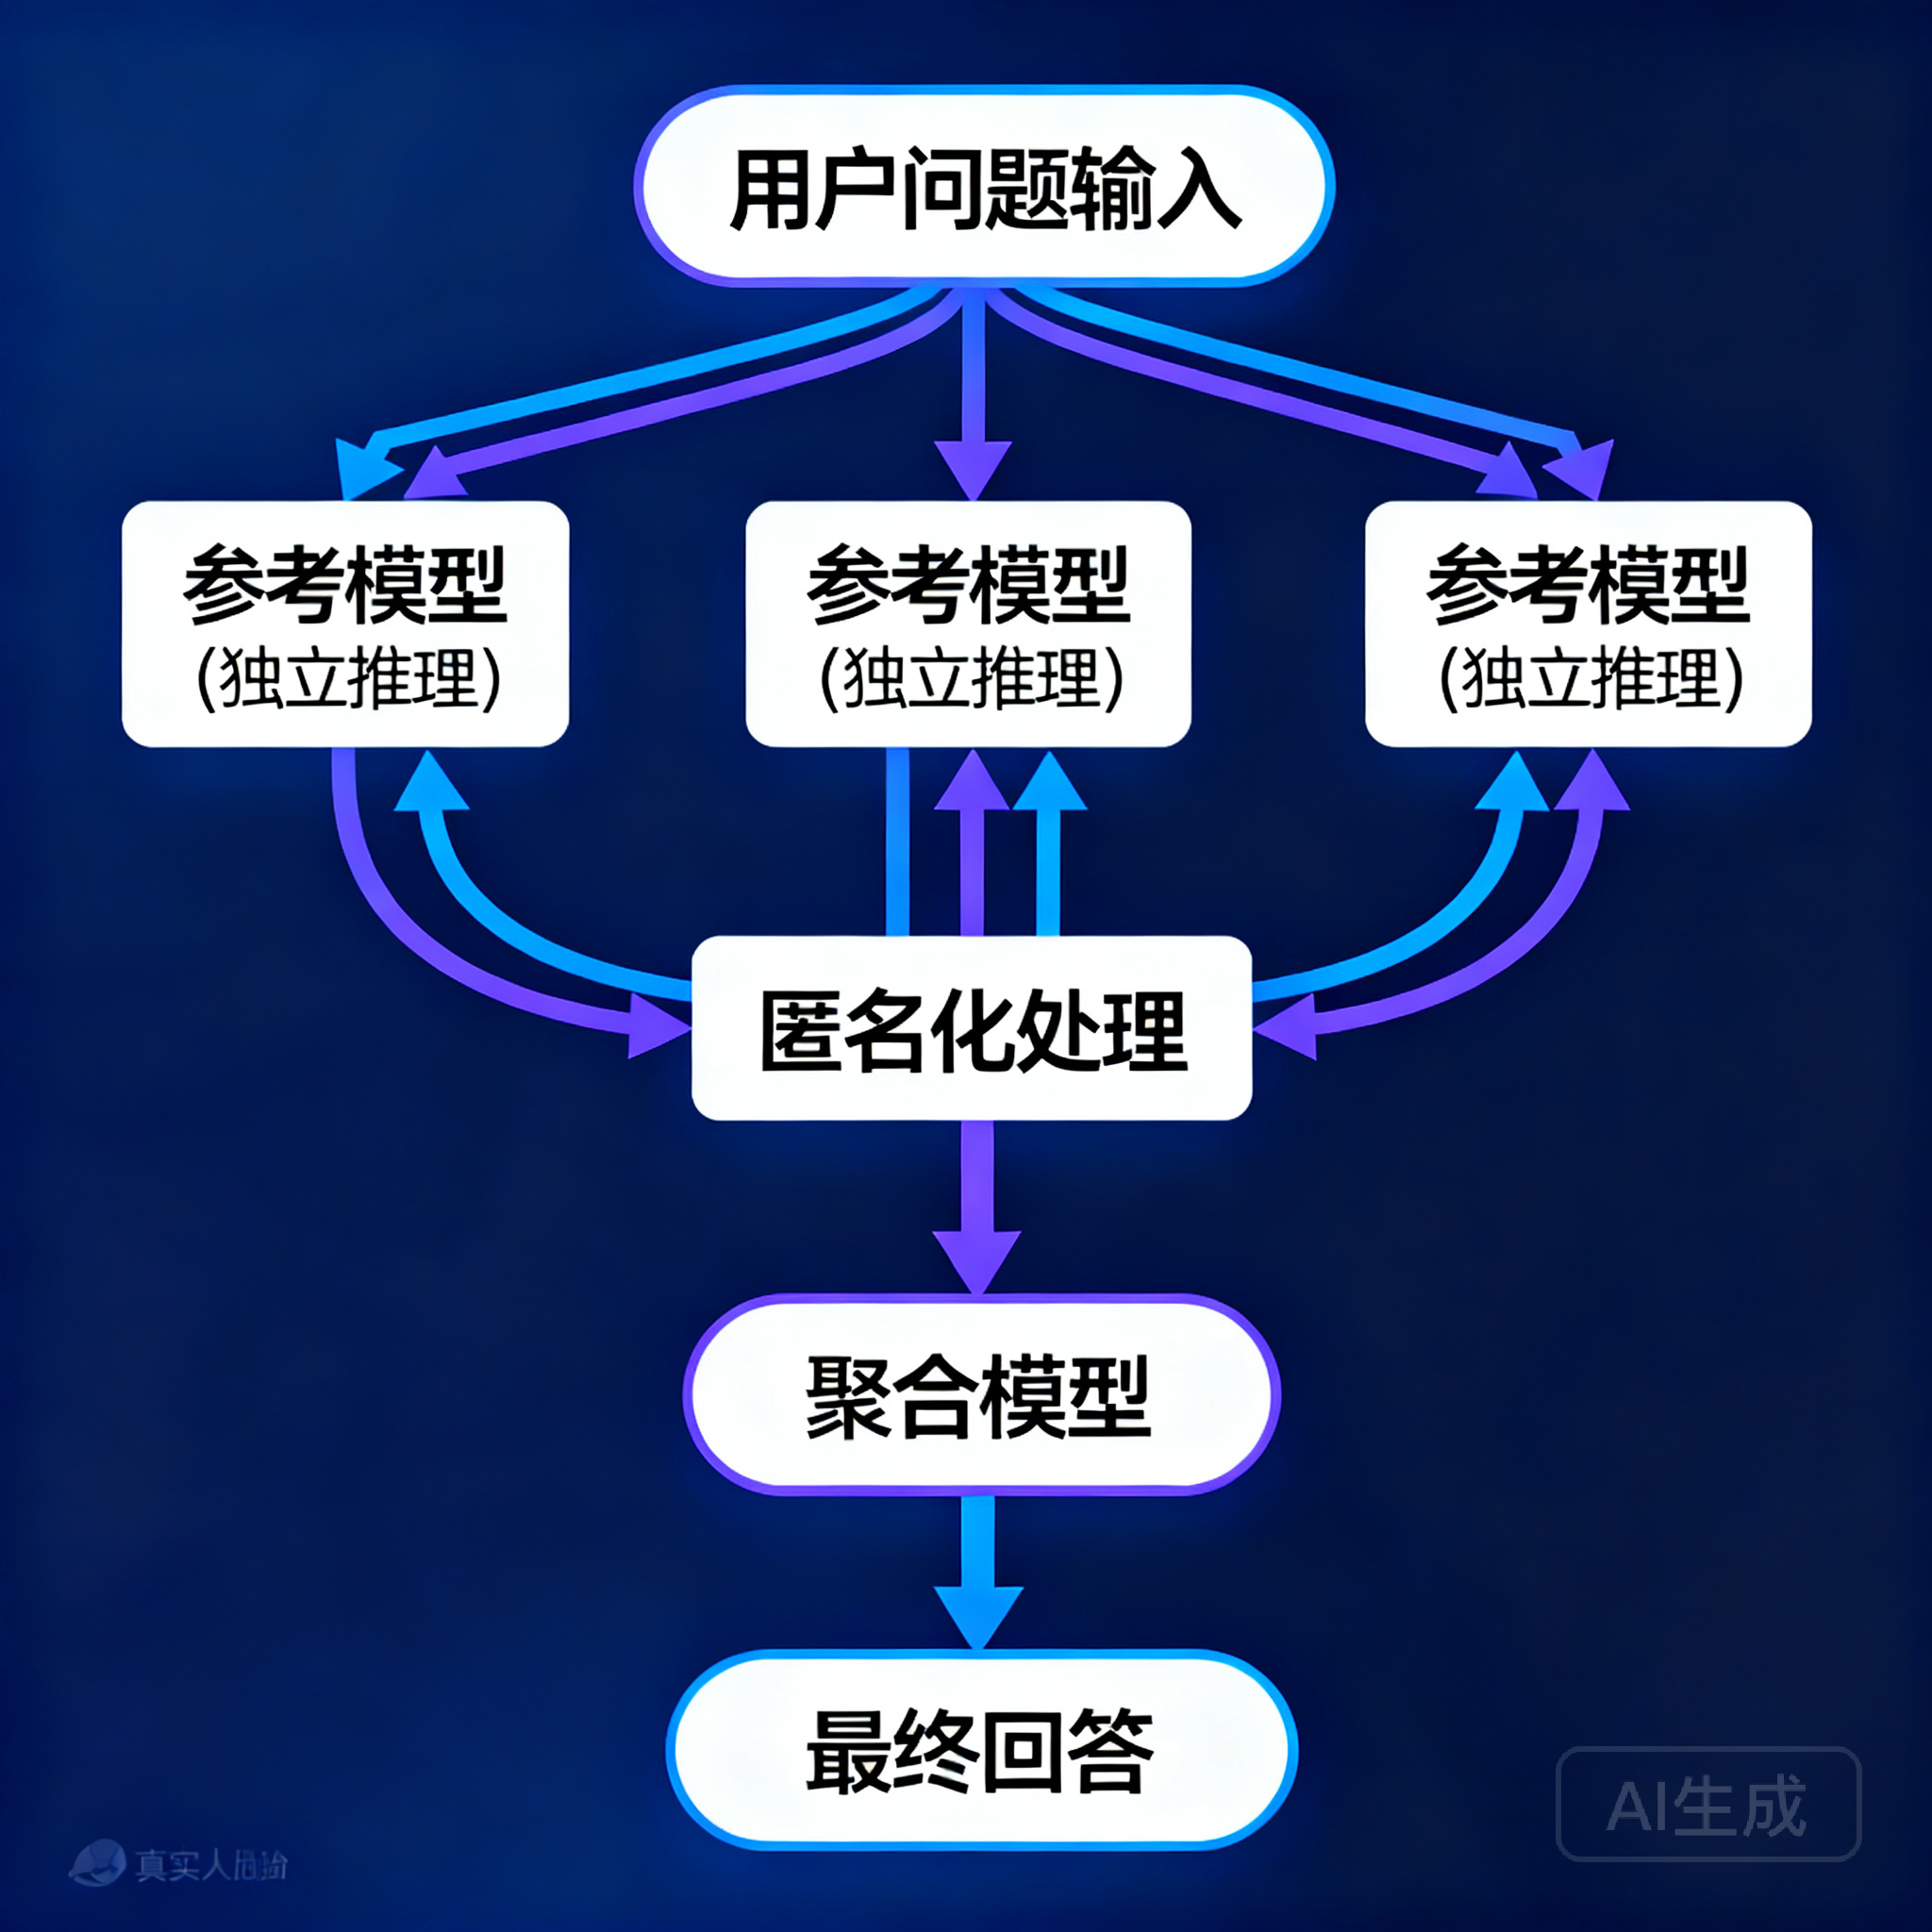
传统 RAG 或单模型链(Chain of Thought)都是一问一答的线性结构——一个模型从头到尾独立负责。MOA 的不同在于引入了"多参考 + 单聚合"的并行层级架构:
用户问题
    │
    ├──▶ 参考模型 A(独立推理)
    ├──▶ 参考模型 B(独立推理)     ← 匿名化后传给聚合模型
    └──▶ 参考模型 C(独立推理)
                │
                ▼
           聚合模型(Aggregator)
                │
                ▼
          最终回答 + 工具调用
参考模型不接收工具 schema,只做"廉价咨询调用"——它们各自独立思考,互不知晓对方的输出。聚合模型看到的是经过匿名化的三份草稿加上原始问题,负责综合判断、写出最终回复并执行工具调用。
匿名化是关键设计:如果参考模型的输出带有"我是 GPT-5.5"这类身份信息,聚合模型会对某个品牌产生偏见,削弱多样性带来的增益。
为什么这能提升质量? 不同模型在不同类型问题上各有擅长——推理、代码、长上下文、创意写作。把它们并联后,弱点被互补,共识被强化,边缘错误被过滤。HermesBench 数据:双模型面板(Opus-4.8 + GPT-5.5 作参考)得分 0.8202,vs 单用 Opus-4.8 的 0.7607,提升幅度约 8%。
Hermes Agent 是什么?
Hermes Agent 是 Nous Research(以 Hermes 模型系列著称的 AI 研究机构)开源的 AI Agent 框架,MIT 协议,主要特点:
● 自改进学习循环:复杂任务完成后自动创建技能,技能在使用中持续优化
● 全平台覆盖:CLI / Telegram / Discord / Slack / WhatsApp / Signal,同一个 Agent 实例跨平台
● 无厂商锁定:hermes model 命令一键切换任意 OpenAI 兼容提供商,不改代码
● 内置 MOA 支持:配置文件里写好预设,/model xxx --provider moa 即可开启
● 技能生态:兼容 agentskills.io 开放标准,社区技能可直接安装
相关技术实体:Ollama(本地模型运行)、Nous Portal(300+ 模型一站订阅)、FreeLLMAPI(16+ 免费提供商聚合)、agentskills.io(技能标准)。
安装 Hermes Agent
Linux / macOS / WSL2:
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash
source ~/.bashrc   # 或 source ~/.zshrc
Windows(原生 PowerShell):
iex (irm https://hermes-agent.nousresearch.com/install.ps1)
安装程序自动处理 uv、Python 3.11、Node.js、ripgrep、ffmpeg 依赖,Windows 上还会打包 MinGit(不需要管理员权限,不影响系统已有 Git)。
安装完成后:
hermes          # 启动交互 CLI
hermes doctor   # 诊断配置问题
hermes setup    # 运行完整配置向导
配置 MOA:最简路径
Step 1:选择模型提供商
hermes model
按提示选择提供商(Nous Portal / OpenRouter / OpenAI / 自定义端点均可)。国内开发者若需要多款主流模型统一接入,可以选择自定义端点并填入兼容 OpenAI 格式的 API 地址,如七牛云AI支持该接口格式,无需修改其他配置。
Step 2:在 ~/.hermes/config.yaml 添加 MoA 预设
moa:
  presets:
    default-moa:
      references:
        - model: qwen3-14b          # 参考模型 A(不同厂商)
          provider: openrouter
        - model: deepseek-r1        # 参考模型 B(不同厂商)
          provider: openrouter
      aggregator:
        model: gpt-5.5              # 聚合模型(综合能力最强)
        provider: openai
关键原则:参考模型选不同厂商。同一家厂商的两个模型犯的错误高度相关,多样性增益趋近于零;跨厂商模型的错误分布不同,聚合后才有真实增益。
Step 3:激活 MoA
hermes
/model default-moa --provider moa
之后所有对话都会走 MoA 流程:两个参考模型并行推理,聚合模型综合输出。
两种进阶玩法
玩法一:全本地 MOA(零 API Key,高硬件要求)
社区项目 InfiniteWhispers/HermesAgent-MultiModel 实现了完全本地的 8 模型 MoA 栈,通过 Ollama 在单机运行,无任何云依赖。
硬件要求:
● GPU:RTX 4080 / 5080(16 GB VRAM)
● RAM:48 GB+(64 GB 理想)
● 存储:100 GB+ NVMe SSD
MoA 默认配置:
● 参考模型:qwen3-14b-think + ornith-9b(SWE-Bench 69.4%)
● 聚合模型:gpt-oss-20b(工具调用最优,23/25)
性能调优(写入 Ollama systemd 配置):
[Service]
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"
KV Cache 建议:q8_0(25% VRAM 节省,吞吐量损失 <5%);q4_0 虽省 50% VRAM,但 64K 上下文下吞吐量损失高达 92%,不推荐。
玩法二:零成本云端 MOA(免费额度聚合)
社区项目 HERMES-Free-SOTA 通过 FreeLLMAPI(16+ 提供商免费额度聚合路由)+ Hermes MoA 实现近零成本的多模型协作。
已验证运行状态(2026-06-29,MacBook Pro M5 128GB):
● 65 个可用模型,来自 9+ 模型家族
● MoA 预设:kimi-k2.6 + llama-3.3-70b + qwen3-coder-480b → 融合聚合器
● 看门狗 cron:每 6 小时健康检查,故障时告警
# 安装 FreeLLMAPI
git clone https://github.com/tashfeenahmed/freellmapi.git && cd freellmapi
cp .env.example .env
npm install && npm run dev   # 控制台在 http://localhost:5173

# 在控制台 Keys 标签添加免费 API Keys(OpenRouter / Groq / Gemini / DeepSeek)

# 注册为 Hermes 自定义提供商
hermes model   # → 自定义端点 → http://localhost:3001/v1

# 激活免费 SOTA MoA 预设
hermes
/model free-sota --provider moa
模型选择原则(与具体名称无关):
1. 查询 FreeLLMAPI /v1/models 获取当前可用模型,按 intelligence_rank 排序
2. 聚合模型:排名最高者
3. 参考模型:从不同两个提供商家族各选一个排名最高的
4. 每月或大型模型发布后刷新一次
常用命令速查
hermes                          # 启动交互 CLI
hermes model                    # 切换 LLM 提供商和模型
hermes tools                    # 配置工具(Web 搜索、文件操作等)
hermes gateway setup            # 配置 Telegram / Discord 等消息平台
hermes gateway start            # 启动消息网关
hermes update                   # 更新到最新版本
hermes doctor                   # 诊断配置问题
hermes claw migrate             # 从 OpenClaw 迁移
会话内 slash 命令:
/new              新建对话
/model <name>     切换模型(支持 --provider moa)
/reset            重置当前会话
常见问题
Q:MOA 会增加多少延迟?
参考模型并行运行,延迟约等于"最慢的参考模型"而非所有模型之和。代价主要是 token 消耗增加(参考调用 × 参考模型数量)。对于需要高质量输出的场景(代码生成、复杂分析),这个代价通常值得;对于简单问答,单模型即可。
Q:参考模型数量越多越好吗?
不是线性关系。研究表明 2-3 个来自不同厂商的参考模型通常就能获得大部分增益,继续增加边际收益递减,但 token 成本线性增加。HERMES-Free-SOTA 的实测配置是 3 个参考模型 + 1 个聚合模型。
Q:Hermes Agent 和 OpenClaw 有什么关系?
Hermes Agent 是 NousResearch 开发的新一代 Agent 框架,hermes claw migrate 命令支持从 OpenClaw 配置迁移。两者定位相似但不是同一个项目,Hermes 新增了学习循环、技能自动创建等能力。
结语
MOA 的核心洞见是:协作推理比单模型扩展更高效——把同等算力分给多个多样化的模型并行思考,再让聚合模型综合,比把全部算力堆给一个更大的模型效果更好。论文数据(AlpacaEval 2.0:65.1% vs 57.5%)和 HermesBench 实测(0.8202 vs 0.7607)都指向同一个结论。
Hermes Agent 把这套架构封装成了三行命令可以开启的预设,全本地方案(Ollama + 8 模型)和零成本云端方案(FreeLLMAPI)都有社区验证的完整配置可以参考。
本文数据来源:arXiv:2406.04692、NousResearch/hermes-agent 官方 README、InfiniteWhispers/HermesAgent-MultiModel、HERMES-Free-SOTA,内容基于 2026 年 7 月。
延伸资源
● Hermes Agent 官方文档:https://hermes-agent.nousresearch.com/docs/
● Hermes Agent GitHub:https://github.com/NousResearch/hermes-agent
● MOA 原论文:https://arxiv.org/abs/2406.04692
● 本地全栈方案:https://github.com/InfiniteWhispers/HermesAgent-MultiModel
● 七牛云 AI 推理服务(OpenAI 兼容接口):https://www.qiniu.com/ai/plan