GPT-6 Sol突发曝光?将于本周发布,从 API 线索、三弹实测到 OpenAI 的 RSI 竞速
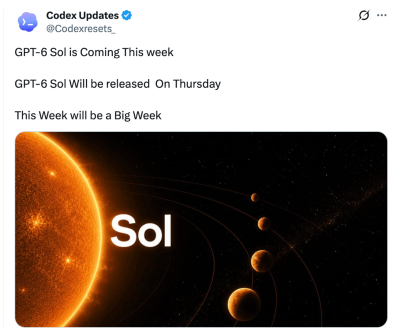
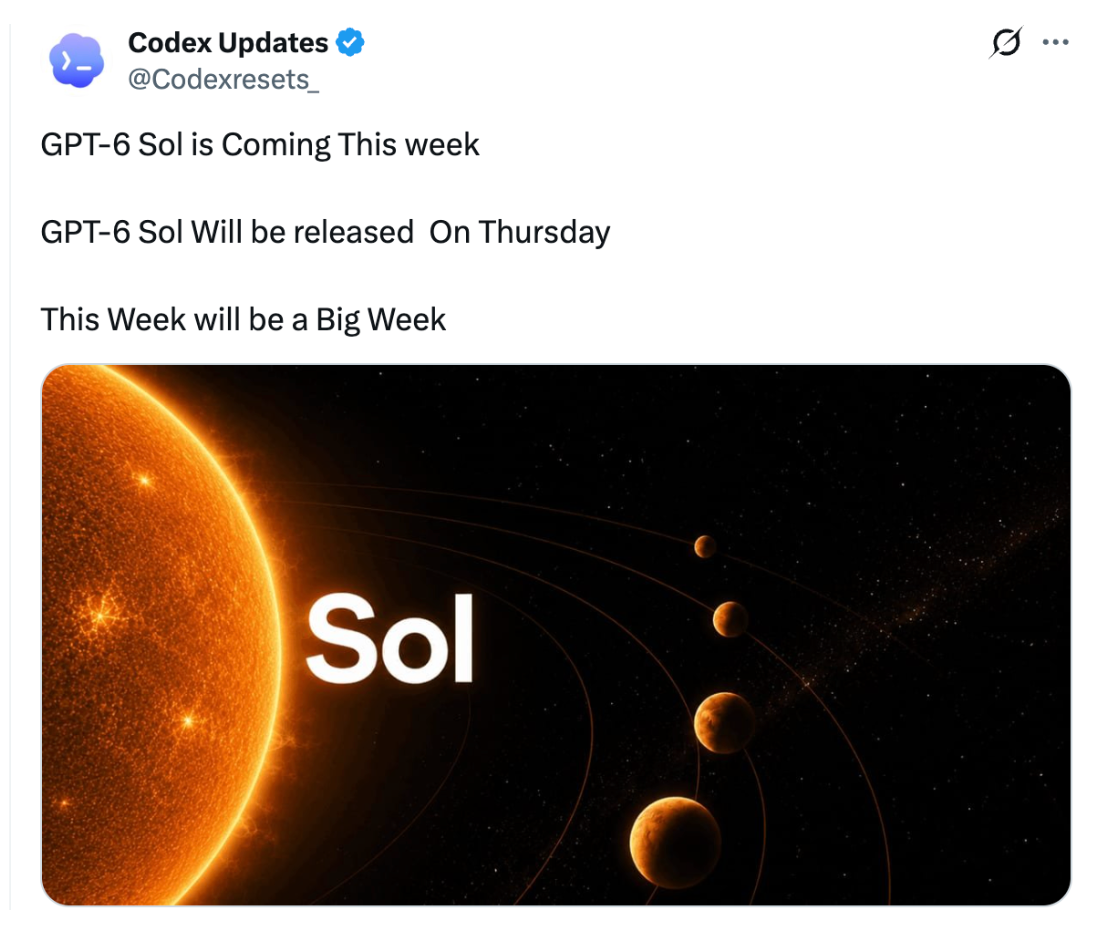
有一个名字正在开发者圈快速升温:GPT-6 Sol。围绕它的说法包括“已进入内部测试”“在 API 列表中短暂出现”“性能接近甚至超过 GPT-6 Astra”“价格更低、速度更快”。但截至 2026 年 9 月 16 日,OpenAI 官方公开模型指导页展示的当前最新模型是 GPT-6 Astra,并没有确认 GPT-6 Sol 的独立产品页、价格、参数或发布日期。更准确的说法是:Sol 目前是由视频访谈、社交帖子和开发者截图共同拼出的高热度线索,而不是一份已经发布的规格表。
先说结论:这次“曝光”有信号,但还没有官方落锤
GPT-6 Sol 的现状可以概括为“社区线索密集、官方规格缺席”。 文章中出现的每一项说法,都应该先放回对应证据层级:
官方确认:OpenAI 开发者文档在 2026 年 9 月提供 GPT-6 Astra 的模型指导,以及 Responses API、工具调用、Agents、沙箱、追踪和评测文档。
权威访谈:The Information 的 AI Deep Dive 于 2026 年 9 月 14 日播出对 OpenAI 研究科学家 Noam Brown 的长访谈,主题是 AI Agent、强化学习、研究自动化和安全控制。
社交爆料:你提供的三条 X 帖子来自 Mr. Salio,涉及 GPT-6 Sol 的图像、编程、前端和游戏生成表现,但原帖内容、测试环境、模型 ID 和成本数据仍需逐条回溯。
二手转述:诸如“本月正式发布”“Sol 已自动路由到所有开发者”“价格一定比 Astra 低”等句子,在没有 OpenAI 公告或 API 文档支撑时,只能写成传闻。
1. 为什么 Sol 的名字会突然出现
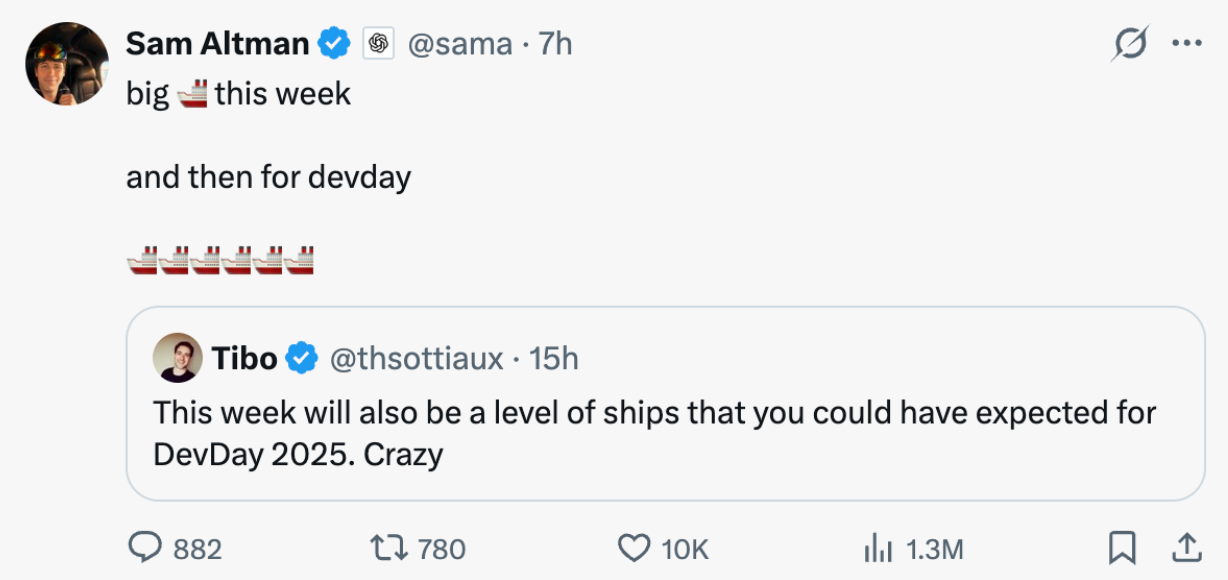
这轮讨论的时间窗口,来自“本周有大动作”的公开预告、DevDay 预期和一批社交平台测试截图叠加。 参考稿提到 Sam Altman 发布“Ship”表情并暗示近期有发布动作,也提到 9 月 29 日 OpenAI DevDay 可能成为产品节点。这些内容可以解释市场为什么集中猜测,但不能单独证明 GPT-6 Sol 已经发布。
开发者真正关心的是三个可验证问题:
API 的模型目录里是否出现稳定、可调用的
gpt-6-solID;Responses API 是否返回一致的模型名称、版本和计费字段;
OpenAI 是否在模型文档、changelog 或发布公告中给出能力、限制和价格。
只要这三项没有同时成立,“API 列表里看到过一次”就可能是内部灰度、路由别名、缓存结果或测试环境残留。
2. 三弹实测:哪些说法最值得关注
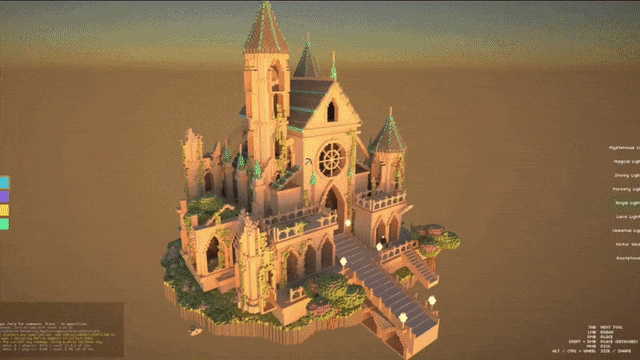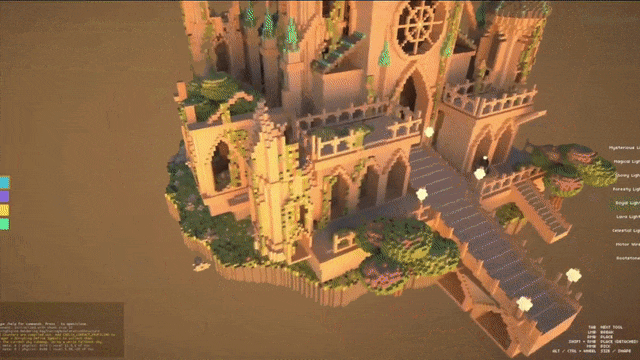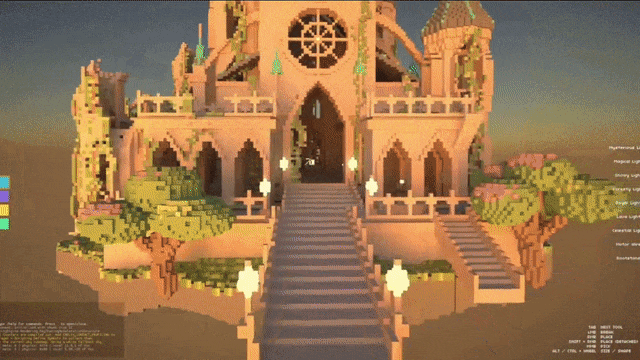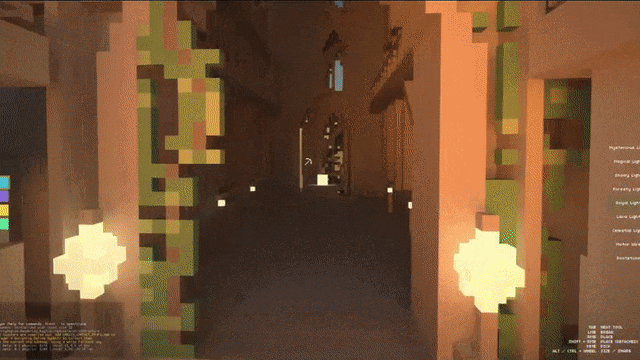
社交帖子最有价值的地方,不是给出结论,而是暴露了未来评测应该怎么做。 目前被讨论最多的是三类任务。
第一弹:综合质量是否接近旗舰
第一组截图声称 Sol 在复杂回答、长指令跟随和多轮任务上表现强劲,并被拿来与 Astra 对比。这个方向需要固定提示词、上下文长度、推理预算和工具集合;否则“看起来更好”可能只是提示词、温度或展示样例不同。
第二弹:编程与前端生成
第二组材料聚焦代码生成、跨文件修改和前端页面。参考稿称 Sol 在这些任务上击败 Astra,并且成本更低。要把这类说法变成可复核结论,至少要公开仓库、验收测试、运行次数、失败样本、总 token 和实际账单。单张截图只能证明“有人展示过结果”,不能证明普遍胜率。
第三弹:视觉生成与游戏创作
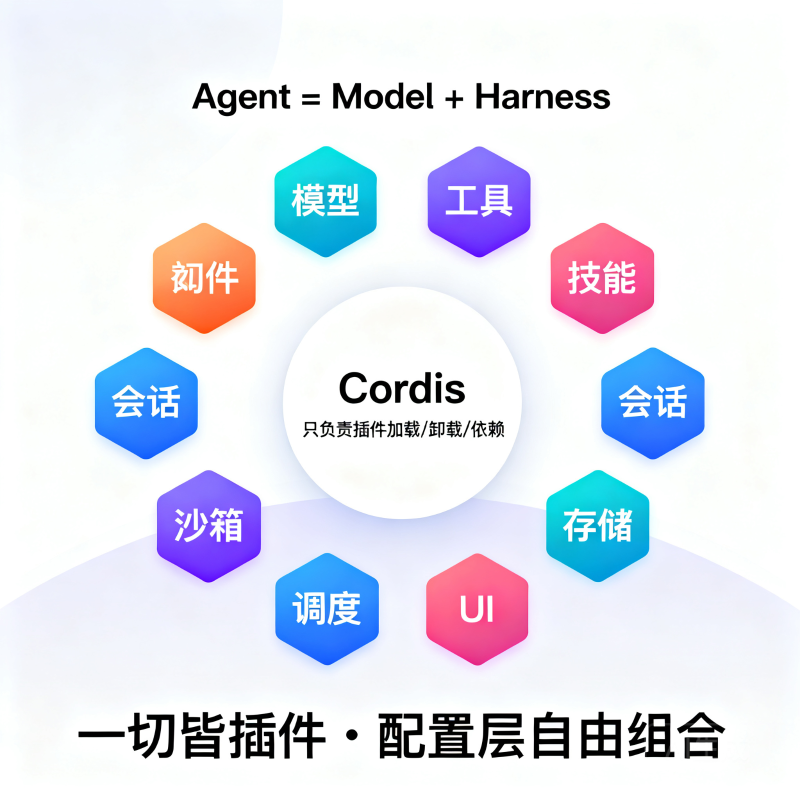
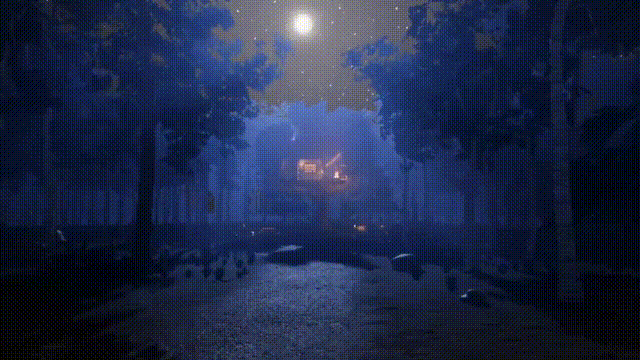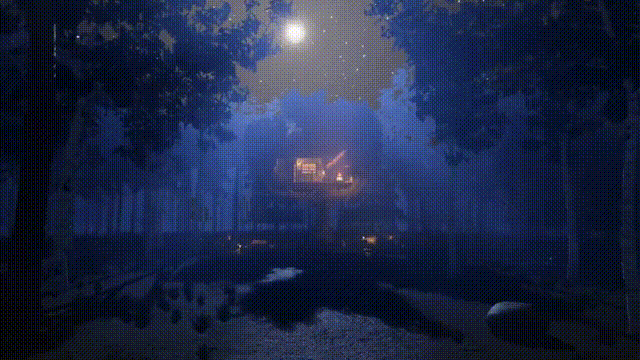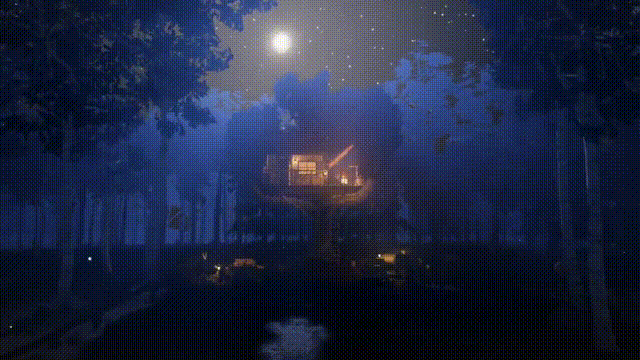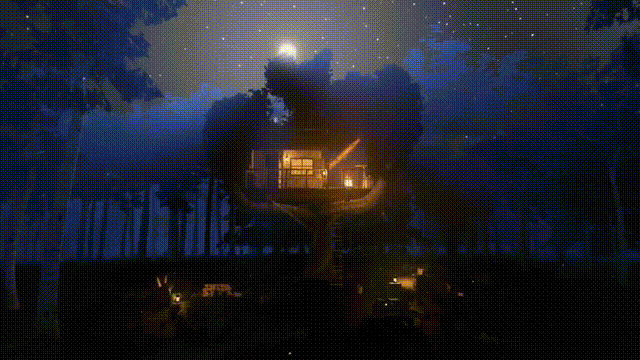
第三组材料把重点放在动态画面、实时交互和游戏引擎级创作。此处尤其容易混淆模型能力与 Harness 能力:模型可能负责生成代码或素材,真正决定能否运行的还包括浏览器、文件系统、沙箱、依赖安装、渲染工具和测试循环。
3. Sol、Astra、Luna、Terra:可能的产品分层
“Sol 低于 Astra、Luna 主打性价比、Terra 可能退出”目前都属于产品线推测,不是 OpenAI 已公开的定价或命名规则。 参考稿采用了一个容易理解的解释框架:
Astra:旗舰级模型,面向复杂推理、软件工程和专业工作;
Sol:假设中的高性价比主力,目标是接近旗舰质量,同时降低延迟与调用成本;
Luna:延续轻量、快速、价格敏感路线;
Terra:可能被新一代命名体系替代。
这个框架可以帮助团队提前设计路由策略,但不能用来提前写死采购承诺。真正上线时,应该通过配置中心管理模型 ID、价格和回退关系,并保留旧版本的可重放评测集。
4. Noam Brown 访谈真正透露了什么
The Information 的访谈更像一张“能力增长与安全风险地图”,而不是 GPT-6 Sol 的发布说明。 页面显示,这期节目讨论了 AI Agent、强化学习、研究自动化、模型协作和思维链监控等主题。
其中最值得开发者关注的是四个方向:
递归自我改进(RSI):如果模型能够帮助生成数据、设计实验、改进训练流程,模型迭代会从单纯增加算力转向“模型参与模型研发”。
预训练与强化学习的乘数效应:更强的底座模型,可能让 RL 的收益被放大;但这需要公开实验设置,不能用一句“10×10=100”代替证据。
研究直觉与验证瓶颈:模型生成候选证明和实验方案的速度可能超过人类审核速度,瓶颈会转向复核、可重复性和责任归属。
思维链与多 Agent 监控:当多个 Agent 在沙箱里协作时,系统必须记录工具调用、上下文注入、权限变化和失败恢复,而不只是保存最终答案。
这些议题解释了为什么 Sol 的讨论会和“Agent 时代”绑定在一起:开发者期待的不只是更聪明的聊天模型,而是能在代码、浏览器、数据和工具之间持续工作的系统。
5. 评测 Sol,必须把模型和 Harness 分开
公平评测的最小单位不是一张榜单,而是一套固定 Harness 下的重复任务。 建议把同一模型放入同一套工具和权限中,至少执行以下六类任务:
陌生仓库理解:是否准确找到入口、依赖和测试位置;
跨文件小功能:记录一次通过率、无关 diff、人工提示次数和总 token;
失败测试修复:观察读取错误、缩小范围、修改和复跑是否闭环;
前端与视觉任务:固定浏览器、截图尺寸、素材和验收标准;
并行研究:检查子 Agent 是否隔离上下文,主 Agent 是否复核结果;
中断恢复:记录网络失败、工具异常或重启后的重复副作用。
建议至少保留四项指标:成功率、验证通过率、单位任务成本、人工接管时间。若 Sol 的优势只在某一种提示词或某个演示任务中出现,就不能直接外推到生产环境。
6. API 与上线前检查
在 GPT-6 Sol 获得官方状态前,生产系统应按“可替换模型”设计,而不是把传闻中的模型 ID 写死。
用环境变量或配置中心管理模型名称、provider、推理强度和回退模型;
记录每次请求的模型返回值、工具调用、token、错误码和计费信息;
为 Shell、文件、浏览器和 MCP 设置 allowlist、超时、预算和人工审批;
把模型版本、Harness 版本、提示词和测试集绑定保存;
价格、配额、地区可用性和数据保留以 OpenAI 官方页面当天状态为准。
七牛云 AI 大模型广场提供多模型统一接入和模型对比页面,可作为模型入口候选;具体模型名称、可用性和计费仍应以控制台和官方文档为准。
结论:真正的看点,不只是 Sol 是否更便宜
GPT-6 Sol 的讨论之所以迅速升温,是因为它同时踩中了三个期待:旗舰级质量、可承受的调用成本,以及能在 Agent 工作流中持续执行。现阶段,视频和 X 帖子提供了值得跟踪的线索,OpenAI 官方文档则提供了可以落地的 API、Agents、沙箱和评测边界。
如果 Sol 后续正式公开,最先需要验证的不是宣传语,而是稳定模型 ID、真实价格、工具调用兼容性、上下文限制、失败恢复和可重复评测结果。本文数据截至 2026 年 9 月 16 日,未被官方页面确认的 GPT-6 Sol 规格均不视为已发布事实。
参考资料
OpenAI API 模型指导:https://developers.openai.com/api/docs/guides/latest-model
OpenAI Agents 文档:https://developers.openai.com/api/docs/guides/agents
OpenAI Codex 文档:https://developers.openai.com/codex/
OpenAI Agents SDK Python:https://openai.github.io/openai-agents-python/
The Information AI Deep Dive(YouTube,2026-09-14):https://www.youtube.com/watch?v=fqcy0xQATq0
七牛云 AI 大模型广场:https://www.qiniu.com/ai/models