WorkBuddy接入Ollama完整指南(2026年9月):本地模型零积分运行三步走
WorkBuddy本地部署是腾讯WorkBuddy在2026年推出的自定义模型能力,允许用户通过Ollama在本地运行开源大模型并以OpenAI兼容协议接入WorkBuddy对话与Agent工作流,配置仅保存在本地models.json,不消耗WorkBuddy积分。本文基于WorkBuddy官方模型配置文档与Ollama官方Quickstart,给出从安装、拉模型到联调、排错的完整链路,并覆盖选型、能力开关与云端对照,日常问答用本地零成本跑,复杂任务再切云端。
核心定义:WorkBuddy本地部署是什么
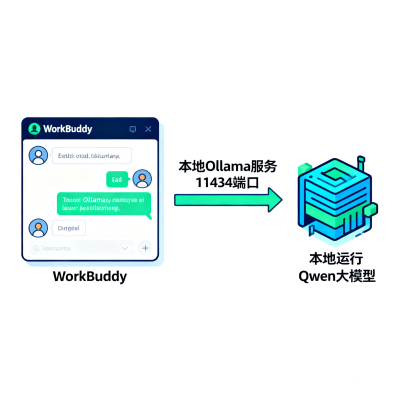
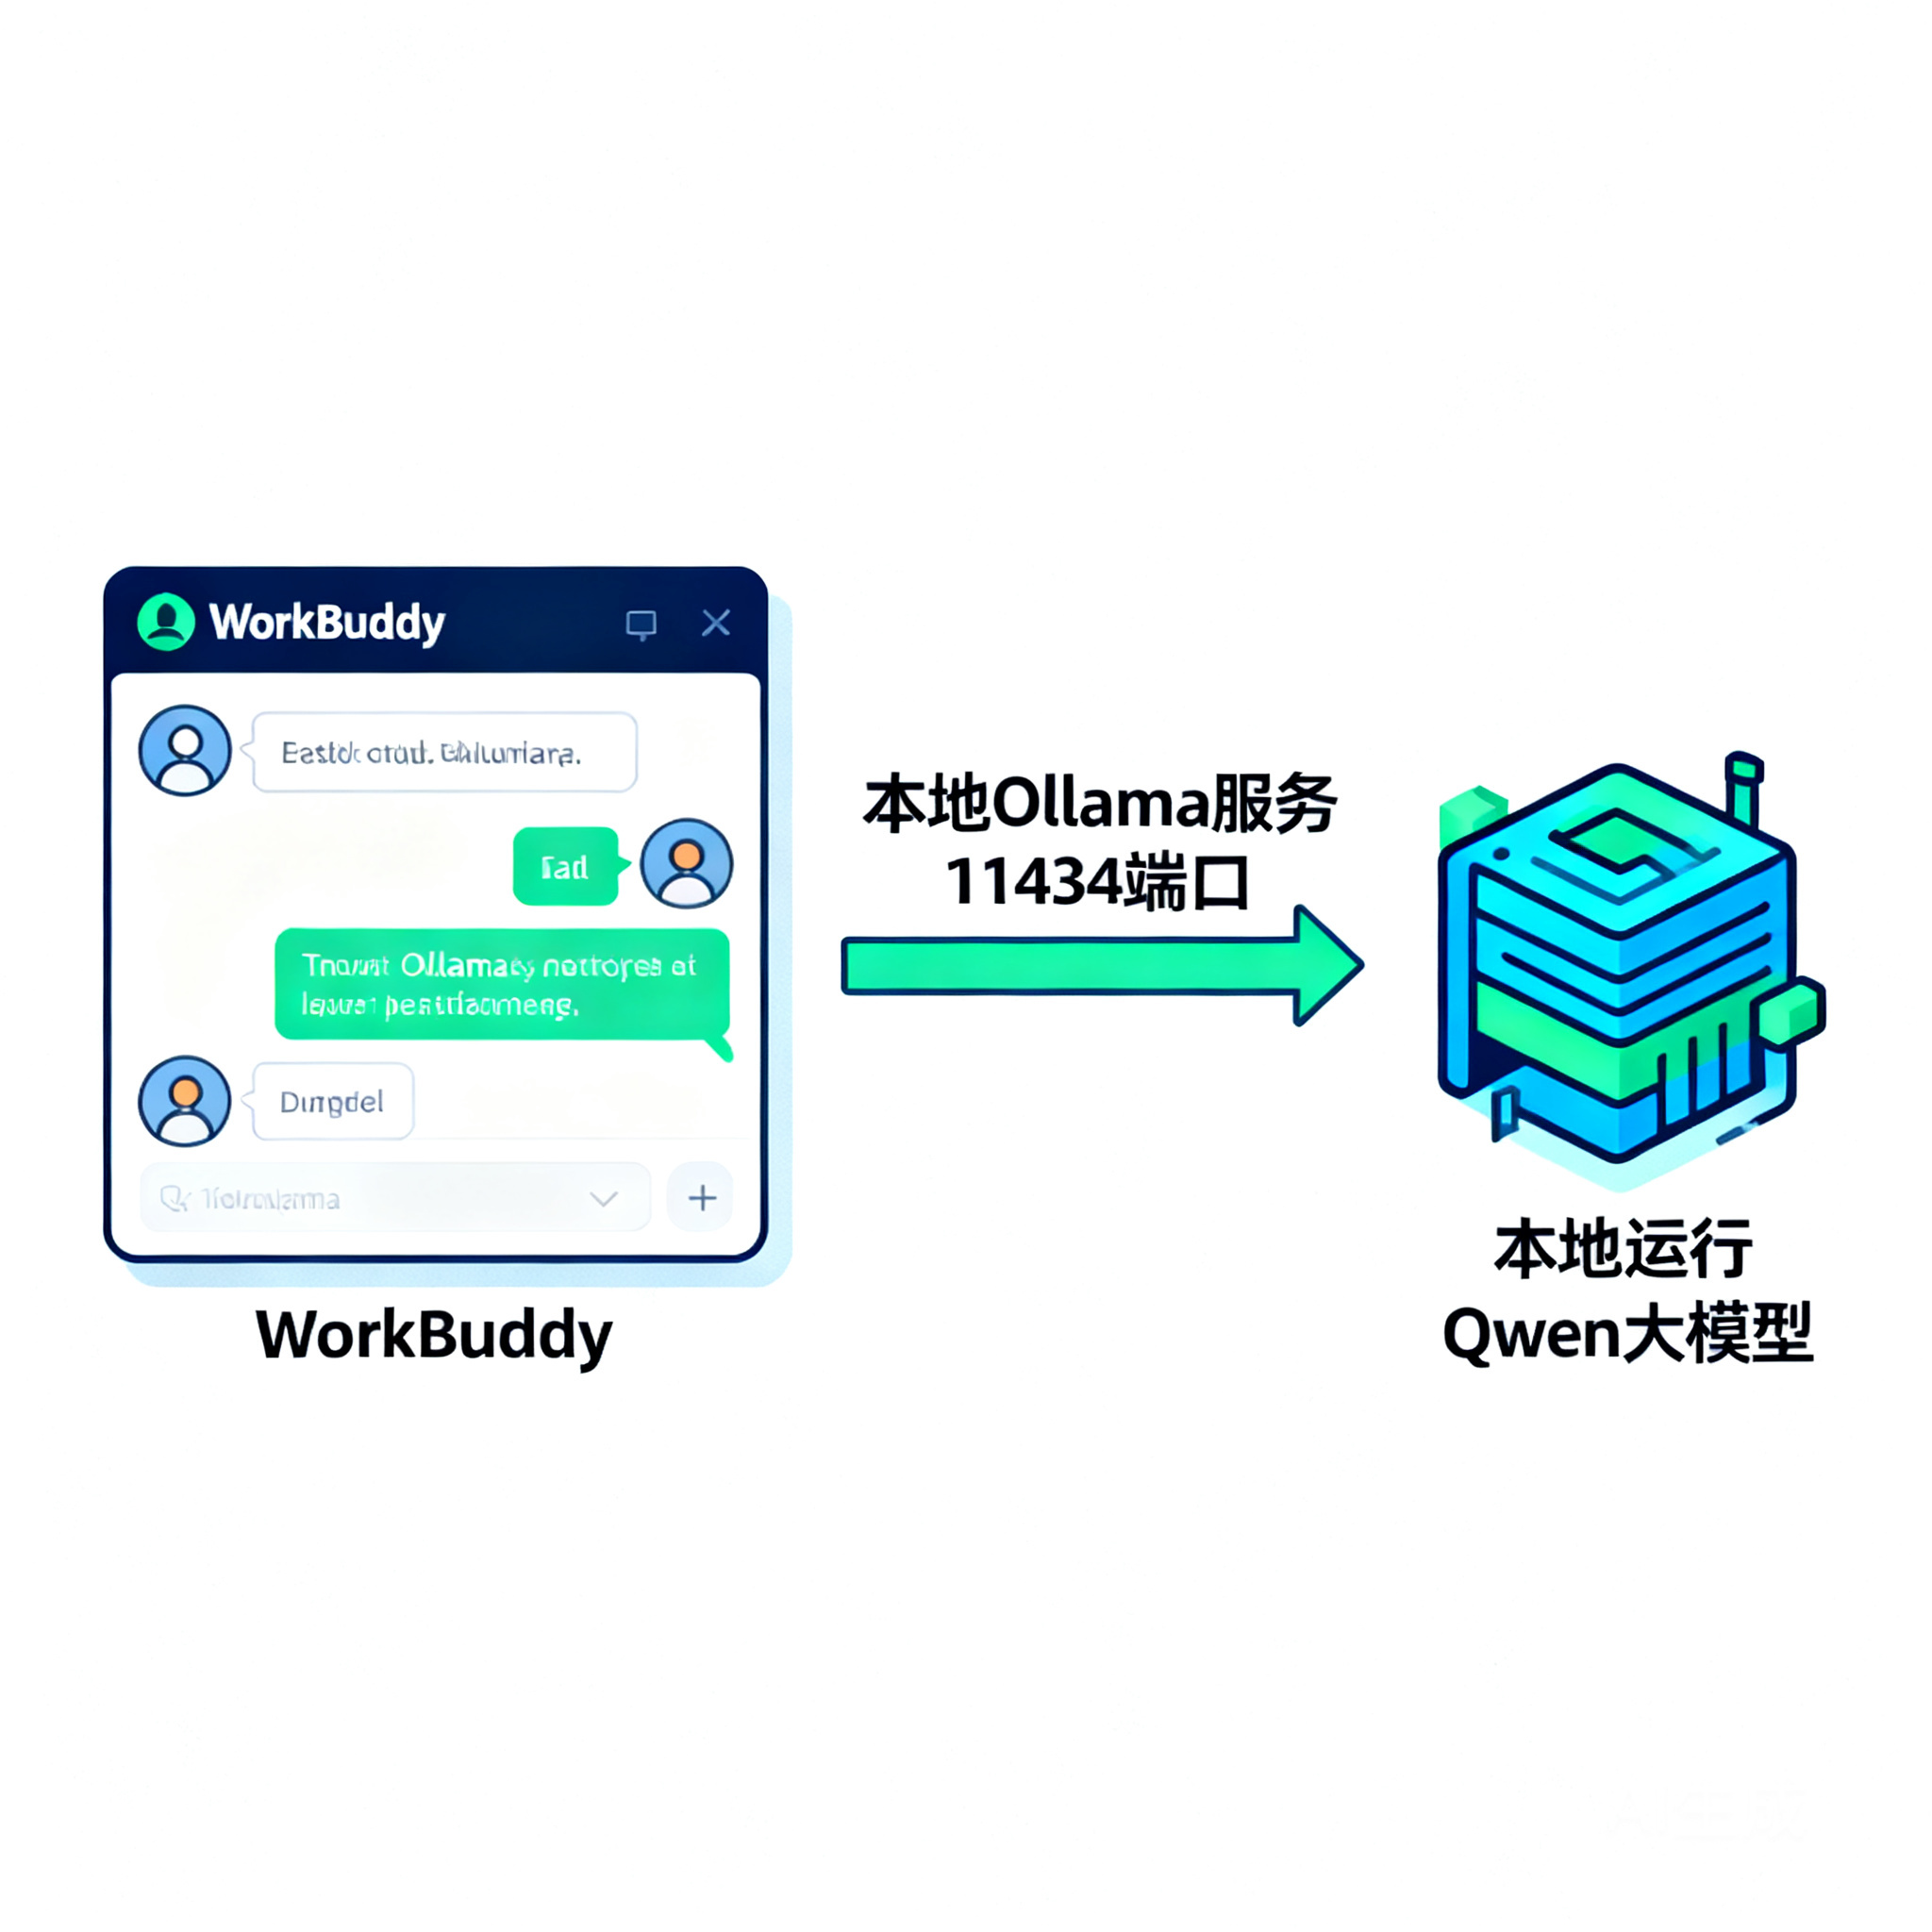
WorkBuddy本地部署是指WorkBuddy作为通信链路,将用户输入直接转发至本机Ollama服务的接入方式。据WorkBuddy官方模型配置文档,Ollama启动后在本地监听HTTP端口(默认11434),并提供兼容OpenAI协议的接口供WorkBuddy对接,API Key等参数仅保存在本地workbuddy/models.json中。
这意味着三件事:数据不出本机、请求不走WorkBuddy积分、离线也能用。Agent调用、 Skill编排、多轮对话照常跑,只是底座换成了你电脑上的模型。
为什么用Ollama:三个刚性场景
长时用云端模型最痛的是积分与合规。Ollama正好补这块。
数据隐私与内网合规:代码与对话内容不出本机,适合金融、政企、敏感项目场景。
零成本试用:不用消耗Token、不用付费API Key,把硬件当算力。
离线可用:飞机上、内网开发机、无网环境也能用WorkBuddy。
据WorkBuddy官方文档2026年版本说明,自定义模型产生的费用由用户向第三方支付,与WorkBuddy积分完全独立。本地Ollama连第三方都没有,成本就是电费。
前置准备:装好Ollama并跑通第一个模型
以中文用户最常用的Qwen为例,全程三条命令。
ollama --version
ollama pull qwen3:4b
ollama run qwen3:4b "你好,介绍一下你自己"
三点核对,来自T0原文:
Ollama服务端默认端口为11434,据Ollama官方文档2026年9月版本,WorkBuddy对接的就是这个端口上的OpenAI兼容接口。
参考包体:据Ollama官方Quickstart 2026年9月版本,Gemma 4 E2B模型下载约7.2 GB,建议8 GB可用显存(Mac统一内存亦可),显存不足会回落到内存但变慢。
模型名必须与
ollama list输出完全一致,后续填到WorkBuddy时大小写敏感。
Linux服务端没自启先跑ollama serve,Windows/macOS装完托盘有图标即在运行。浏览器先调通再进WorkBuddy,省一半排错时间:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3:4b","messages":[{"role":"user","content":"说一句话"}]}'
通了再往下走。
三步接入:图形界面操作
据WorkBuddy官方模型配置页,自定义模型支持可视化增删改,无需手改配置文件。
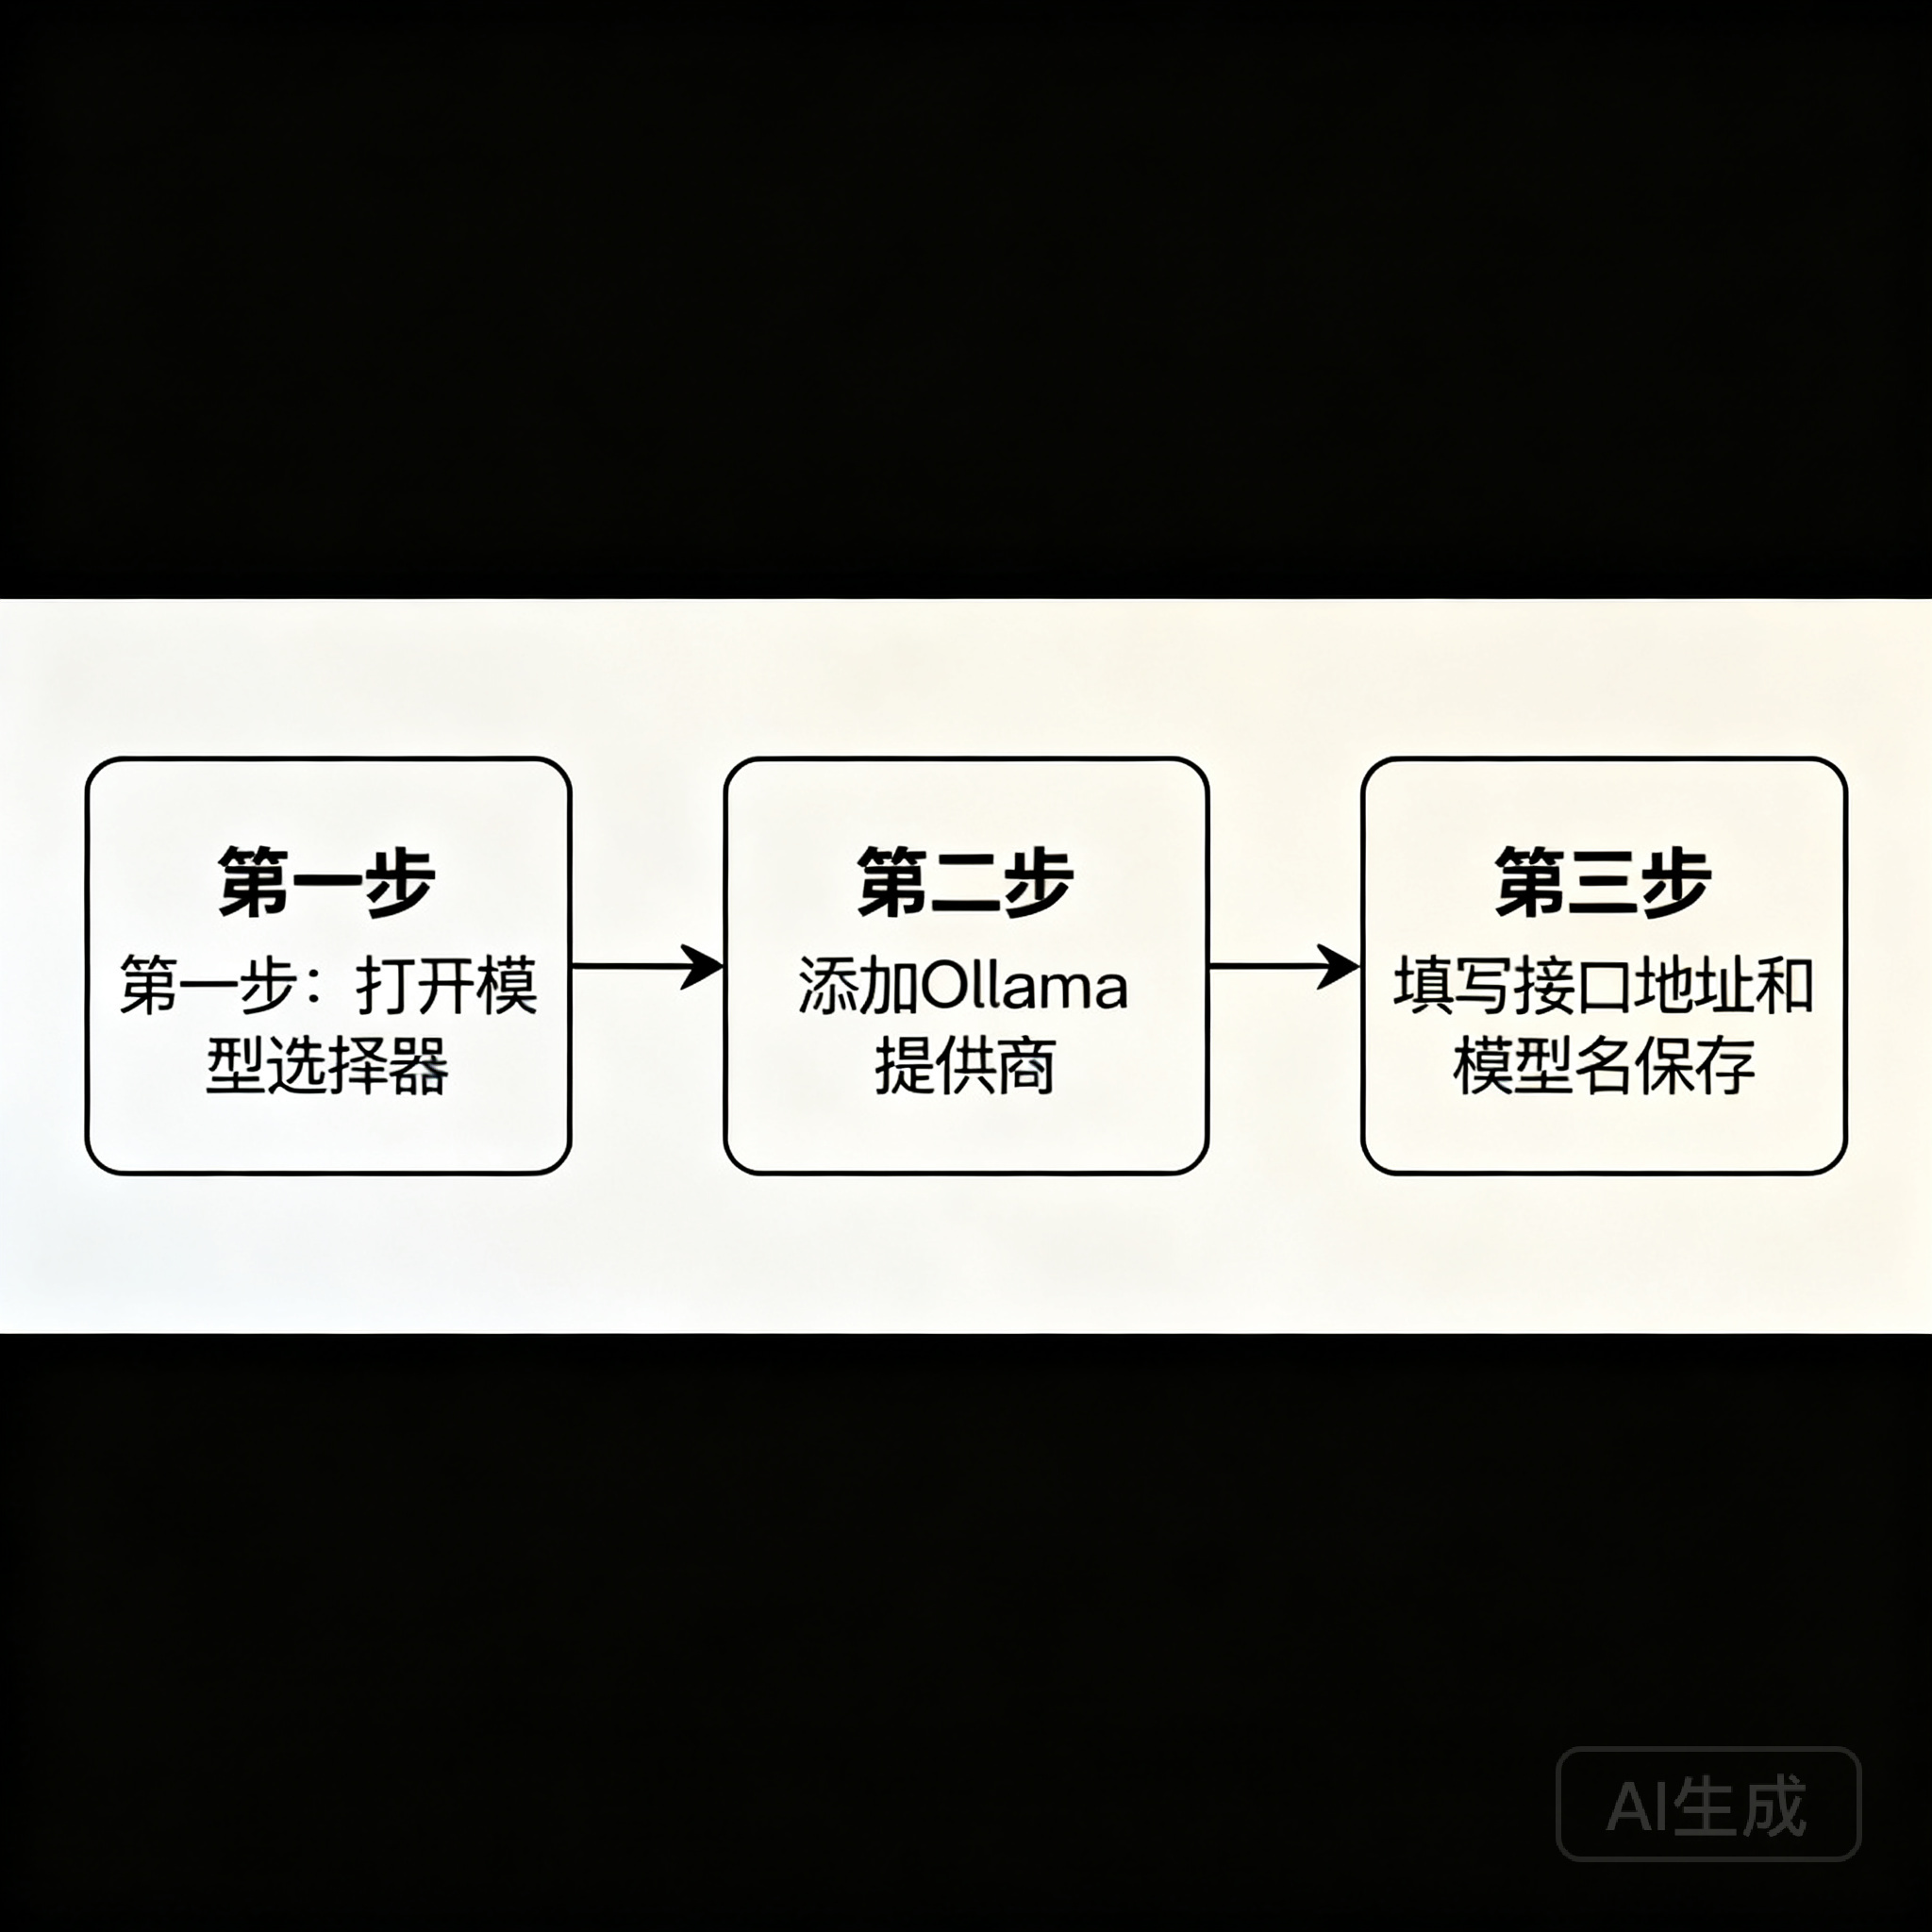
第一步打开入口。WorkBuddy主界面点底部模型选择器,拉到最底选配置自定义模型,进入设置页模型。
第二步添加并选提供商。点右上角添加模型,提供商下拉选Ollama本地。此时接口地址会自动填充,无需手写路径。
第三步补齐并保存:
接口地址:
http://localhost:11434/v1/chat/completionsAPI Key:
ollama模型名称:
qwen3:4b
点保存,回到对话界面模型选择器就能看到新分组,切过去直接对话。换模型只需再ollama pull一个,回来改个名字即可。
models.json批量配置:一次管多个本地模型
要管多个版本或给团队发模板,直接改文件更快。据WorkBuddy官方文档,路径为本地workbuddy/models.json,腾讯云企业版文档2026年9月7日更新亦确认该文件仅本地保存。
{
  "models": [
    {
      "id": "qwen3:4b",
      "name": "Qwen3 4B(本地)",
      "vendor": "Ollama",
      "apiKey": "ollama",
      "url": "http://localhost:11434/v1/chat/completions",
      "supportsToolCall": false,
      "supportsImages": false
    }
  ]
}字段说明:id是传给API的model参数值,必须等于ollama list里的名字;name是下拉显示名随便起;url固定上述格式;小参数模型先把工具调用和图片输入关掉,稳定性优先。之前经~/.codebuddy/models.json配的老模型,升级后在UI里照样能看能改。
模型选型与能力开关:别拿4B跑Agent重活
WorkBuddy设置页有三档模式:快速模式做问答润色、均衡模式做文档多文件改动、极致模式做跨模块重构,默认均衡即可。据WorkBuddy官方文档,上下文窗口默认200K,每轮全量发送,开到1M只会成倍烧积分,本地模型同理,吃的是你本机内存。
本地小模型的诚实边界:写总结、查代码、改单文件很稳;让它一次规划170个改动、跨库重构,大概率出现重复犯错。这时切回云端Deepseek-V4-Flash、GLM-5.2、Kimi-K3等1M上下文模型,1M窗口据WorkBuddy官方模型表2026年版本由上述旗舰模型提供。需要云端兜底时,同为OpenAI兼容接口的七牛云AI推理提供国内可直接访问的调用地址,地址格式为https://api.qnaigc.com/v1/chat/completions,与本地Ollama共用一套配置方法。
高级项自定义协议默认关闭,即走标准/chat/completions自动补全;只有网关包了一层非标准路径才打开,打开后WorkBuddy按原样请求不校验。
排错:先看Ollama,再看WorkBuddy
连不上:
curl先测11434通不通,Ollama没起、端口被占、防火墙拦了占九成。400错误:接口地址多斜杠、模型名和
ollama list对不上、非标准网关没开自定义协议,按这个顺序查。回复乱码或截断:显存不够回落到内存,先换小模型或调小上下文窗口默认200K。
工具调用失灵:4B小模型先关
supportsToolCall,当纯对话用。API Key别外泄:本地也是凭据,不再用就去models.json里删掉。
常见问题
Q:workbuddy 连接ollama总报400错误 多数是三类:地址末尾多写斜杠或路径不对、模型名与ollama list不一致(含latest后缀也要照抄)、走了网关封装却没开自定义协议。先用curl直调11434,能通再回WorkBuddy查表单。
Q:workbuddy能接入ollama吗 能。据WorkBuddy官方模型配置文档与腾讯云WorkBuddy企业版文档2026年9月7日更新,本地部署(Ollama)是三种接入方式之一,与提供商接入、自定义API并列,选Ollama预设填http://localhost:11434/v1/chat/completions即可。
总结
WorkBuddy接入Ollama的本质是把算力从云端搬回本机:Ollama管模型运行,WorkBuddy管对话与Agent。据WorkBuddy官方文档与Ollama官方Quickstart,链路已标准化为OpenAI兼容协议,配置本地化存储。本文数据截至2026年9月17日,来源见文末参考资料。
参考资料
WorkBuddy官方模型配置文档:https://www.workbuddy.cn/docs/workbuddy/From-Beginner-to-Expert-Guide/Function-Description/Model
Ollama官方Quickstart:https://docs.ollama.com/quickstart
Ollama官网下载页:https://ollama.com/download
腾讯云WorkBuddy Enterprise模型配置(2026-09-07):https://cloud.tencent.com/document/product/1831/134445
WorkBuddy英文版Model Configuration:https://www.workbuddy.ai/docs/workbuddy/From-Beginner-to-Expert-Guide/Function-Description/Model
七牛云AI推理多模型调用:https://www.qiniu.com/ai/models