Qwen-Image-2.1 开源:7B 生图模型评测超过 Nano Banana 2.0,透明图与 10 张参考图一步到位
发布日期:2026-09-21|资料口径:千问官方 GitHub 与 Hugging Face 模型卡、IT之家、机器之心、快科技等 9 月 20 至 21 日报道|目标读者:设计师、电商运营、AIGC 开发者
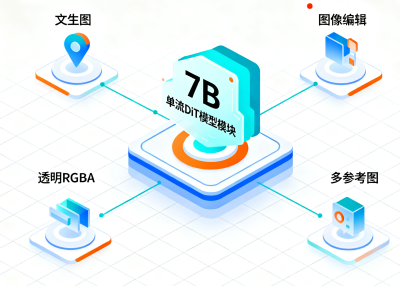
Qwen-Image-2.1 是阿里巴巴千问团队于 2026 年 9 月 20 日开源的图像生成与编辑一体化模型,视觉生成部分仅 7B 参数,原生支持 2K 分辨率输出、透明(RGBA)图像生成以及最多 10 张参考图的多主体编辑。官方公布的 Qwen-Image-Bench 评测中,它以 60.28 的总分登顶开源模型第一,并超过闭源的 Nano Banana 2.0(59.82)与 GPT Image 1.5(59.65)。这一版本把 2025 年 12 月单独发布的 Qwen-Image-Layered 透明图能力并入通用模型,用混合粒度注意力和 KV Cache 复用降低多图输入成本,并在发布当天获得 Diffusers、ComfyUI、vLLM-Omni、SGLang 等推理框架的 Day 0 支持。对设计、电商和内容创作团队来说,它意味着一张显卡上同时完成海报生成、商品换场景、抠图出透明素材与多人合影这类过去需要多个工具串联的工作。
9 月 20 日发布了什么:四项核心升级
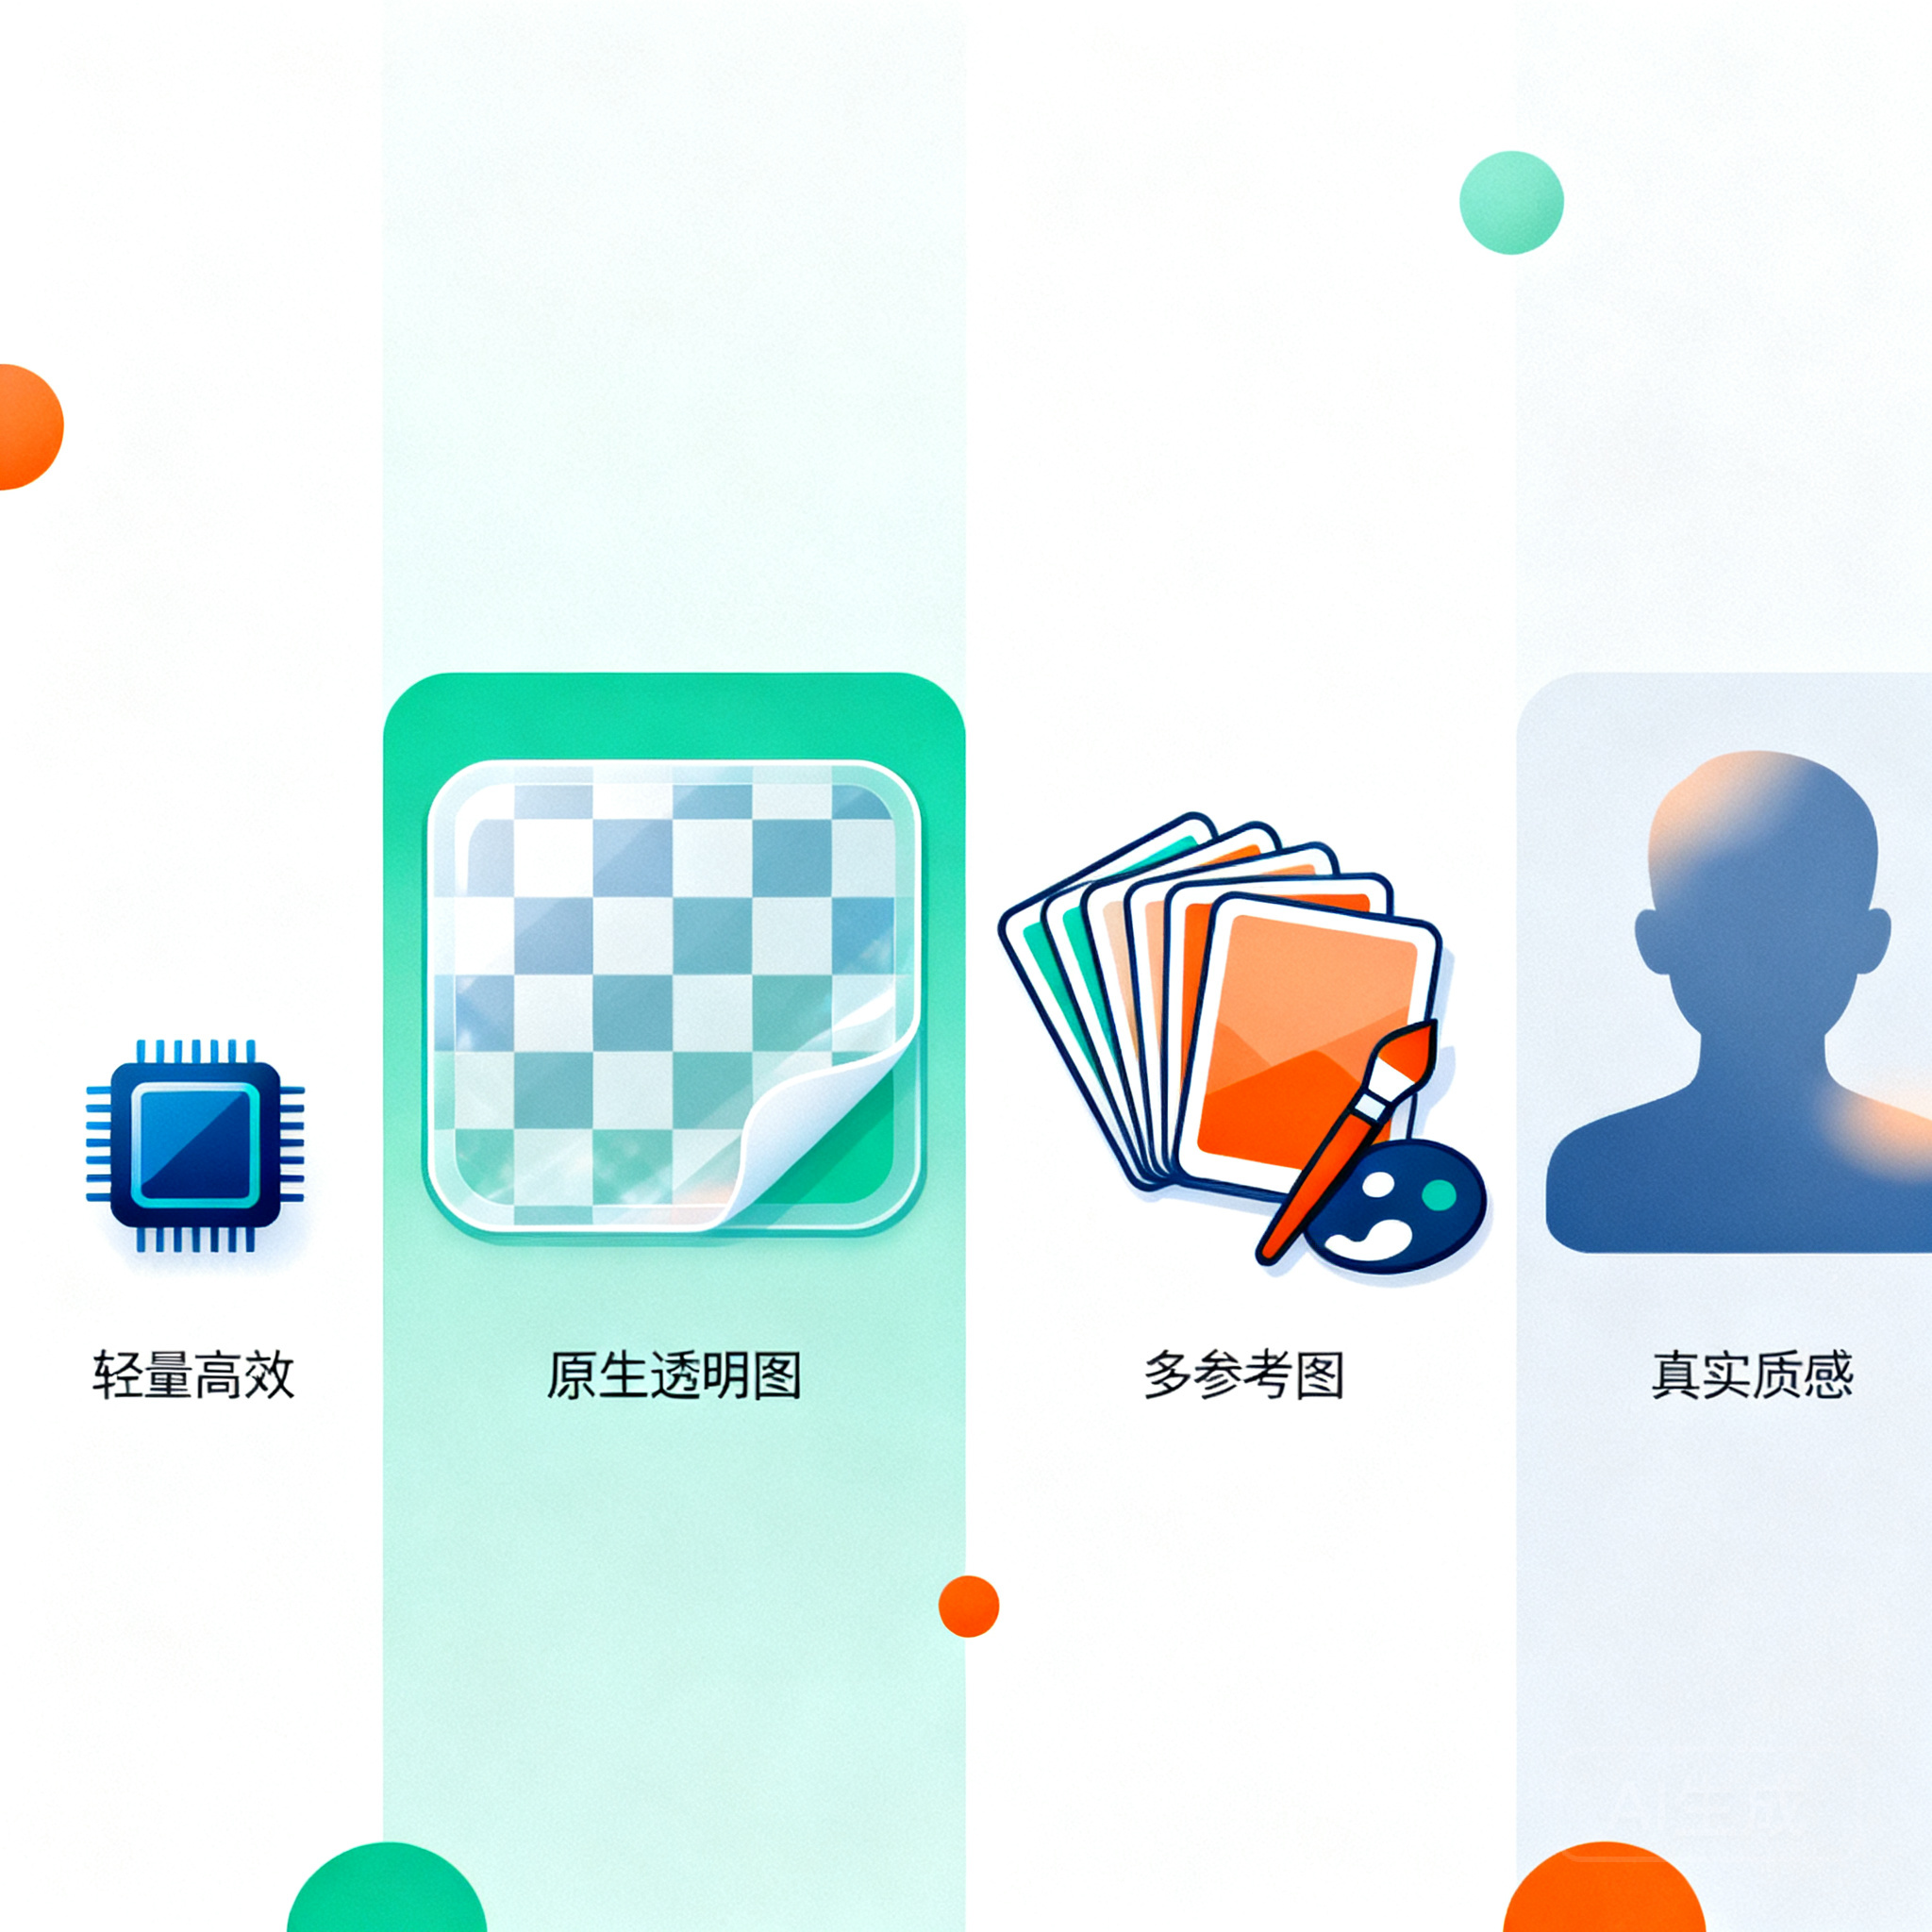
这次更新的四个关键词是小模强效、原生透明、全能编辑和真实质感。 按官方 GitHub 仓库的表述,具体包括:
小模强效:视觉生成部分为 32 层 Single-Stream DiT,7B 参数;算上 Qwen3-VL 8B 文本编码器,整条管线约 16.22B 参数。轻量结构配合推理优化,在较低算力成本下保持生成质量。
原生透明:模型根据提示词自行判断输出普通 RGB 图还是带 Alpha 通道的 RGBA 图,不需要单独的抠图步骤。给一张真实照片,也能把主体直接提取成透明图层,绕开发丝边缘这类传统抠图难点。
全能编辑:参考图上限提高到 10 张;局部编辑支持圈选、涂抹和独立蒙版三种方式,一次可指定多个区域分别修改;人物面部与商品的文字、材质、形状在换场景后保持一致。
真实质感:文字渲染更注重字体、排版与整体协调,人像光影和细节得到加强,同时覆盖全景图、信息图、三视图和分镜等生产力场景。
发布当天,沐曦等国产算力厂商宣布完成 Day 0 适配,Diffusers 通过新增的 QwenImage21Pipeline 直接支持,ComfyUI 也同步提供文生图与图像编辑两套示例工作流。
7B 参数如何在评测中超过闭源模型
Qwen-Image-2.1 的效率来自两项结构设计:混合粒度注意力与前缀 KV Cache 复用。
混合粒度注意力指文本部分(系统前缀、编辑指令)使用 token 级因果掩码,而图像生成部分使用 chunk 级掩码,让模型在不同模态上用不同粒度分配注意力。前缀 KV Cache 复用则是把参考图和编辑指令这类静态上下文在第一步就预计算并缓存,后续去噪步骤直接复用。官方说明这项优化在多图输入时收益更明显,实际节省幅度取决于硬件、精度、分辨率与输入图数量。
评测结果如下(数据来源:千问官方 Qwen-Image-Bench,2026 年 9 月):
需要说明的是,Qwen-Image-Bench 由千问团队自建并公开,三个模型的分差不足 1 分。它说明 7B 规模的开源模型已进入与顶级闭源产品同一梯队,但不等于在所有任务上全面领先。
和 Qwen-Image 2.0、2512、Layered 是什么关系
Qwen-Image-2.1 是对前三个版本能力的收敛,而不是简单的参数放大。 千问图像系列的演进脉络如下:
从 8 月的 20B 到 9 月的 7B 视觉生成部分,参数规模缩小的同时把编辑与透明图两条独立产品线合并,这是开源生图模型在 2026 年从"堆参数"转向"做整合"的一个典型样本。
怎么在本地跑起来
Qwen-Image-2.1 通过 Diffusers 的 QwenImage21Pipeline 调用,文生图、单图编辑、多图合成和透明图生成共用同一个 pipeline。
环境要求按官方仓库:
pip install torch>=2.4.0
pip install transformers>=5.17
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
文生图示例,默认 40 步去噪、2048×2048 输出:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="A neon shop sign that reads \"QWEN IMAGE 2.1\", rainy night",
    width=2048, height=2048,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("t2i_example.png")
生成透明图时,官方建议使用固定的提示词模板,模型据此决定输出 RGBA:
image = pipe(
    prompt="This is an RGBA image with transparency. A cute cartoon dragon sticker. "
           "The image has alpha channel and the background is transparent.",
    num_inference_steps=40,
).images[0]
image.save("transparent_example.png")
多参考图合成只需把 image 参数改为列表,最多传 10 张:
from PIL import Image

images = [Image.open(f"ref_{i}.png") for i in range(3)]
result = pipe(
    prompt="These three characters are sitting around a campfire in a forest",
    image=images,
    num_inference_steps=40,
).images[0]
显存不足时调用 pipe.enable_model_cpu_offload() 做 CPU 卸载。官方还提供两个基于 Qwen3.5-VL 9B 微调的提示词改写模型(PE-T2I 与 PE-I2I),能把任意语言的简短需求扩写成详细英文提示词并推荐宽高比。不想自建显卡环境的团队,也可以通过多模型统一接入平台按需调用图像生成模型,例如七牛云 AI 大模型广场支持在图像生成场景下按需切换不同模型。
适合哪些场景,谁应该关注
Qwen-Image-2.1 最直接的受益者是需要批量产出带文字、可编辑、可抠图素材的设计与电商团队。 官方演示和媒体报道中出现的场景包括:
电商商品图:5 张图(模特、服装、鞋、包、帽)合成完整穿搭;商品换背景后包装文字与材质保持不变。
海报与信息图:文字排版渲染是该系列一贯强项,2.1 进一步优化字体协调与文字密集页面。
透明素材生产:贴纸、图标、UI 元素直接输出 RGBA,透明图层内的文字和表情可继续编辑。
多人合影与虚拟场景:从 6 张单人肖像合成一张合影;7 张参考图(人物、房间、家具)拼出一套室内布局。
视觉规划:分镜、三视图、全景图,适合游戏与影视前期。
对开发者而言,Qwen Research License 意味着研究用途开放,商业部署前需核对协议条款。对国产算力用户,沐曦已完成 Day 0 适配,vLLM-Omni 与 SGLang 分别支持 FP8 量化、前缀缓存与多种并行策略。
常见问题
Q:Qwen-Image-2.1 能生成中文文字吗?
可以。中文文字渲染是千问图像系列从 2025 年 8 月首版起就主打的能力,2.1 版进一步优化了字体、排版与文字密集页面的协调度。官方 Quick Start 示例使用英文提示词,但提示词改写模型 PE-T2I 支持任意语言输入。
Q:Qwen-Image-2.1 需要多大显存?
官方仓库未给出具体显存数字,默认配置为 bfloat16 精度、2048×2048 分辨率、40 步去噪,并提供 CPU 卸载选项。vLLM-Omni 和 SGLang 的 FP8 量化路径可进一步降低占用。[数据待核实:建议参考社区实测的 A100 / 4090 显存占用]
Q:Qwen-Image-2.1 和 Nano Banana 2.0 谁更好?
在千问自建的 Qwen-Image-Bench 上,2.1 以 60.28 对 59.82 略胜,差距不到 1 分。前者开源可本地部署并原生输出透明图,后者为闭源服务。是否更好取决于对部署方式、透明图需求与协议的权衡,而非单一分数。
Q:Qwen-Image-2.1 可以商用吗?
模型采用 Qwen Research License Agreement,与 Apache 2.0 不同,商业使用前需阅读协议中的限制条款。生成结果的版权归属也应结合所在地法规判断。
结论
Qwen-Image-2.1 用 7B 视觉生成参数把文生图、编辑与透明图三条产品线合并,并在自建评测上首次让开源模型分数越过两款头部闭源产品。 它的意义不在于某一项指标,而在于生产力场景所需的多参考图、蒙版局部编辑与 RGBA 输出被整合进一个开源权重。
据千问团队官方博客表述,该版本旨在"兼顾生成效果、推理效率与使用成本"。本文内容基于 2026 年 9 月 21 日可访问的官方仓库、模型卡与媒体报道整理,评测数据、框架支持与协议条款可能更新,建议部署前重新核对。
参考资料
Qwen-Image-2.1 官方博客:https://qwen.ai/blog?id=qwen-image-2.1
Qwen-Image-2.1 GitHub 仓库:https://github.com/QwenLM/Qwen-Image-2.1
Qwen-Image-2.1 Hugging Face 模型卡:https://huggingface.co/Qwen/Qwen-Image-2.1
Qwen-Image-Bench 评测集:https://huggingface.co/Qwen/Qwen-Image-Bench
七牛云 AI 大模型广场(图像生成模型接入):https://www.qiniu.com/ai/models