Qwen-Image-2.1 开源部署完整指南:Diffusers、ComfyUI 与推理服务
Qwen-Image-2.1 是 Qwen 团队于 2026 年 9 月 20 日发布的开源统一文生图与图像编辑模型,视觉生成组件为 7B 参数、32 层单流 DiT,并把透明图、局部编辑和多参考图合并到同一条推理链路中。本指南覆盖 Diffusers 本地推理、ComfyUI 工作流和服务化部署,重点说明依赖、尺寸、显存风险与常见排错路径。
1. Qwen-Image-2.1 是什么
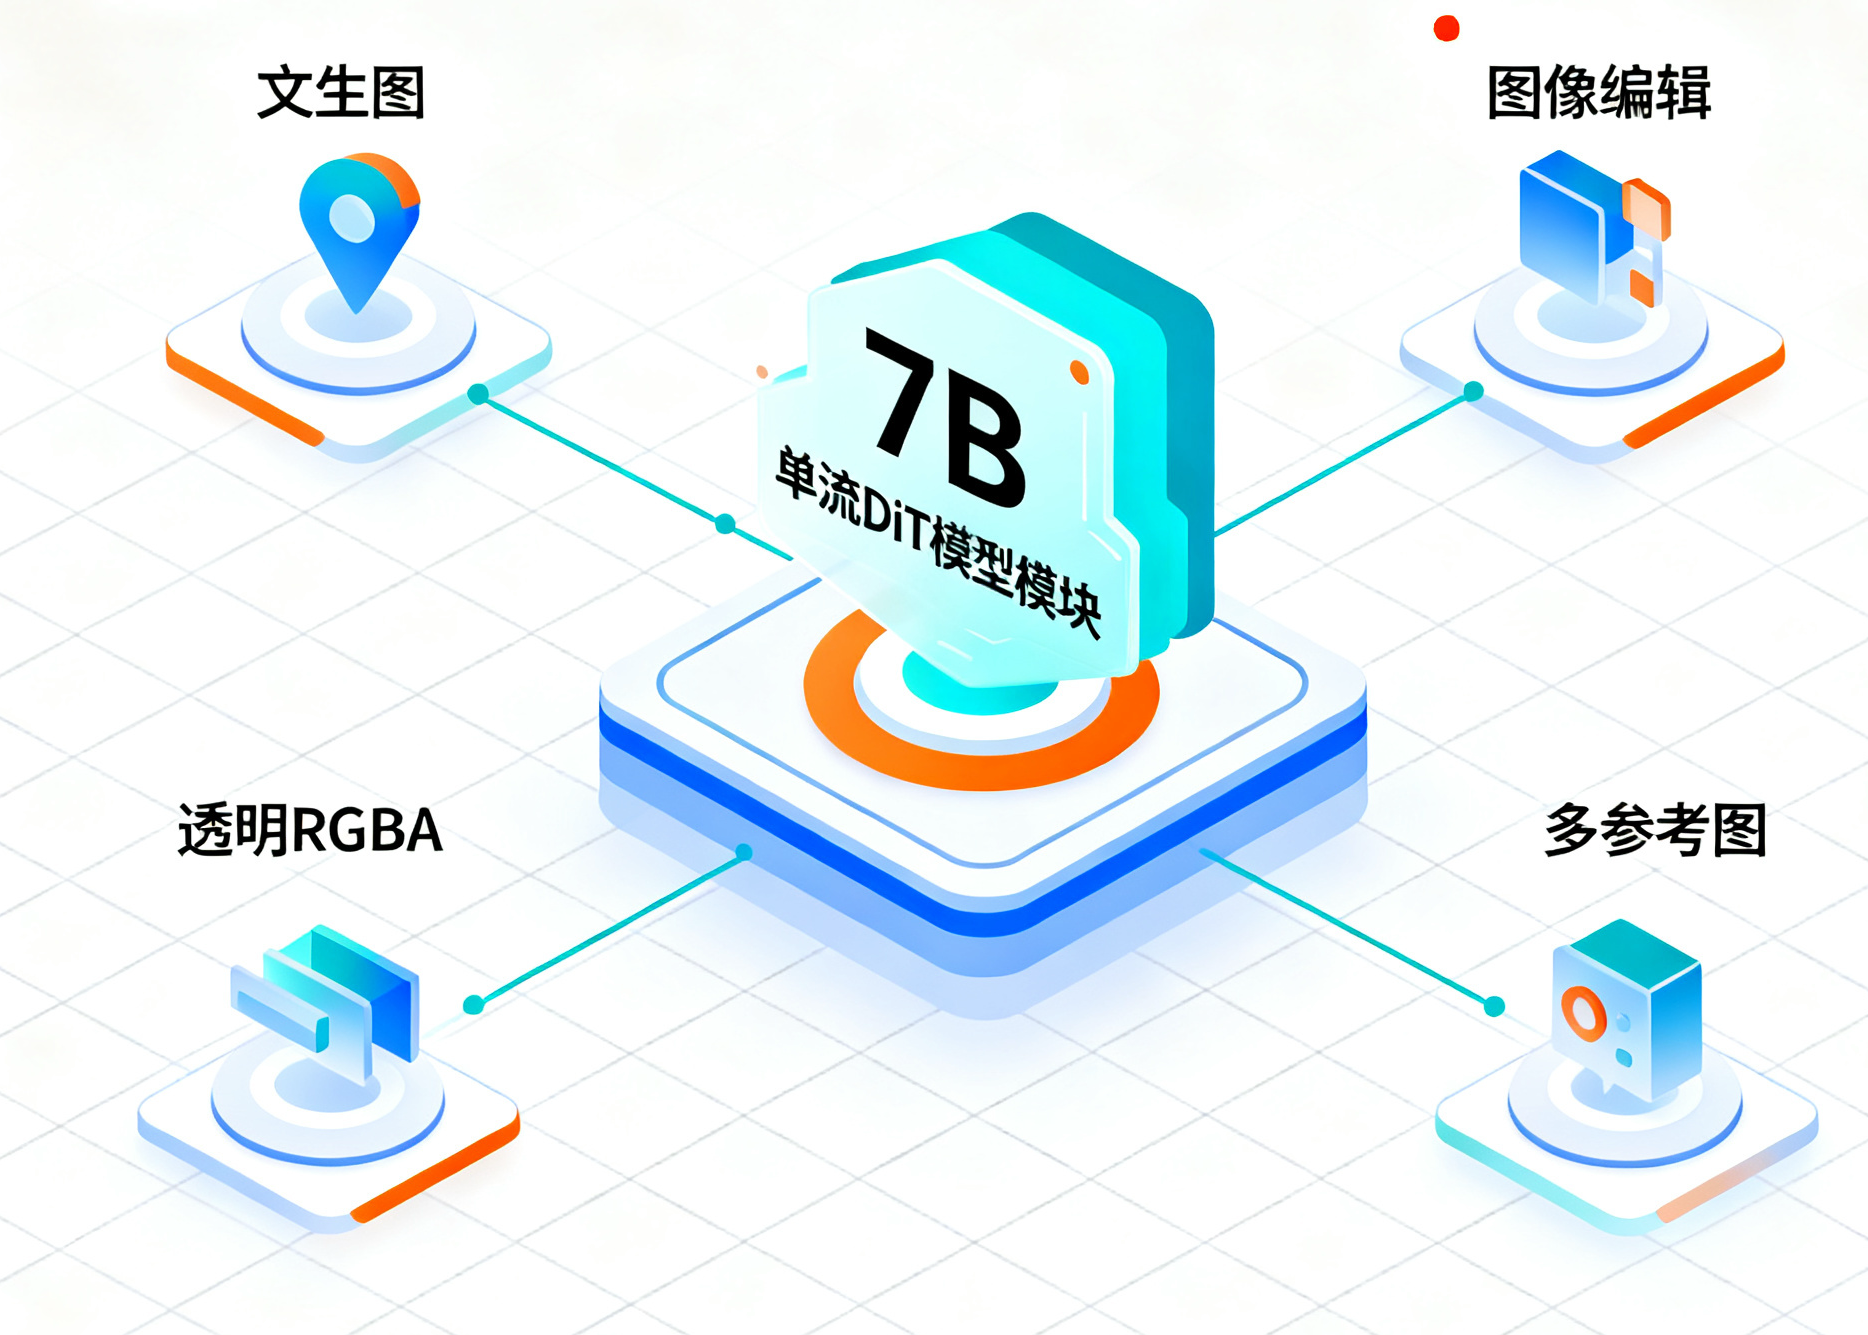
Qwen-Image-2.1 是一个同时支持文本生成图像和图像编辑的 7B 视觉生成模型,官方仓库与 Hugging Face 模型卡提供了相同的基础权重和 QwenImage21Pipeline 接口。
它的关键能力可以概括为:
原生生成 RGBA 透明图,并支持透明图层编辑。
单次编辑最多接收 10 张参考图,适合人物、产品和多主体合成。
原生支持 2K 输出,官方给出了 1:1、16:9、9:16 等 7 组推荐尺寸。
使用混合粒度注意力和 prefix KV cache 复用,降低重复条件编码的成本。
官方 README 给出的可核验数据包括:视觉生成组件 7B 参数、32 个 Single-Stream DiT 层、最多 10 张参考图,以及默认 40 个去噪步数(来源:QwenLM/Qwen-Image-2.1,2026)。这些数字描述的是模型与示例配置,不等同于所有硬件上的最低运行要求。
2. 部署路线怎么选
部署路线应按目标区分:想先验证质量用 Diffusers,想拖拽调参用 ComfyUI,需要并发服务再考虑 vLLM-Omni 或 SGLang。
如果只是确认模型能否运行,先用 2048×2048 以外的较小测试尺寸和较少步数验证环境,再切回官方推荐配置。官方没有发布统一的最低显存数字;bfloat16、CPU offload、量化和并行方式会显著改变实际占用,因此不要把网上的单卡经验值当成硬性门槛。
3. Diffusers 本地部署
3.1 创建环境并安装依赖
官方 Quick Start 要求 PyTorch 2.4.0 及以上、Transformers 5.17 及以上、最新 Diffusers、Accelerate 和 Pillow;在 shell 中应给带比较符号的包名加引号,避免被重定向解析。
python -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
pip install 'torch>=2.4.0'
pip install 'transformers>=5.17'
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
首次下载权重需要能够访问 Hugging Face,模型标识为 Qwen/Qwen-Image-2.1。若运行环境无法访问该站点,可先在可联网机器下载模型,再通过本地路径传给 from_pretrained;不要把未经核验的第三方权重混入生产目录。
3.2 最小文生图脚本
下面的脚本对应官方示例,随机种子固定为 42,便于比较参数变化。
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16,
).to("cuda")

image = pipe(
    prompt='A neon shop sign that reads "QWEN IMAGE 2.1", rainy night, reflections on wet pavement',
    width=2048,
    height=2048,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("qwen21-t2i.png")
num_inference_steps=40 是官方默认示例值;调低它可以用于快速冒烟测试,但画面细节和文字稳定性可能变化。显存不足时,先把管线保持在 CPU,再启用模型级 offload:
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()
3.3 图像编辑与透明图
图像编辑只需把输入图传给 image 参数;多图编辑可传入图片列表,官方上限为 10 张。
from PIL import Image

input_image = Image.open("input.png")
edited = pipe(
    prompt="Change the background to a sunset beach",
    image=input_image,
    num_inference_steps=40,
).images[0]
edited.save("edited.png")
生成透明图时,提示词应明确说明 RGBA、透明背景和 alpha 通道,否则输出可能仍是普通背景图:
transparent = pipe(
    prompt=(
        "This is an RGBA image with transparency. A cute cartoon dragon sticker. "
        "The image has alpha channel and the background is transparent."
    ),
    width=2048,
    height=2048,
    num_inference_steps=40,
).images[0]
transparent.save("dragon-sticker.png")
4. 分辨率、提示词与提示词重写
分辨率应从官方推荐表中选择,避免只改宽高而破坏显存预算或构图比例。
短提示词可以直接运行,但官方还提供两个提示词重写权重:Qwen/Qwen-Image-2.1-PE-T2I 用于文生图,Qwen/Qwen-Image-2.1-PE-I2I 用于图像编辑。它们基于 Qwen3.5-VL 9B,可先把短描述扩展成长提示词,再送入主生成管线。重写器的本地脚本支持 --task t2i 与 --task edit,批量任务可使用 vLLM 服务。
5. ComfyUI 与服务化部署
ComfyUI 从发布当天起提供原生支持,官方兼容权重位于 Comfy-Org/Qwen-Image-2.1,并提供文生图和图像编辑工作流模板。导入工作流后,优先确认模型节点、文本编码器和 VAE 的版本来自同一套模板,再逐步替换提示词和参考图。
需要 HTTP 服务时,官方列出的 vLLM-Omni 能力包括 prefix caching、CUDA Graph decode、FP8 量化和张量并行;SGLang 还提供 Cache-DiT、CUDA Graph、TP/Ulysses/Ring/CFG 并行及组件 offload。服务上线前至少记录首图延迟、连续 10 次请求的显存峰值、队列等待时间和失败重试率。对于国内可直接访问的推理服务,也可以用标准 SDK 先验证提示词与业务流程,例如七牛云 AI 的多模型接口适合作为外部推理对照,但文章中的本地权重和服务端权重仍应分别做版本管理。
6. 常见问题与排错
Q:为什么 QwenImage21Pipeline 导入失败?
通常是 Diffusers 版本过旧。按官方要求从 GitHub 安装最新 Diffusers,并重启当前 Python 环境;同时确认导入名的大小写完全一致。
Q:没有足够显存时应该先改什么?
先启用 enable_model_cpu_offload(),再降低测试分辨率和步数;不要直接删除模型组件。正式性能评估时再恢复官方尺寸并记录峰值显存。
Q:透明图为什么出现灰色或白色背景?
检查提示词是否同时包含 RGBA、alpha channel 和 transparent background,并确认保存格式为 PNG。JPEG 不保存透明通道。
Q:可以直接使用第三方 GGUF 或量化权重吗?
可以作为实验分支,但应核对其基座是否确实为 Qwen/Qwen-Image-2.1、量化工具链是否支持对应组件,并单独验证画质、文字渲染和许可证;生产环境优先使用官方权重或官方明确兼容的发行版。
Q:模型许可证是什么?
官方模型卡标注为 Qwen Research License Agreement。商业部署前应阅读仓库中的 LICENSE,确认用途、再分发和衍生权重条款,不要仅依据“开源”三个字判断可商用性。
7. 部署检查清单
锁定 Python、PyTorch、Transformers、Diffusers 的版本并保存安装清单。
用固定种子、固定提示词和固定尺寸完成一次基线生成。
分别测试文生图、单图编辑、多参考图和 RGBA 输出。
记录分辨率、步数、首图延迟、显存峰值和失败重试率。
生产服务中缓存模型权重,限制输入尺寸,并对输出 PNG 做格式校验。
复核 Qwen Research License Agreement 和所有第三方节点、量化权重的许可证。
Qwen 官方仓库显示,Qwen-Image-2.1 在 2026 年 9 月 20 日同步获得 Diffusers、ComfyUI、vLLM-Omni 和 SGLang 的支持;因此当前最稳妥的路径是先用 Diffusers 验证基线,再按吞吐需求迁移到工作流或服务框架。本文内容基于 2026 年 9 月 21 日可访问的官方仓库、Hugging Face 模型卡和相关项目说明,版本与接口可能继续变化,部署前应重新核对上游文档。
延伸资源
Qwen 官方仓库:https://github.com/QwenLM/Qwen-Image-2.1
Hugging Face 模型卡:https://huggingface.co/Qwen/Qwen-Image-2.1
Qwen 官方博客:https://qwen.ai/blog?id=qwen-image-2.1
ComfyUI 兼容权重:https://huggingface.co/Comfy-Org/Qwen-Image-2.1
多模型推理与对比工具:七牛云 AI(https://www.qiniu.com/ai/models)