DeepSeek Harness 为什么越用越贵?长会话 Token 重放、上下文管理与降本方法
发布日期:2026-09-28|适用对象:DeepSeek Harness 用户、Agent 工程师、需要控制模型用量的开发团队|资料口径:DeepSeek 官方仓库与文档、GitHub 社区讨论
DeepSeek Harness(DSH)是 DeepSeek AI 开源的 Agent Harness,官方在 2026 年 9 月仍将其标注为 Developer Preview,并采用“Everything is a Plugin”的可组合架构。它“越用越贵”通常不是模型突然变贵,而是长会话里上下文、工具结果和搜索结果被反复带入后续调用,导致每一轮输入 Token 变大;社区个案还显示,重复搜索和不收敛的工具循环会把成本进一步放大。本文把这些现象拆成可观测的成本结构,并给出不依赖特定服务商的降本做法。
先给结论:贵在“重复携带”,不一定贵在模型
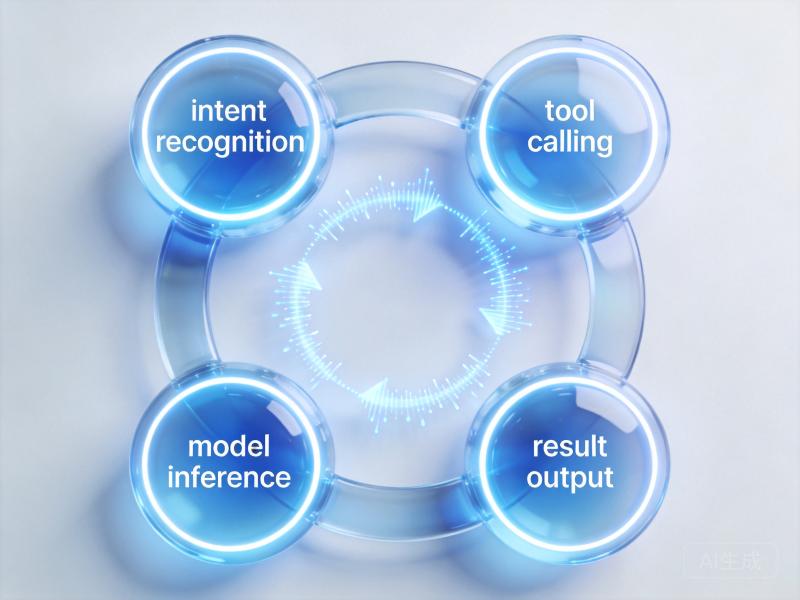
DeepSeek Harness 的成本问题,核心是同一个任务在多轮 Agent Loop 中不断重新携带历史上下文、工具返回和搜索材料。
这意味着一次回答看起来只输出几百字,实际计费输入可能包含此前数十轮对话、代码片段、网页摘录和插件结果。只要会话继续变长,单轮输入 Token 就可能比上一轮高很多。
需要区分两件事:第一,官方 README 能证明 DSH 是开发者预览中的开源 Agent Harness;第二,“每一步都重发完整会话”是社区用户根据自身会话观察提出的解释,并非官方已经确认的统一实现细节。写排障结论时,不能把后者改写成绝对规则。
DeepSeek Harness 到底是什么?
截至 2026 年 9 月,DeepSeek 官方仓库把 DSH 描述为可插拔的 Agent Harness,模型、工具、会话、沙箱、循环、调度和界面等能力都通过插件组合。官方 README 同时提醒项目处于 Developer Preview,兼容性可能发生破坏性变化。
官方给出的本地 Web 启动命令是:
npx @deepseek-ai/dsh web默认界面地址为 http://127.0.0.1:3080。这条命令只能说明如何启动本地界面,不能说明每一次调用会发送多少 Token;真实用量仍要按会话、工具和模型服务的记录核算。
为什么长会话会越来越贵?
1. 上下文重放让输入成本累积
一位 GitHub Discussion #6885 的用户根据其会话观察认为,DSH 在 Agent Loop 的每一步都会重新携带完整对话上下文。这个判断尚未被官方文档确认,但它能解释一种常见现象:输出长度变化不大,输入 Token 却随轮次快速增长。
对开发者来说,最重要的不是争论“是否 100% 重放”,而是检查自己的调用日志:如果每一轮的输入字段都包含完整历史、工具结果和搜索摘录,就应按重放成本来设计会话。
2. 搜索结果和插件输出会把上下文撑大
同一条 Discussion #6885 中,用户称某些社区搜索插件单次可能消耗 6 万至 25 万 Token,单个 DSH 响应可能超过 100 万 Token,复杂对话累计甚至达到 1 亿 Token。这里的数字是单个用户报告,不是 DSH 的平均值,也不是官方计费标准。
搜索质量不足还会形成二次放大:第一次没找到资料,Agent 再换关键词、换插件、再读一遍结果;每一次尝试都可能把新的网页摘录追加进后续上下文。
3. 不收敛的工具调用会形成“兔子洞”
GitHub Discussion #895 讨论了 Agent 反复攻击同一问题的现象:确认偏差、沉没成本和过早形成叙事闭环,会让 Agent 在没有新证据时继续调用工具。
这类循环的成本不只来自调用次数,还来自每一轮都会携带上一次失败实验、错误输出和未完成计划。没有停止条件时,“再搜一次”很容易变成最贵的默认动作。
4. 会话日志越长,管理成本也越高
在 GitHub Discussion #8032 中,一位用户记录了一个重度 Windows、多插件会话:584 次模型调用、约 2.74 亿 Token,约 98.6% 用于重新读取上下文,模型输出约占 0.17%。作者明确说明这是一套重度配置,不代表普通用户平均水平。
同一报告还记录了 4.69 MB 的压缩日志、3,549 条记录,以及需要渲染 644 个聊天气泡和 1,430 个工具卡片的界面。它说明长会话的代价不仅是模型费用,也包括检索、渲染、恢复和人工复盘。
用一个简单模型定位成本来源
下面的公式是排障用的解释模型,不是任何服务商公布的账单公式:
总 Token ≈ 每轮输入上下文 Token × Agent 调用轮数 + 工具/搜索返回 Token + 输出 Token
如果账单或日志只给总量,先把每轮调用按时间排序,至少记录:任务名、输入 Token、输出 Token、工具名、返回字节数、是否产生新证据。没有这些字段,单看月度总价很难知道该删上下文还是减少调用。
现在就能执行的降本方案
先把一个长会话拆成四个阶段
建议把工作拆成“探索、方案、执行、验收”四个会话或四个明确里程碑。探索阶段只读文件和资料;方案阶段输出短 handoff;执行阶段只携带验收所需的文件与约束;验收阶段重新读取测试结果,不把全部原始搜索记录带过去。
每次切换阶段时,保留下面五类信息即可:
目标与完成标准。
已确认的文件、接口和数据结构。
已尝试且失败的方案,以及失败证据。
不得触碰的路径、命令和权限边界。
下一步唯一动作与停止条件。
给搜索和工具调用加“证据门槛”
连续两次搜索没有新证据时,暂停搜索,先回答三个问题:它是否仍是当前最痛的问题?上一次结果排除了什么?是否能用本地日志、官方文档或最小复现替代下一次搜索?这正是 Discussion #895 提出的 pain-point check 思路。
工具返回也要设上限。网页搜索优先拿标题、日期、原文链接和与任务直接相关的段落;代码扫描优先限定目录;插件调试优先保留错误栈和版本,而不是把完整日志反复塞回上下文。
用短摘要替代原始 transcript
不要把“压缩摘要”写成一篇新的长报告。一个可执行的 handoff 通常不超过一屏,重点是决策、接口契约、失败证据和下一步。原始日志应放在可检索文件里,只有被当前任务引用的片段才进入上下文。
为负结论增加断言和交叉验证
Discussion #8032 还记录了结构分析中的风险:模型读错字段后,可能把“没有找到”说成“数据不存在”。在删除字段、关闭功能或下结论前,加入文件级断言、查询计数和第二条独立证据。少一次错误返工,往往比单纯压缩提示词更省 Token。
把成本预算写进任务卡
每个任务开始前写四个数字:允许的最大 Agent 轮数、最大搜索次数、最大输入 Token、触发人工接管的条件。DSH 仍处于 Developer Preview,若当前版本没有你需要的可视化用量指标,就用调用日志或服务商用量记录做外部台账。
哪些任务不适合直接开超长 DSH 会话?
开放式资料研究、跨多天持续修改同一项目、一次接入大量插件的 Windows 环境,都不适合默认使用一条永不结束的会话。
这类任务更稳妥的方式是:按交付物切分会话;为每个阶段生成 handoff;把原始日志放到外部文件;在下一阶段只恢复必要上下文。若必须保留完整轨迹,也应把“可恢复”与“可重放”分开测试,避免为了方便恢复而每轮都携带全部历史。
最后的检查清单
开始一次 DSH 任务前,逐项确认:
目标是否能在一个明确交付物上结束?
本轮允许读取和修改哪些目录?
搜索多少次仍没有新证据时必须停下?
哪些内容只保留在日志,不进入下一轮上下文?
输入 Token、工具返回和输出 Token 分别由谁记录?
负结论是否有断言、计数或第二来源验证?
DeepSeek Harness “越用越贵”的关键,不是简单地把锅归给模型或某个插件,而是把上下文、工具调用和停止条件当成可观测的工程指标。官方仓库确认了 DSH 的插件化定位和 Developer Preview 状态;社区讨论则提供了长会话重放、搜索膨胀和工具兔子洞的真实问题线索。本文数据截至 2026 年 9 月 28 日,社区数字均为个案报告,来源见文末参考资料与信源清单。
社区问题线索(非官方行为证明)
GitHub Discussion #6885:搜索质量与 Token 成本:https://github.com/deepseek-ai/deepseek-harness/discussions/6885
GitHub Discussion #8032:约 30 天生产使用反馈:https://github.com/deepseek-ai/deepseek-harness/discussions/8032
GitHub Discussion #895:阻止工具调用陷入兔子洞的提议:https://github.com/deepseek-ai/deepseek-harness/discussions/895
参考资料
DeepSeek Harness 官方 GitHub 仓库(README):https://github.com/deepseek-ai/deepseek-harness
DeepSeek Harness 官方文档:https://deepseek-harness.github.io/deepseek-harness/
七牛云 Token Plan 官方页面(deepseek最低1.2折):https://www.qiniu.com/ai/plan