Karpathy:全球 75% 的人还没真正碰过 AI,剩下 0.2% 在用的和你完全不一样
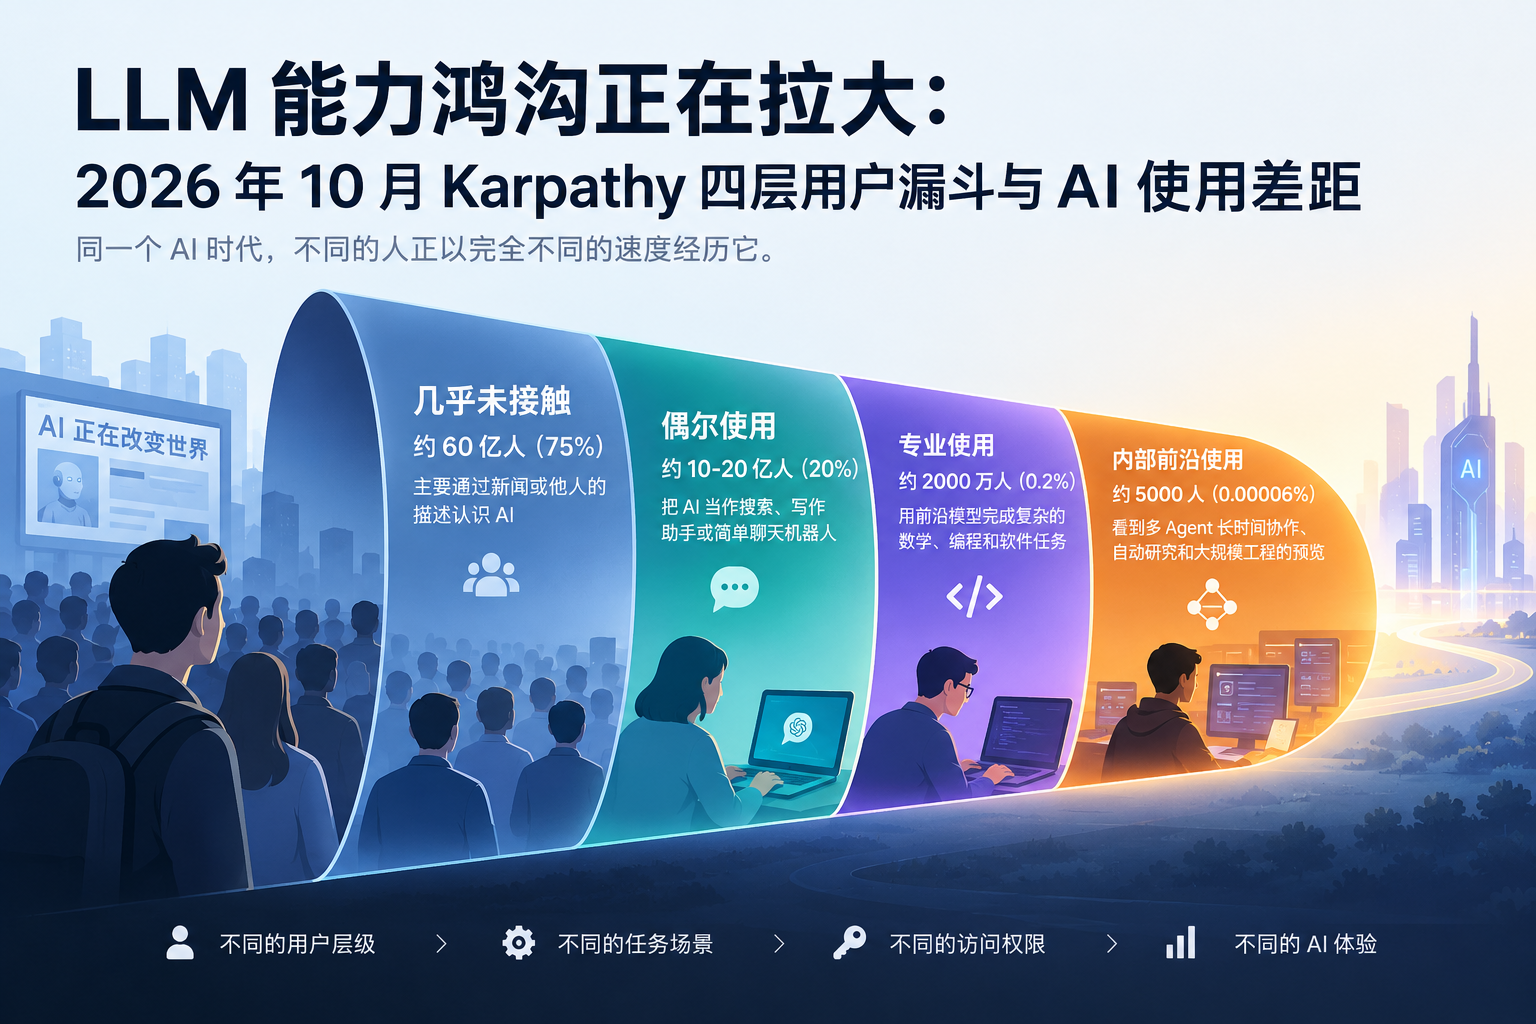
Andrej Karpathy 在 2026 年 10 月 12 日更新的一条 X 帖子中,把 LLM 用户按实际接触到的能力分成四层:几乎没有接触、偶尔使用免费产品、在数学和编程中使用前沿模型,以及能够接触内部前沿系统的极少数人。他用一组自称“napkin math”的估算说明,同一个 AI 时代正在被不同人以完全不同的速度经历。
Karpathy 说的“漏斗”是什么
Karpathy 的核心判断是,LLM 能力鸿沟已经从“不同人谈论不同话题”,变成了一个越来越尖的漏斗。
这些数字不是人口调查,也不是模型使用平台的公开统计,而是 Karpathy 为了描述差距所做的粗略估算。它们的价值不在于精确,而在于提醒读者:当有人说“AI 只是聊天机器人”或“AI 已经能自动完成大型项目”时,两个人可能都在陈述自己的真实体验。
为什么同一个模型会带来不同体验
第一,任务的规模和时间跨度决定了能力是否显现。一个只需要几句话回答的问题,很难展示模型的上限;一个有明确目标、可以持续数小时并且能够反复验证的任务,才会让 Agent 的优势出现。Karpathy 把这种差别归因于问题的 ambition、规模和 horizon。
第二,模型能力并不是平均分布的。Karpathy 认为,数字化、可验证、具有经济价值的领域更容易形成高质量反馈,因此数学和编程会比开放式闲聊更早出现明显跃升。这个判断也解释了为什么同一个模型在代码仓库里表现惊艳,换到需要长期现实判断的任务中却可能依然笨拙。
第三,访问层级会改变使用结果。免费聊天产品、付费产品、API、带工具的 Agent 和内部系统,拥有不同的模型、上下文长度、工具权限、运行时间和并发条件。用户看到的不是一个抽象的“模型能力”,而是模型能力乘以访问权限后的结果。
官方 Agent 工具已经具备哪些能力
从官方文档看,前沿 Agent 与普通聊天窗口的差别主要体现在工作方式,而不是聊天界面的外观。
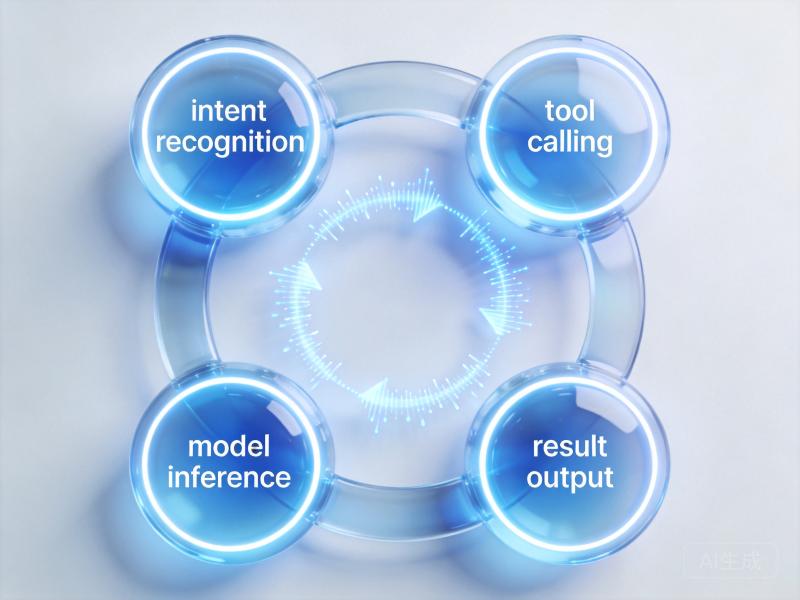
Anthropic 的 Claude Code 文档将其定义为 Agentic coding tool:它可以读取代码库、编辑文件、运行命令,并与开发工具集成;同一套底层引擎还能运行在终端、IDE、桌面端和浏览器中。OpenAI 的 Agents 文档则把后台模式、多 Agent 编排、工具调用和长任务状态列为 API 的核心能力。
这说明“会不会写一段代码”已经不是唯一问题。更关键的问题是:模型能否理解工作上下文,能否调用工具,能否在中断后恢复,能否让结果通过测试,能否把失败原因交还给人继续判断。
普通用户怎样判断自己处在哪一层
你不需要先相信某个模型排行榜,可以用一个真实任务做一次小型测量。
选择一个平时需要 30 分钟以上的任务,例如整理一组资料、修复一个小程序、生成一份带引用的分析或重构一个页面。
先写清楚完成标准。标准必须能被检查,例如测试通过、字段齐全、引用可访问、输出能被同事复核。
记录你给模型的权限:只有对话,还是能读取文件、执行命令、调用浏览器或运行测试。
让模型先给出计划,再执行一小段,检查一次结果。不要把一次成功的回答当成完整能力证明。
记录三项结果:节省了多少时间、哪一步需要人工返工、哪些错误是模型自己发现的。
如果模型只能给建议,你测到的是聊天层;如果它能修改文件并运行验证,你测到的是工具层;如果它能在数小时内持续推进、根据反馈修正,你才开始接近 Karpathy 所说的专业使用层。这个方法的重点是测量任务闭环,而不是比较一条回答听起来是否聪明。
能力提升为什么没有平均传导到社会
Stanford HAI 的 2026 AI Index 报告把“AI 能做什么”和“社会是否准备好管理它”之间的差距列为今年的重要观察。报告同时指出,AI 的技术能力、投资和采用速度都在提升,但治理、评测和理解框架没有同步跟上。
这与 Karpathy 的漏斗叙述相互呼应:能力先在少数数字化、可验证、拥有高访问权限的工作中爆发,再慢慢向其他职业扩散。扩散过程中会遇到培训、权限、安全、责任归属和组织流程等限制,所以“模型已经能做到”不会自动变成“每个人都能用起来”。
结语:先缩小体验差距,再讨论乐观或悲观
Karpathy 的帖子最值得关注的地方,不是四个数字是否精确,而是它解释了 AI 争论为什么经常互相错位。公众、普通职场用户、专业开发者和内部前沿用户,可能处在同一条能力曲线的不同位置。
对个人而言,最可靠的判断方式是拿真实任务测量完整闭环;对组织而言,关键是把模型、工具、权限、验证和责任一起设计。本文数据截至 2026 年 10 月 12 日,估算来自 Karpathy 原帖,能力描述来自 OpenAI 与 Anthropic 官方文档,行业背景来自 Stanford HAI 2026 AI Index。
参考资料
T1 Andrej Karpathy X 原帖(2026-10-12):x.com/karpathy/status/2109361546505966046
T0 Anthropic Claude Code 官方文档:docs.anthropic.com/en/docs/claude-code/overview
T0 OpenAI Agents API 官方文档:platform.openai.com/docs/guides/agents
T1 Stanford HAI 2026 AI Index:aiindex.stanford.edu/report/
七牛云 token plan:https://www.qiniu.com/ai/plan