阶跃 Step 5 Preview 开源:600B MoE、1M 上下文,长程 Agent 成为主线
发布日期:2026-10-15
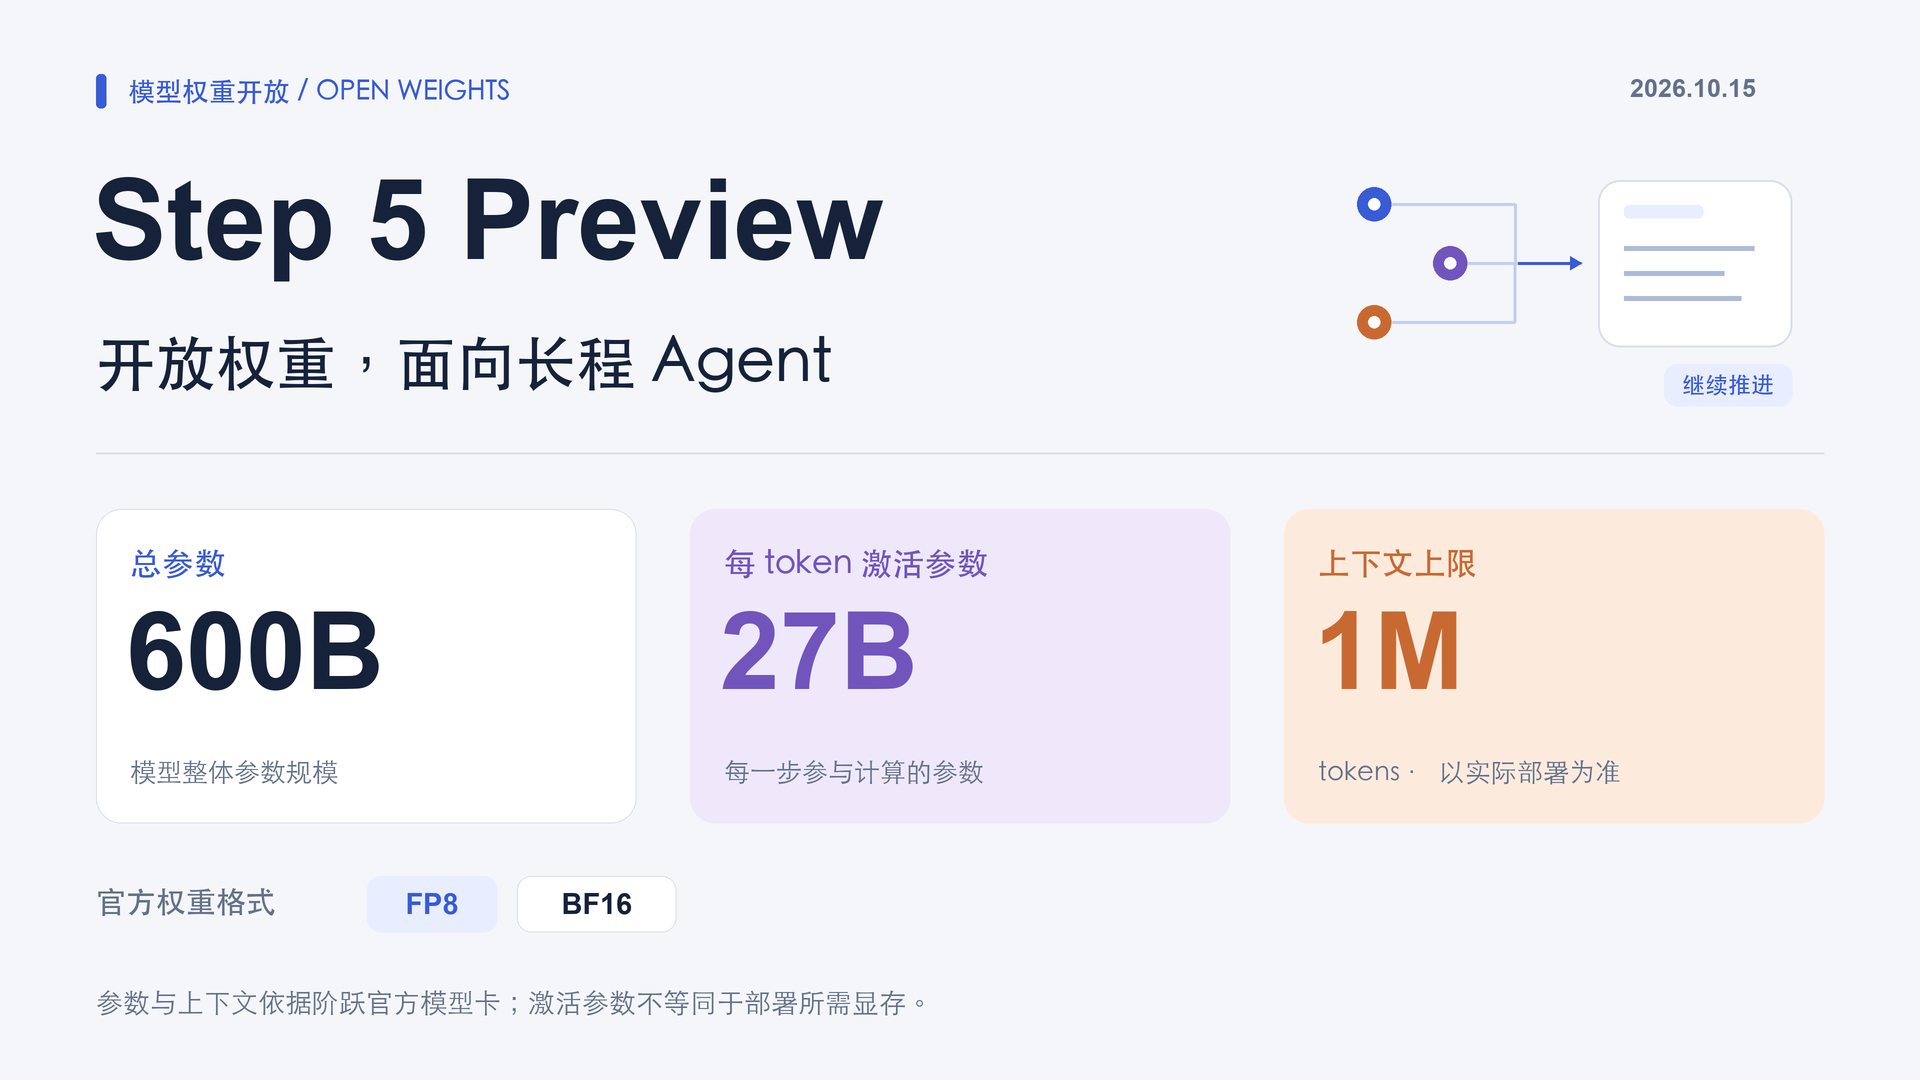
Step 5 Preview 是阶跃星辰面向软件工程与专业知识工作的旗舰模型,截至 2026 年 10 月 15 日已提供 FP8、BF16 权重及推理代码。模型采用 600B 总参数、27B 激活参数的稀疏 MoE 架构,支持最高 1M tokens 上下文。技术博客解释了它如何通过网络深度、稀疏注意力和长轨迹训练,支持持续调用工具与推进任务。开发者可用官方 API 评测,也可按硬件条件部署;商用需核对 StepFun Model License 1.0。
权重已经开放,重点是把任务做下去
**Step 5 Preview 已开放模型权重,开发者可以下载、评测和适配这一旗舰模型。**截至 2026 年 10 月 15 日,官方 Hugging Face 与 ModelScope 页面均可访问,主仓提供 FP8 权重,另有独立 BF16 仓库。
阶跃星辰当天发布的技术博客,解释了模型为何面向长程 Agent 设计:任务越长,工具调用产生的上下文越多,模型越需要在大量信息中保持推理与行动的一致性。
按照官方模型卡,Step 5 Preview 总参数为 600B,每 token 激活参数为 27B。激活参数描述每一步参与计算的规模,部署仍需考虑整套权重、缓存及运行开销,不能把它当成一款 27B 模型准备显卡。
官方文档列出的应用包括跨文件代码修改、测试验证、长文档研究、图表分析和金融研究。这些任务的共同要求,是读完材料后仍能调用工具、检查反馈,并持续推进到交付。
92 层网络,为多步推理留出深度
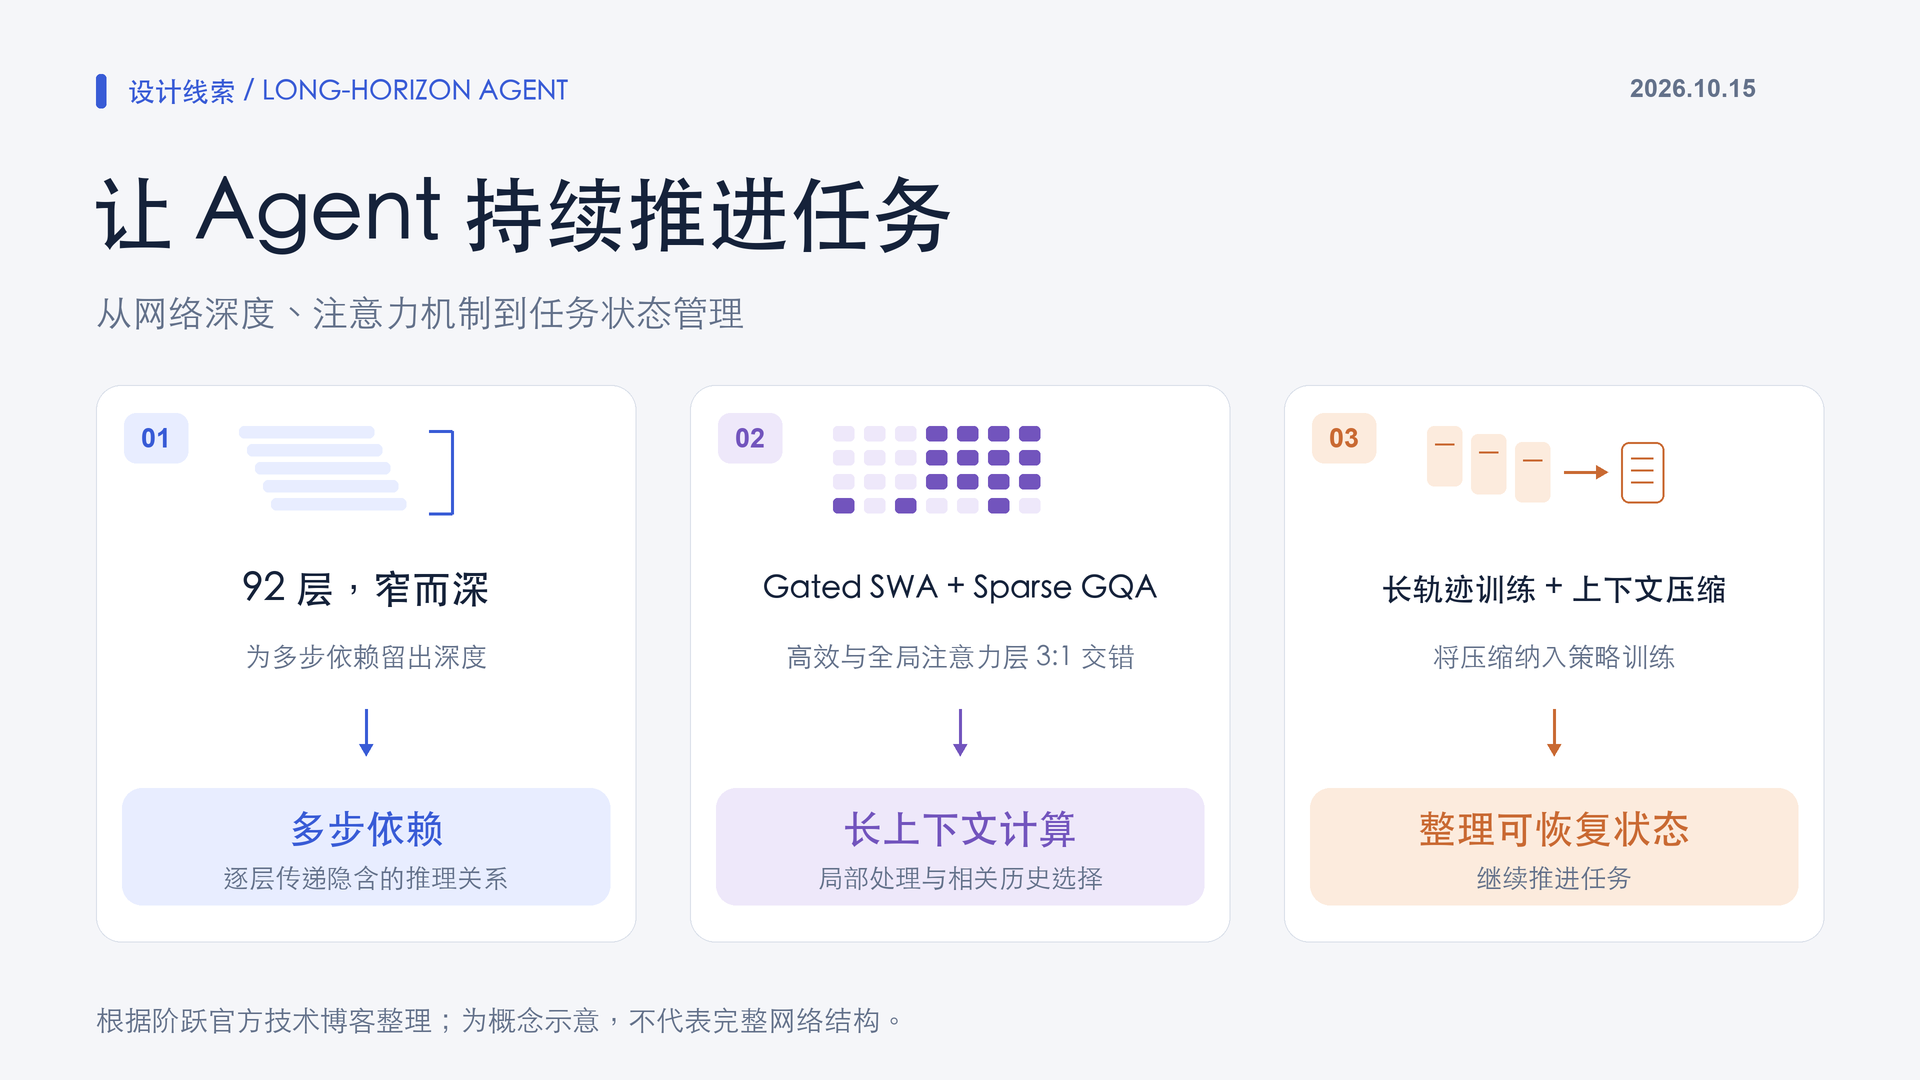
**Step 5 Preview 采用“窄而深”的结构,技术博客披露其包含 92 个 Transformer blocks。**这是阶跃在 2026 年 10 月技术博客中解释长程能力的一个核心设计。
工具返回的日志、文档和代码会不断进入上下文。阶跃认为,多跳依赖需要在模型内部逐层传递,增加网络深度,有助于模型处理这些隐含的推理关系。
注意力结构则按 3∶1 交错安排 Gated Sliding Window Attention 与稀疏全局注意力层。前者处理局部信息,后者使用 Sparse GQA 从长历史中选择相关内容,在长上下文能力与计算开销之间寻找平衡。
Sparse GQA 采用分块索引。博客给出的配置为每块 8 个 token,选择预算 k=4096,对应 512 个历史块。这是注意力选择机制的内部设置,不能理解为模型只能读取 4096 token。
更深的网络也带来训练稳定性问题。博客介绍了 FP32 隐藏状态、FP32 RMSNorm 缩放参数及细粒度梯度裁剪等处理方式。它们属于训练设计,使用 API 时不需要手动配置。
长程 Agent,训练的不只是回答
**阶跃把上下文压缩和长轨迹强化学习纳入训练,希望模型在有限窗口内持续工作。**2026 年 10 月技术博客描述:当上下文预算接近耗尽,Agent 将工作整理成可恢复状态,再继续推进。
这一区别很实际。1M 上下文决定一次能够容纳多少信息;更长的任务还需要保留目标、已完成步骤、关键证据与待办事项,减少重复探索。
数据构建也使用 Agent,但专家仍负责制定原则和审核关键节点。可重复的格式检查、测试覆盖检查等操作交给代码执行,Agent 负责协调过程,并依据中间结果调整任务。
**工具执行能力仍由接入模型的应用提供。**官方文档明确说明,搜索、代码执行和外部工具并非模型自行具备的环境权限。搭建 Agent 时,仍需实现工具调用、结果回传和任务验收。
评测看设置,不能只摘一个分数
**Step 5 Preview 的官方成绩需要连同推理档位和评测框架一起阅读。**2026 年 10 月核对的模型卡说明,公布的该模型评测结果使用 High reasoning 设置。
例如,官网给出的 DeepSWE v1.1 成绩为 67.7%,模型卡注明该项采用 SWE-agent,采样参数为 temperature=1.0、top_p=0.95。这是特定设置下的官方评测结果。
阶跃自建的 StepCodeBench 覆盖 553 个代码仓库、9 类任务、20 个领域和 33 种编程语言,官网报告 49.0% 的 avg@4 成绩。这里应保留 avg@4 统计口径,不能直接改写成单次任务成功率。
官网也指出,模型在最具挑战性的长程任务上仍有差距。判断是否适合自己的业务,需要固定任务、工具环境和预算,同时观察完成率、错误类型、耗时与调用成本。
先用官方 API 验证,再决定部署
**没有多卡服务器,也可以先通过阶跃官方 API 检查模型与现有任务是否匹配。**截至 2026 年 10 月,官方模型 ID 为 step-5-preview,支持文本、图片和视频输入,输出为文本。
先在阶跃开放平台创建 API Key,将真实密钥配置到环境变量 STEP_API_KEY,再执行以下请求。不要把示例变量名当成密钥;API 按实际用量计费。
curl -sS --fail https://api.stepfun.ai/v1/chat/completions \
  -H "Authorization: Bearer ${STEP_API_KEY:?请先设置 STEP_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "step-5-preview",
    "messages": [
      {
        "role": "user",
        "content": "为一个代码仓库整理三步排错计划,并说明每一步需要什么证据。"
      }
    ],
    "reasoning_effort": "medium",
    "max_tokens": 1024,
    "stream": false
  }'
返回后检查 choices[0].message.content 和 finish_reason。若输出触及长度限制,再调整预算。完成连通性检查后,换成自己的脱敏材料和明确验收标准;一次计划生成不能代替完整 Agent 任务评测。
API 与自部署的长度口径也要分开。当前官方 API 文档标注最高 1M 上下文、最大输出 64k;模型卡则写最高 1M 输出。调用托管服务应按 API 文档执行,输入与生成内容合计仍受上下文限制。
自部署方面,模型卡提供 vLLM、SGLang 和独立推理实现。FP8 示例包含 4 张 B300 或 8 张 H200;这些是官方示例配置,实际可用上下文和并发还取决于权重、框架与缓存预算。
开源之后,还要读清许可证
**Step 5 Preview 使用 StepFun Model License 1.0,包含额外的署名与商业许可条件。**2026 年 10 月核对的许可证覆盖权重、参数、配置、分词器、模型专用代码及文档。
例如,硬件制造商或品牌方将模型能力作为终端设备及配套服务的商业功能提供时,涉及另行签署商业许可;经营 MaaS 业务且达到规定收入门槛,也有单独条件。具体适用范围和例外应按许可证全文核对。
从模型卡到技术博客,Step 5 Preview 展现了一条明确路线:通过网络深度、稀疏注意力和长轨迹训练,支持持续推进真实任务。权重开放为外部评测与适配提供了入口,实际交付效果仍要在完整工具环境中验证。本文数据截至 2026 年 10 月 15 日。
参考资料
Step 5 Preview 官方模型卡:huggingface.co/stepfun-ai/Step-5-Preview
Step 5 Preview BF16 官方权重:huggingface.co/stepfun-ai/Step-5-Preview-BF16
ModelScope 官方模型页:modelscope.cn/models/stepfun-ai/Step-5-Preview
官方技术博客(2026-10-15):platform.stepfun.ai/blog/inside-step-5-preview
官方模型介绍与评测:www.stepfun.com/step-5-preview
官方模型与推理代码仓库:github.com/stepfun-ai/Step-5-Preview
官方许可证:huggingface.co/stepfun-ai/Step-5-Preview/blob/main/LICENSE.txt
官方模型文档:platform.stepfun.ai/docs/en/guides/models/step-5-preview
官方 API 快速开始:platform.stepfun.ai/docs/en/quickstart/overview
Chat Completions API:platform.stepfun.ai/docs/en/api-reference/chat/chat-completion-create
七牛云 AI 大模型企业订阅:www.qiniu.com/ai/plan