NVIDIA 这次开源大招:120B 参数仅激活 12B,SWE-bench 达 71%(附部署方案)
发布日期:2026-10-20 | 话题:NVIDIA Nemotron 3.5 / 开源多模态大模型 / 开放权重 VL 模型
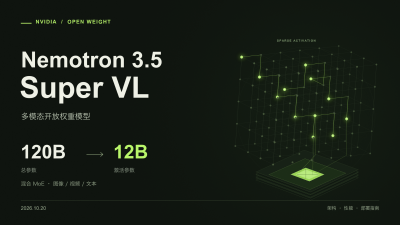
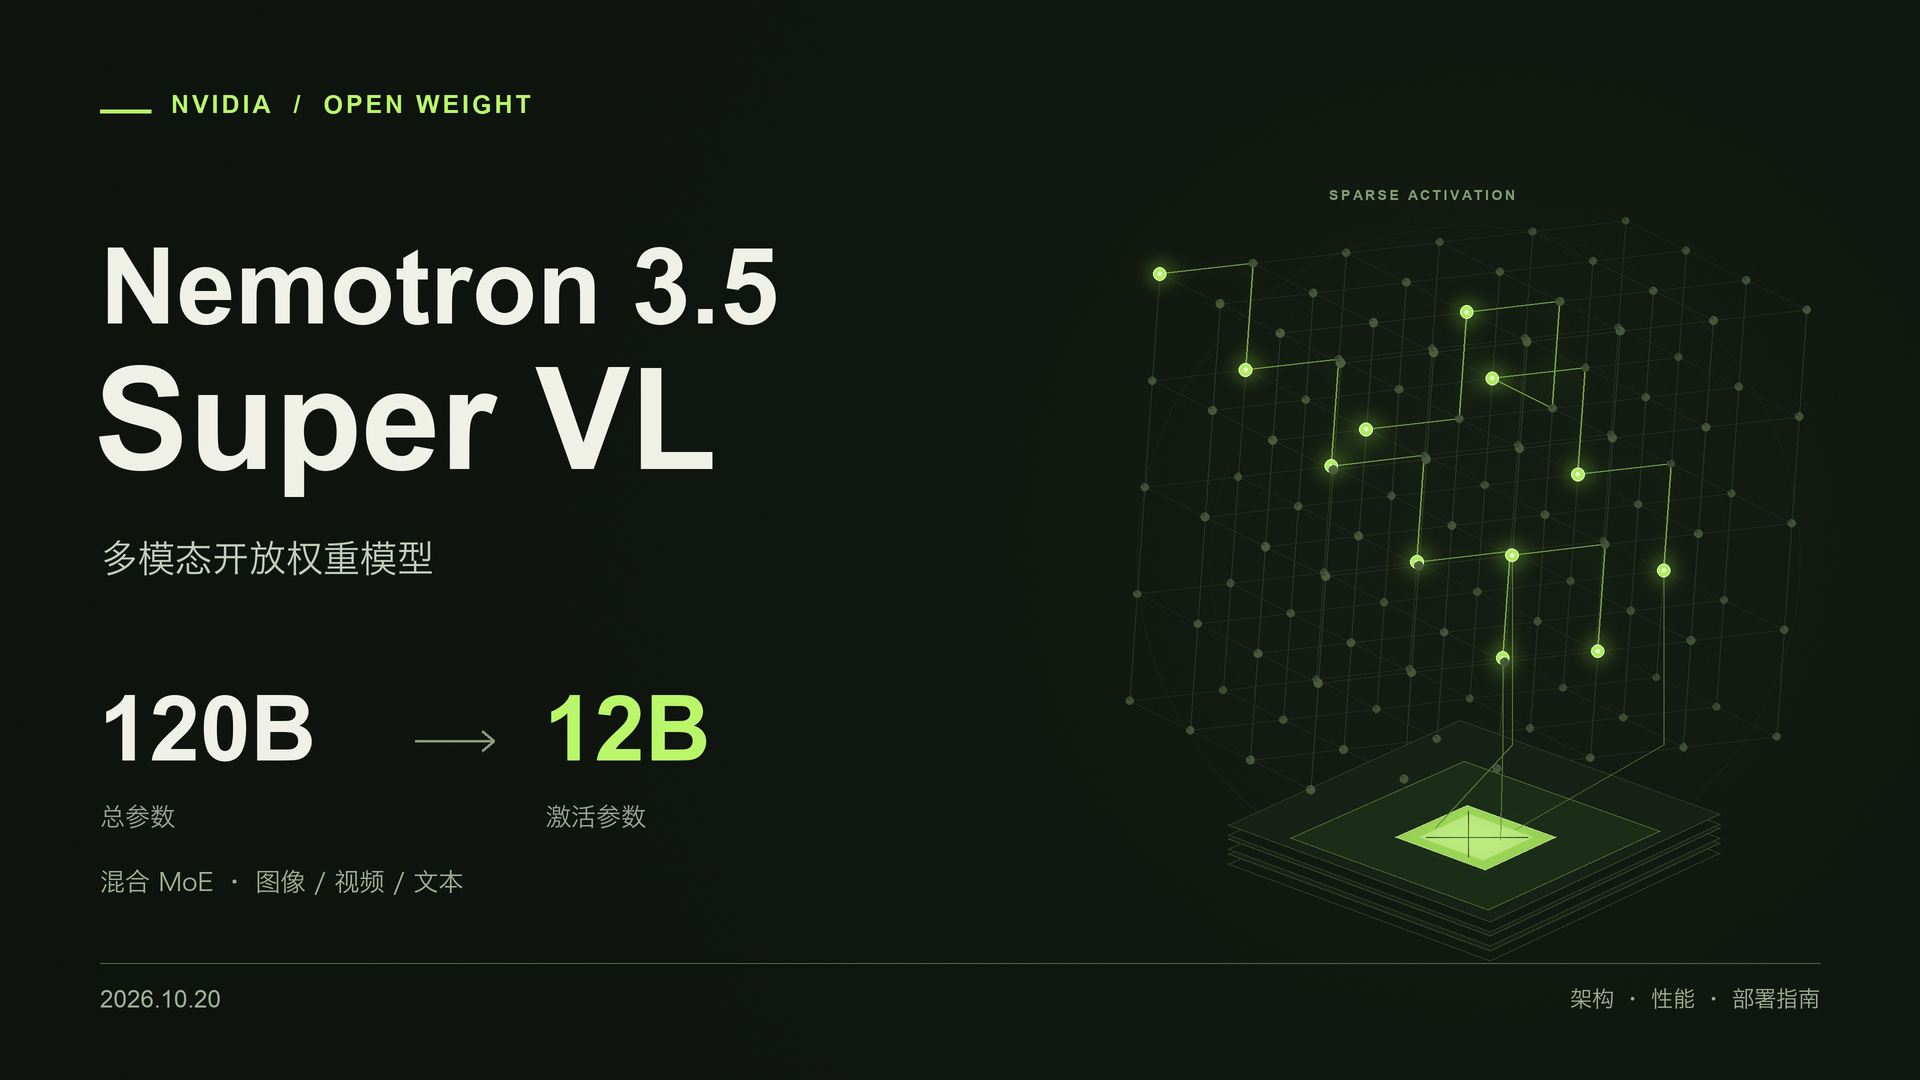
NVIDIA 于 2026 年 10 月 12 日在 Hugging Face 正式开放 Nemotron 3.5 Super VL 系列权重,旗舰版 Super VL 总参数 120B、每次推理仅激活 12B,架构采用 Mamba-2 与 Transformer 混合 MoE 结合 C-RADIO v4 视觉编码器,支持文本、图像、视频三模态输入,上下文窗口最高 1M tokens,许可证为 OpenMDW-1.1(商业用途开放)。本文完整梳理 Nemotron 3.5 系列的两个核心变体(Super VL 120B 与 Bolt 74B)的参数规格、基准测试数据、硬件要求与本地部署方案,并对比同级别开源模型 Qwen3.6-35B 和 Gemma4-26B。核心结论:Super VL 120B 在代码(SWE-bench Verified 71.07%)和推理(GPQA Diamond 89.9)维度具备竞争力;Bolt 74B 经 IQ2-XXS 量化后可在单张 24GB 显卡运行,GPQA Diamond 达 86.4,显著优于同类开源模型;两个版本均可通过 vLLM 本地部署,也可通过 NVIDIA NIM 微服务在线调用。
Nemotron 3.5 系列是什么
Nemotron 3.5 是 NVIDIA 2026 年 10 月发布的开放权重多模态模型家族,覆盖从旗舰推理到边缘部署的完整规格区间。与 Llama、Mistral 等纯文本开源模型不同,Nemotron 3.5 从设计上就面向多模态场景:图像、视频和文本可在同一个模型内统一处理,视觉编码器采用 NVIDIA 自研的 C-RADIO v4-H。
系列当前包含两个主要变体:
来源:HuggingFace 模型卡,nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4,2026 年 10 月。
OpenMDW-1.1 许可证允许商业与非商业用途,是目前开源社区认可度较高的宽松许可,研究者和企业均可直接下载使用,无需额外申请。
Super VL 120B:架构与技术亮点
混合 MoE 架构
Super VL 的架构将 Mamba-2(线性复杂度序列建模)与标准 Transformer 注意力层混合,配合 Latent MoE 结构——每次推理只激活约 12B 参数,而非全部 120B。这种设计在保持旗舰级参数量(支撑模型的"知识密度")的同时,把单次推理成本压到了 12B 模型量级。
视觉能力
C-RADIO v4-H 视觉编码器对文档理解(OCR、表格、图表)和视频帧理解做了专项优化:
OCRBench v2 英文:68.34(NVFP4 版本)
MMLongBench-Doc(长文档问答):62.82
MathVision(数学图形推理):77.79
OSWorld-Verified(GUI 操作代理):52.3
代码与推理能力
来源:HuggingFace 模型卡,nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4,2026 年 10 月。BF16 与 NVFP4 数值差异在 0.5% 以内,实际部署可直接选 NVFP4 节省显存。
SWE-bench Verified 71% 意味着模型可以独立解决约 7 成的真实 GitHub issue 修复任务,这个分数在开放权重模型中处于较高水位。
Bolt 74B:单卡部署的工程级选项
Bolt 74B 从 Super VL 120B 蒸馏而来,通过 Star Elastic 架构搜索将总参数压缩到 74B、激活参数 9B,24GB GGUF 版本经 IQ2-XXS 量化(约 2.06 bits/参数)后可在单张消费级 24GB 显卡运行(RTX 5090、DGX Spark 等)。
Bolt 74B 基准对比(同类开源模型)
来源:HuggingFace 模型卡,nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB,2026 年 10 月。
Bolt 74B 在 GPQA Diamond(研究生级科学推理)、BrowseComp(网页浏览任务完成率)、WebArena(Web Agent 任务)上均显著领先参数量更小的 Qwen3.6-35B 和 Gemma4-26B,对于受限于单卡显存预算的开发者来说是目前可自托管的最强选项之一。
部署方案
方案一:vLLM 本地部署(Super VL 120B NVFP4)
需要 vLLM nightly 版本(2026 年 10 月),推荐搭配 LiLiCorr 投机解码加速:
# 下载模型(需 HuggingFace 账号)
huggingface-cli download nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4

# 启动 vLLM 服务(单张 H200,tensor parallel=1)
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --tensor-parallel-size 1 \
  --max-model-len 32768
方案二:Ollama 本地运行(Bolt 74B GGUF,24GB 显卡)
# 拉取 GGUF 版本
ollama pull hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF

# 交互式对话
ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF
方案三:NVIDIA NIM 在线 API
不想自托管的团队可通过 NVIDIA NIM 微服务直接调用,接口兼容 OpenAI Chat Completions 格式:
from openai import OpenAI

client = OpenAI(
    base_url="https://integrate.api.nvidia.com/v1",
    api_key="<YOUR_NIM_API_KEY>",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3.5-super-vl",
    messages=[{"role": "user", "content": "分析这段代码的性能瓶颈"}],
)
print(response.choices[0].message.content)
对于需要统一管理多个开源和闭源模型调用的团队,兼容 OpenAI 格式的推理平台(如七牛云 Token Plan)可以将 Nemotron 系列与 DeepSeek、Kimi、GLM 等模型放在同一个 API Key 下管理,切换模型只需修改 model 参数。
训练数据规模
Super VL 120B 的预训练数据规模:
文本:超过 20 万亿 tokens,覆盖英语及 19 种语言、43 种编程语言
图像:100 万至 10 亿张
视频:1 万至 100 万小时
数据截止:2025 年 12 月
合成数据来源:使用了 GPT-OSS-120B、Qwen3-235B、Kimi-K2、DeepSeek-R1 等模型生成的合成训练数据
数据截止时间为 2025 年 12 月,知识时效性优于部分 2024 年末截止的竞品。
适用场景
常见问题
Q:Nemotron 3.5 Super VL 和 Bolt 74B 的主要区别是什么?
Super VL 是 120B 旗舰版,多模态能力(视频、长文档、GUI)更完整,SWE-bench 代码能力更强,但至少需要单张 H200 或双张 H100。Bolt 74B 从前者蒸馏压缩而来,通过 IQ2-XXS 量化可在单张 24GB 显卡运行,推理和知识类基准成绩仍优于多数同规模开源模型,是显存受限场景的首选。
Q:OpenMDW-1.1 许可证可以商用吗?
可以。OpenMDW-1.1 明确允许商业与非商业用途,是 NVIDIA 自定义的模型许可证,相比 CC BY-NC 系列宽松,企业可以将模型部署到生产环境,但仍需遵守许可证中关于归属声明和二次分发的具体条款,建议使用前完整阅读。
Q:NVFP4 量化版和 BF16 原始版性能差多少?
根据模型卡基准数据,两者差距在 0.5% 以内,多数任务几乎持平(如 SWE-bench Verified:71.10 vs 71.07,GPQA Diamond:89.52 vs 89.90)。NVFP4 可节省约 50% 显存,实际部署优先选 NVFP4。
Q:LiLiCorr 投机解码是什么?会影响输出质量吗?
LiLiCorr 是 NVIDIA 配套 Nemotron 3.5 发布的投机解码(Speculative Decoding)drafter,在目标模型生成时用小模型预测多个候选 token,若验证通过则批量接受,可显著提升吞吐量。投机解码在数学上保证输出分布与原模型等价,不影响输出质量。
Q:Nemotron 3.5 支持中文吗?
支持,但为辅助语言。模型卡标注的语言包括英语、西班牙语、法语、德语、意大利语、日语等,中文未在一级支持列表中明确列出,实际中文能力需根据具体任务测试评估。
结语
Nemotron 3.5 Super VL 系列的核心价值在于两点:一是以 MoE 稀疏激活把 120B 参数量的推理成本压到了 12B 量级,让旗舰多模态能力的部署门槛大幅降低;二是 Bolt 74B 的 24GB 单卡量化方案,让高质量开放权重模型首次触达消费级显卡用户。对于企业开发团队,OpenMDW-1.1 宽松许可和 OpenAI 兼容 API 接口降低了集成成本。
本文数据来源:HuggingFace 模型卡(nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4、nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB),发布日期 2026 年 10 月,建议部署前查阅最新版本文档确认硬件兼容性。
延伸资源
Super VL 120B 模型卡(NVFP4):https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4
Bolt 74B 单卡 GGUF 版本:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF
NVIDIA NIM 在线调用:https://build.nvidia.com/nvidia/nemotron-3-5-super-vl
七牛云 Token Plan(多模型统一管理):https://www.qiniu.com/ai/plan