Muse Spark Open 发布:Meta 称其为美国最强开放权重模型,816B 参数如何落地
发布日期:2026-10-16
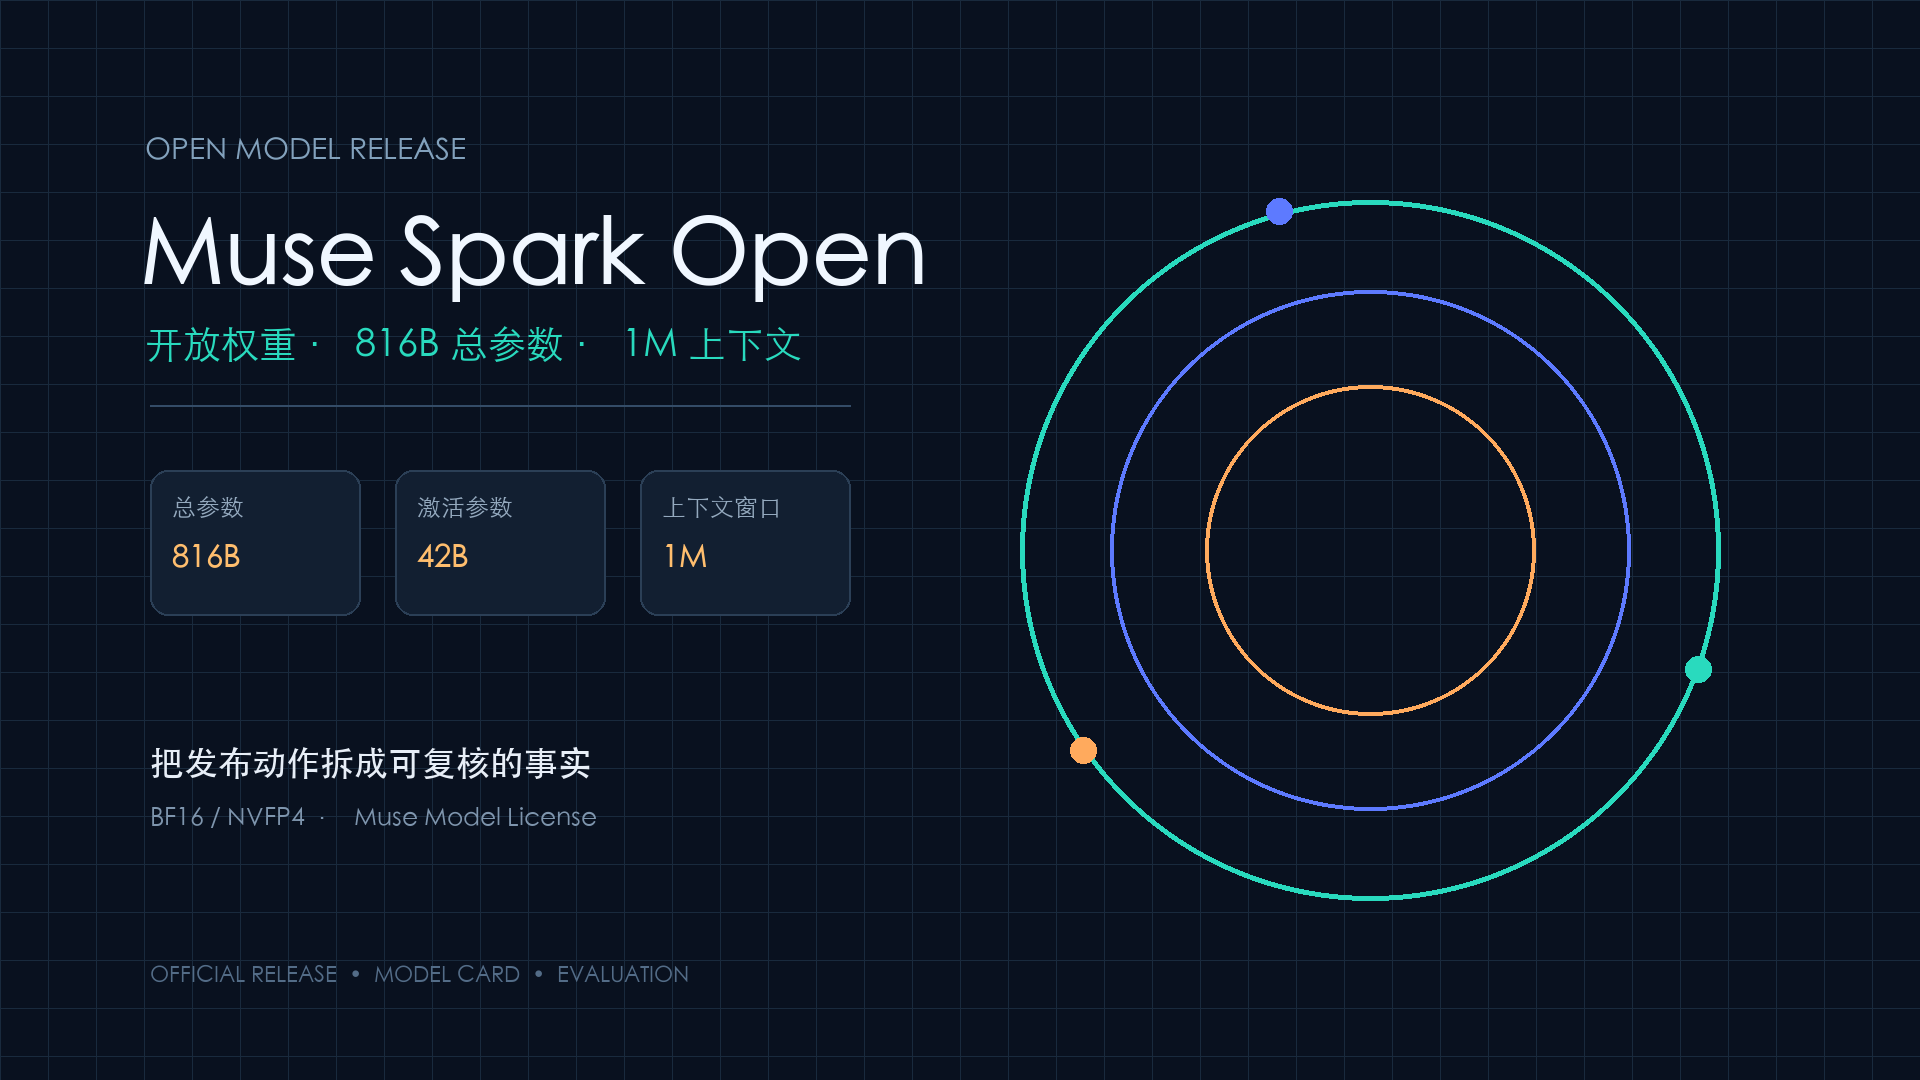
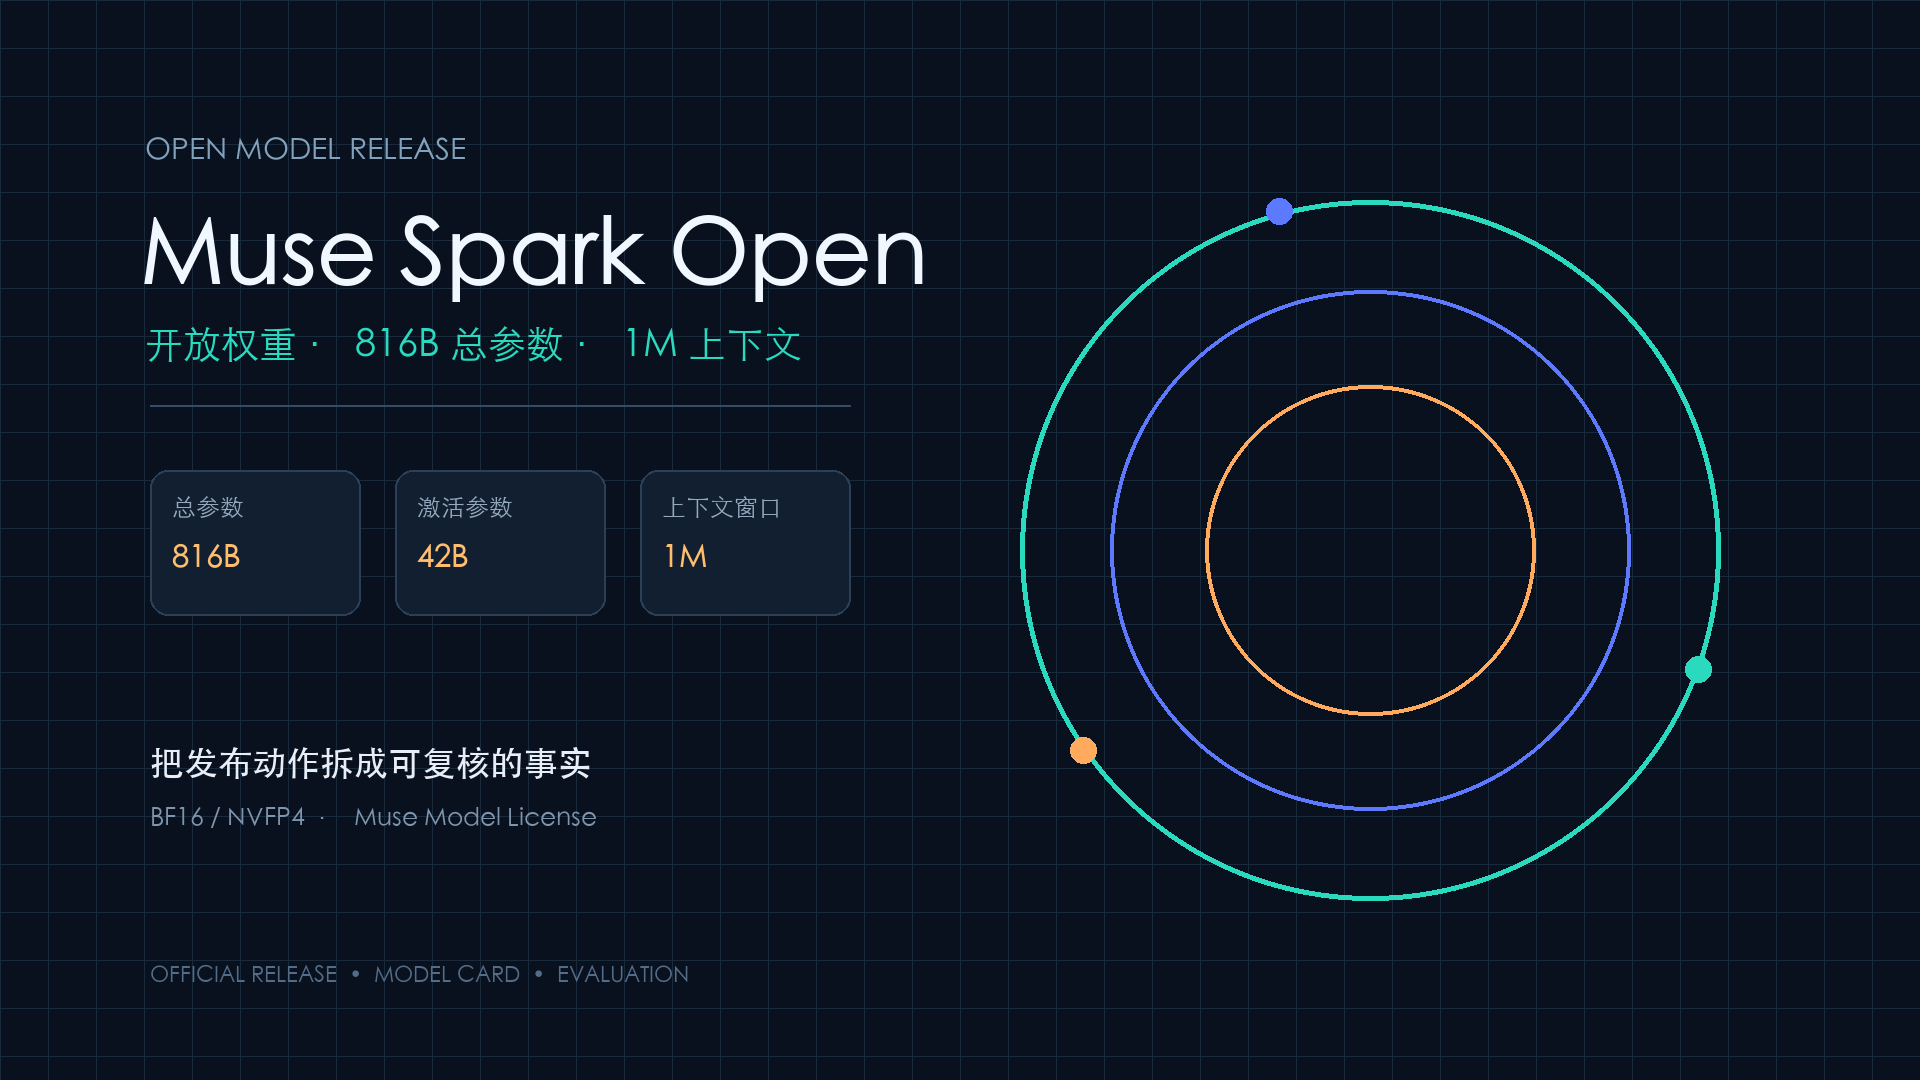
Muse Spark Open 是 Meta 于 2026 年 10 月 15 日发布的开放权重多模态模型,Meta 称其为美国最强开放权重模型。模型总参数 816B、每 token 激活约 42B,支持 1M-token 上下文和长程 Agent。
Meta 所说的“最强”,具体指什么
Muse Spark Open 的“最强”是 Meta 对美国开放权重模型范围的定位,不是一个无条件的全球榜单结论。
Meta Research 在 2026 年 10 月 15 日的发布文中使用了 “the most capable US open-weight model to date”。
Meta 开发者模型页则写成 “the most capable open-weight model from a US lab”。
这次发布的是权重,模型可以通过 Hugging Face 获取,也同步进入 Amazon SageMaker AI、Google Cloud Model Garden 和 Microsoft Foundry Models。
Meta 列出的首发推理平台包括 SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp 和 Unsloth。
模型本身是原生多模态稀疏 MoE,接受文本、图片、视频和音频输入,1M-token 上下文面向长代码库、连续工具调用和多步任务。
开放权重不等于下载后自动拥有搜索、代码执行或桌面控制权限;这些能力仍由接入的 Agent 应用提供。
816B 总参数,42B 每 token 激活
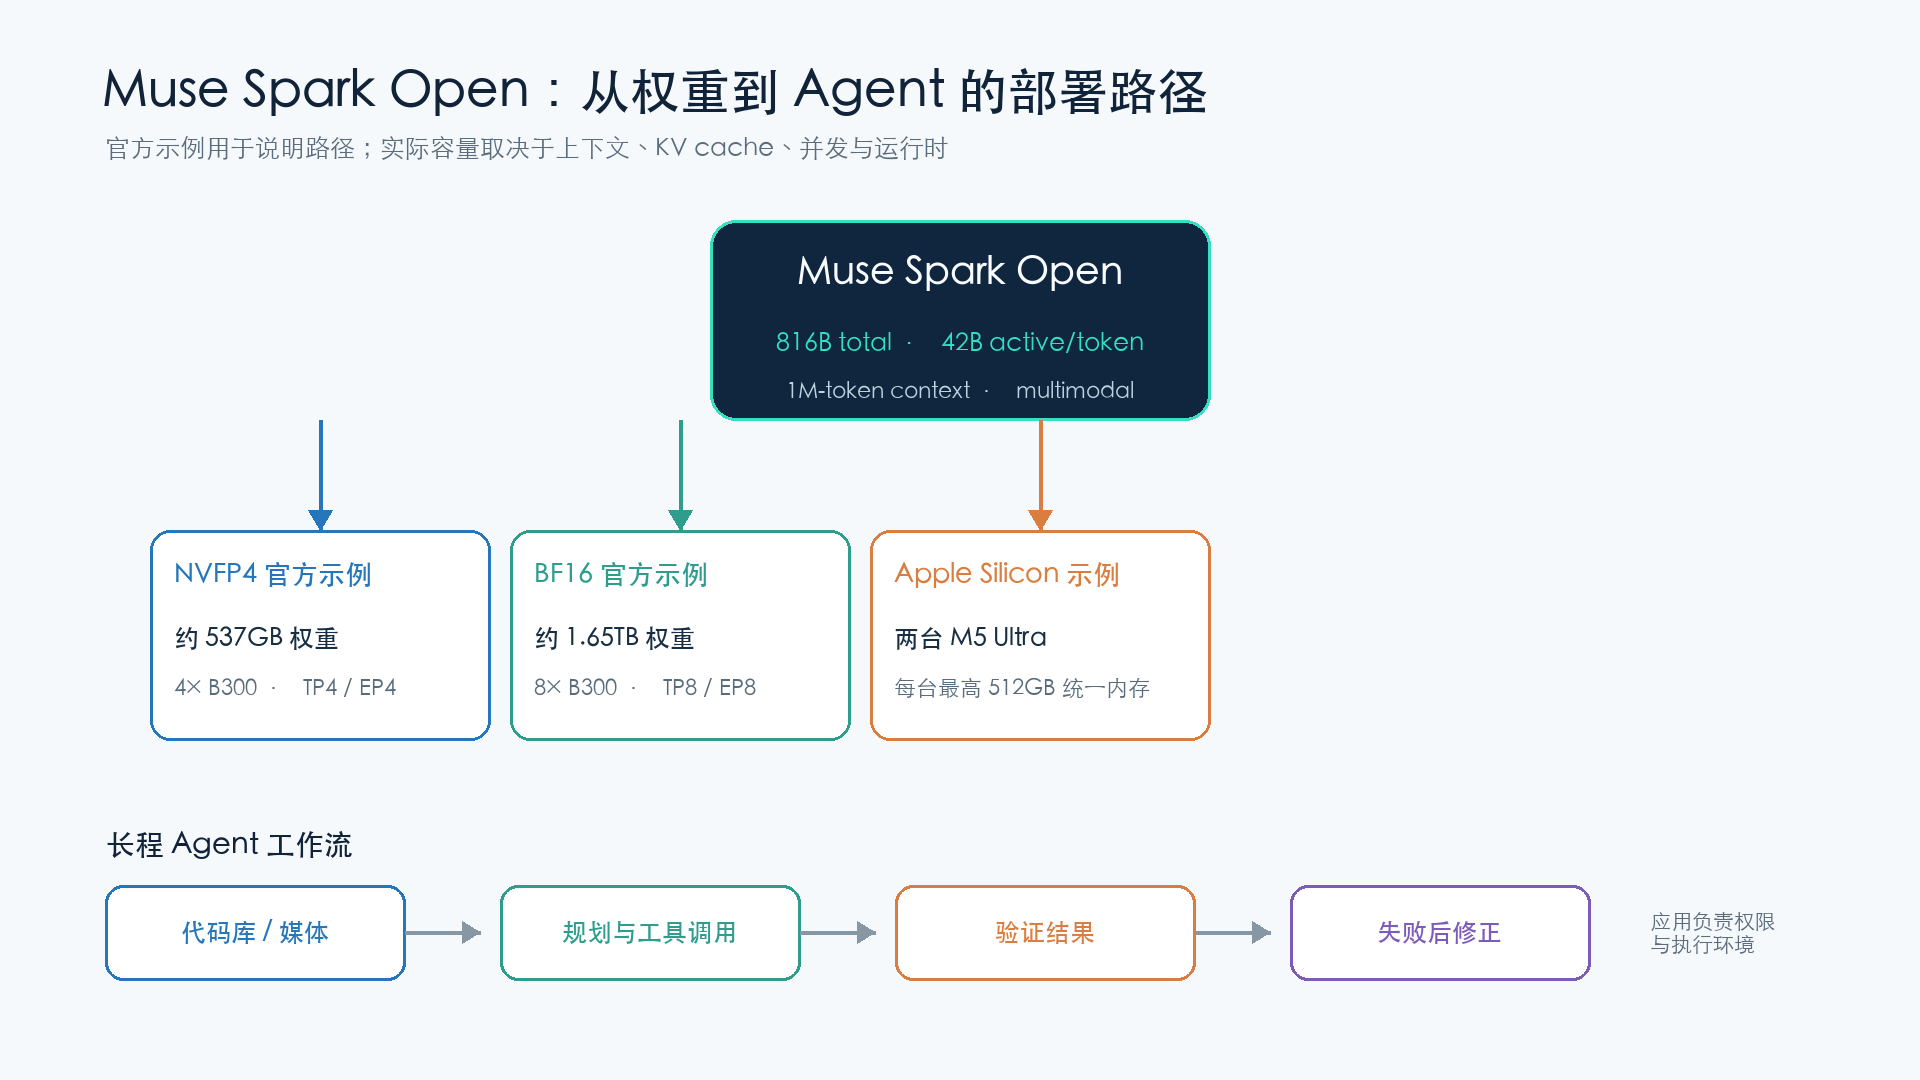
Muse Spark Open 的 816B 是总参数规模,42B 是每个 token 的激活参数量,两个数字不能互换成单卡部署要求。
Meta 开发者页给出的模型规格是 816B 总参数、约 42B 激活参数;模型采用稀疏混合专家结构。
官方提供 BF16 和 NVFP4 两种主要权重。Meta 开发者文档给出的权重体积约为:BF16 1.65TB,NVFP4 约 537GB。
这个数字还不包含 KV cache、激活和运行时开销,真正需要的 GPU 数量取决于显存、互联、上下文长度和推理框架。
因此,“42B 激活”只能帮助理解单 token 的计算路径,不能把它当作 42B 稠密模型来估算显存。长上下文请求还会增加 KV cache,部署前应先按目标上下文和并发做容量测试。
为什么 Meta 把桌面部署放在发布主线
Meta 把两台 M5 Ultra Mac Studio 作为 Muse Spark Open 的桌面运行示例。
官方发布文称,每台 M5 Ultra 可使用最高 512GB 统一内存,两台机器合计约 1TB,配合 MLX 和机器间的高速互联承载 NVFP4 权重。
这不是“普通电脑单机运行 816B 模型”的承诺,而是一套明确的硬件组合。Meta 还列出四台 256GB 统一内存 Mac Studio 的方案;开发者需要依据权重格式、上下文长度和并行实现选择配置。
在 NVIDIA 路线上,官方文档给出的 NVFP4 起步配方是 4 张 B300 做 TP4/EP4,BF16 则是 8 张 B300 做 TP8/EP8。
SGLang 文档还提供了 NVFP4 的 DFlash2 推测解码和 HiCache 配置,但这些都是特定硬件与框架的部署示例,不是最低硬件要求。
长程 Agent 的卖点,不只是把窗口做大
Muse Spark Open 的核心使用场景是长程 Agent:读代码、规划修改、调用工具、检查结果,再根据失败继续修正。
Meta 开发者文章把它定位在编程和客服 Agent 等长时间任务;模型页也强调代码编写、原生多模态感知和端到端 Agent 工作流。
官方给出的能力组合包括:跨文件代码修改、视频与图片理解、工具调用、多 Agent 编排,以及对长历史的持续处理。实际系统仍要由应用负责工具定义、权限、执行结果回传和终止条件,模型不会因为下载了权重就直接访问本地环境。
Meta Research 发布页还介绍了在 Apple Silicon 上使用 Muse Code 的案例:包括修改开源 iOS 项目,以及让 DaVinci Resolve 按帧查看素材并生成裁剪结果。这些是官方展示案例,不等于所有代码仓库和桌面软件都能一次完成。
评测要看设置,不能只看一个名次
Meta 模型页的评测表覆盖 Agent、知识与推理、代码和带工具多模态任务,但结果应连同推理强度和测试框架阅读。
页面标注 Muse Spark Open 使用 xhigh 推理设置,并把 DeepSWE、Terminal-Bench、JobBench、MCP-Atlas、GDPval-AA v2 等结果放在同一张表中。
Meta Research 没有把这些分数写成所有场景的保证;发布文强调的是长程任务、复杂软件工程和多步推理的目标。开发者做选型时,应固定任务集、工具环境、上下文长度和预算,记录完成率、工具调用错误、耗时与输出成本。
现在如何开始
没有 816B 级硬件时,可以先用首发托管平台验证任务,再决定是否下载权重。
Meta 列出的首发平台包括 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter 和 Together AI;不同平台的模型 ID、上下文上限和价格可能不同,以各自页面为准。
需要本地权重时,官方文档建议先安装 Hugging Face CLI,并按硬件选择 BF16 或 NVFP4 仓库。下面只展示下载命令,实际执行前需要完成 Hugging Face 的模型许可申请,并准备足够磁盘:
python3 -m pip install -U huggingface_hub

# BF16:约 1.65 TB 权重
hf download meta-models/Muse-Spark-Open-816B-A42B \
  --local-dir ./muse-spark-open

# NVFP4:约 537 GB 权重
hf download meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
  --local-dir ./muse-spark-open-nvfp4
下载后的目录包含 tokenizer、chat template、config.json 和 processor 配置。先用官方 Transformers 文档检查 tokenizer,再选择 SGLang、vLLM、MLX 或其他已列出的运行时。本文没有下载 1TB 级权重,也没有运行 GPU 推理。
开放权重不等于无条件商用
**Muse Spark Open 使用 Muse Model License,许可证包含署名、使用政策和 Model as a Service 商业条款。**HF 模型元数据将许可证标为 muse-model-license,并要求接受门控表单;许可证文件为 LICENSE.md,同时附有 USE_POLICY.md。
许可证允许使用、复制、修改、微调、蒸馏、合并、发布和分发,但分发需要保留许可证、版权和使用政策,并在产品或服务界面、文档或设置中显著展示“Built with Muse Spark Open”。
如果自身或关联方经营 MaaS,且连续 12 个月合并收入超过 2000 万美元,在提供模型或衍生模型服务前还需通知 Meta 并签署书面协议。面向终端用户的部署还要遵守使用政策。
这使得 Muse Spark Open 的开源价值很清晰:开发者可以获得权重和多运行时支持,同时需要把许可证和安全边界纳入上线流程。本文数据截至 2026 年 10 月 16 日,发布日期、模型规格和部署范围均以 Meta 官方页面、开发者文档及模型仓库为准。
参考资料
Meta Research 发布公告:https://research.meta.ai/blog/muse-spark-open
Meta 开发者文章《Build with Muse Spark Open》:https://dev.meta.ai/resources/blog/build-with-muse-spark-open
Meta Muse Spark Open 模型页:https://dev.meta.ai/models/muse-spark-open/
Meta 获取模型文档:https://dev.meta.ai/docs/muse-spark-open/get-the-model
Hugging Face 模型卡:https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
Hugging Face Muse Spark Open 集合:https://huggingface.co/collections/meta-models/muse-spark-open
Hugging Face 模型元数据 API:https://huggingface.co/api/models/meta-models/Muse-Spark-Open-816B-A42B
七牛云 AI 大模型企业订阅:https://www.qiniu.com/ai/plan