Agent 记忆失效:为什么 AI Agent 总在犯同样的错
发布日期:2026-10-16 数据来源:GitHub API 实测 + arXiv API + Anthropic 官方文档
AI Agent 记忆失效指的是智能体在多次任务中反复犯同一类错误的现象——它能记住事实,却无法把经验沉淀成决策能力。2026 年 10 月,开发者社区的一篇实践文章揭示了这一反差:给 Agent 塞入更多历史上下文并未稳定提升表现,某些配置下性能反而下降;真正有效的路径是把记忆做成 Capture、Evaluate、Consolidate、Retrieve、Update 五环节的学习闭环,并在检索时采用渐进披露而非最大化召回。同期学界在递归自我改进方向给出呼应证据,开源侧也已形成规模,mem0、hindsight、OpenViking、cognee 四款项目在 GitHub 上合计收获近 19 万个 Star。
一、记忆失效:一个对冲基金 Director 的原话
AI Agent 记忆失效的本质是:Agent 记住了事实,却没有从错误中提炼出判断。
一位对冲基金 Director 对做 Agent 的团队说过一句话,被完整记录在开发者社区的实践文章里:
"问题不是我们做不出 Agent,而是团队里第二个人一上手,所有东西就归零了。"(意译)
这个场景把问题说透了。一个 Agent 可以执行上千个任务,明天仍然会用和今天一样的方式踩同一个坑。相比之下,一位资深分析师不会每天从零开始——他积累的不是更多信息,而是判断力:哪些信号值得注意、哪条路通常走不通、哪个看似合理的决定值得再确认一次。
于是问题变成了一个二选一:我们造的是记得更多的 Agent,还是会变好的 Agent?
二、记忆错觉:给 Agent 塞更多上下文,效果反而更差
"上下文越多 Agent 越聪明"是一个被广泛接受、但经不起独立评测的假设。
这个假设背后是一套很自然的做法:把历史案例、之前的执行记录、检索到的文档、累积的知识一股脑喂给 Agent。这个团队最初也这么认为,于是不断加码上下文,然后跑独立评测,结果是——更多上下文并没有持续带来更好的表现,某些配置下性能反而恶化。
更反直觉的发现出现在他们开始做减法之后:手动精简上下文、重构指令、精心筛选 Agent 能看到的信息,结果是一些看起来更完整、信息更多的配置,表现反而不如更简单的配置。
结论是一句反常识的话:有时候让 Agent 更聪明的办法,是让它少记一点。
三、事实不是经验
这是整篇文章里最有价值的一个区分:Facts(事实)和 Learnings(经验)根本不是一类东西。
事实描述的是世界:某客户的合同下个月到期、某个 API 需要鉴权、某个仓库里放着计费服务。这些属于数据库、知识图谱或文档存储。
经验描述的则是怎么做:
排查生产故障时,先看最近的部署变更,而不是去调试无关组件
两个来源冲突时,优先采信近期验证过的那个,而不是语义上最相似的那篇
后者不是事实,是从经历里提炼出来的判断。一条经验至少包含四要素:当时做了什么动作、结果如何、为什么会这样、以及这条教训是否应该影响未来的决策。
执行日志只能告诉 Agent 做了什么,经验记忆才能告诉它下次该怎么做、以及为什么。 这句话可以直接作为判断一套记忆方案是否合格的标尺——如果一个系统只有前者,它就是个日志系统。
四、记忆必须是闭环,不是一个仓库
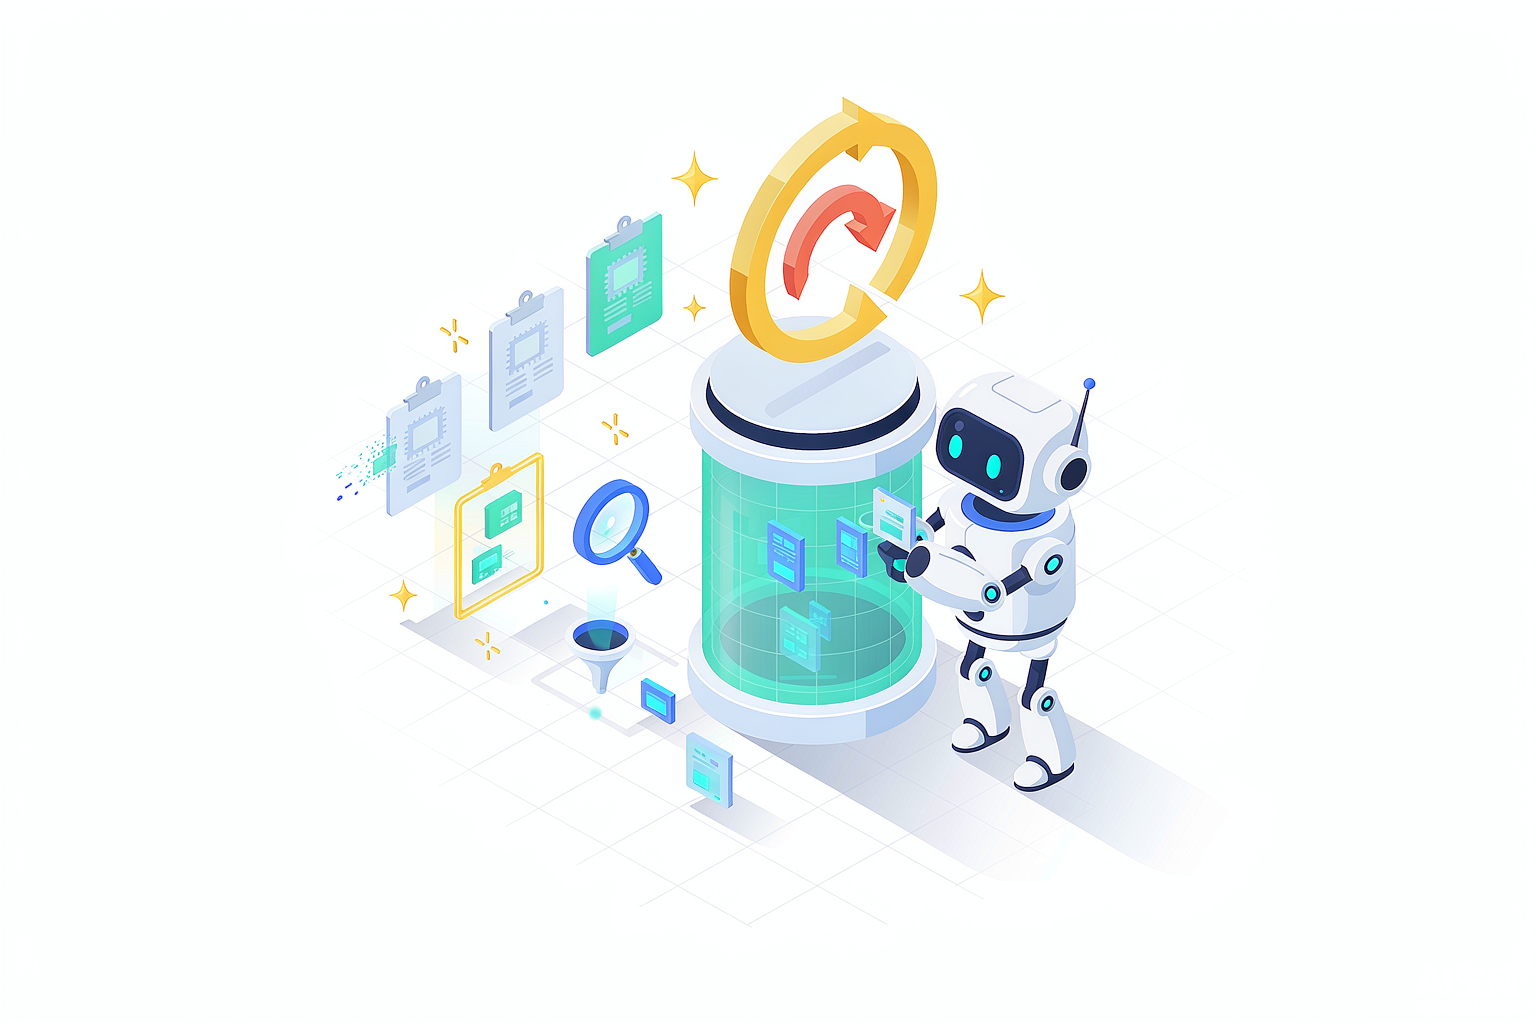
一个可用的 Agent 记忆系统需要跑完五个环节的完整生命周期,缺一环就会退化成日志。
其中两个环节最容易被做错,也最能拉开差距。
Consolidate 的关键动作是"合并"。 十条相似的失败不应该变成十条记忆,而应该被固化成一个可复用的教训,并且保留"这在什么条件下成立"的边界条件。
Retrieve 的正确目标不是最大召回率,而是在对的时间给出对的信息。 这就是渐进披露(Progressive Disclosure)的思路:只给 Agent 当前决策所需的最小相关信息,更多上下文等它真的需要时再展开。即使一条记忆完全准确,在错误的时机被取出来也会适得其反。
五、开源 Agent 记忆方案横评
Agent 记忆已经不是从零自研的问题,GitHub 上已有成熟度不低的开源方案可选。
以下数据为 2026 年 10 月 16 日通过 GitHub API 实测:
hindsight 的定位差异最值得注意。 它的官方文档明确写道:多数 Agent 记忆系统专注于回忆对话历史,而 hindsight 专注于让 Agent 学会东西,而不只是记住东西。它在 LongMemEval 这一记忆系统常用基准上取得了当前最优表现,且基准数据由 Virginia Tech Sanghani Center 与《华盛顿邮报》的研究人员独立复现(其他方案的分数多为厂商自报),对应论文为 arXiv 2512.12818。
接入形态也在向 MCP 收敛。 以 engram 为例(7,260 Star,MIT 协议),它采用 Agent 无关的单二进制设计,用 SQLite 加 FTS5 做存储,同时提供 MCP Server、HTTP API、CLI 和 TUI 五种接入方式,支持 macOS、Linux、Windows 三平台。记忆能力通过标准化的 MCP 协议挂载,意味着它不必侵入 Agent 主程序——如果团队不想自己维护本地记忆进程,也可以把 Agent 的记忆与工具编排托管到标准化的 MCP 服务上,例如七牛云的 MCP 服务支持免本地部署构建 Agent 应用。
六、Claude Code 的两套记忆机制
Claude Code 每次会话都从全新的上下文窗口开始,靠两套机制把知识跨会话携带过去。
Anthropic 官方文档给出的对比很清晰:
官方文档特别指出一个常被误解的点:Claude 把这两套机制当作上下文(context)处理,而不是强制配置(enforced configuration)。 如果需要无论 Claude 如何判断都禁止某个动作,得改用 PreToolUse Hook;指令写得越具体、越精简,Claude 的遵循度越高。
子 Agent(Subagent)也可以维护各自的 auto memory。文档在排错章节还列了一条常见症状:"/compact 之后指令像是丢了"。
七、学术界在做什么:递归自我改进
2026 年 10 月 14 日,arXiv 同一天出现三篇从不同角度切入"Agent 如何从失败中变好"的论文。
EGCForest(arXiv 2610.19836)针对企业群聊提出多视图分层记忆框架,把不可变的消息日志组织成三片互补的"森林":Channel 森林管时间线,Actor 森林管说话人相关的上下文,Artifact 森林管交付物生命周期。它给出的判断很直接——RAG 的独立分块检索和记忆系统的摘要式归并,都无法可靠地还原这种跨线程、跨频道、跨时间的分布式证据。
AdaRSI(arXiv 2610.20474)处理具身智能体的失败归因问题。它指出既有做法的局限:要么只优化 harness 而执行器冻结,导致无法补上缺失的动作;要么在持续失败上训练执行器,却从不追问这次失败究竟是"怎么调用"的问题还是"能做什么"的问题。AdaRSI 的做法是先用编程 Agent 改进技能与 harness,再从保存的状态重试失败的子步骤,只微调那些持续不可靠的部分。
SwarmRSI(arXiv 2610.20431)把递归自我改进放到科学 Agent 集群里,用反馈引导的集群突变来同时修正假设与实现,并通过互补重组让一个 Agent 的部分结果能被其他 Agent 复用。
三篇论文的共同点是:都在解决同一个问题——失败发生之后,系统到底改了什么。
常见问题
Q:Agent 记忆和 RAG 有什么区别? RAG 解决的是"外部知识去哪找",Agent 记忆解决的是"过去发生了什么、下次该怎么判断"。前者检索的是静态文档,后者沉淀的是带因果的经验——为什么做了某个动作、结果如何、下次在什么条件下还该这么做。EGCForest 的研究指出,两者都不能独立还原分布在时间线、说话人和交付物之间的证据。
Q:Claude Code 的 auto memory 值得开吗? 适合存放你的偏好、你给出的纠正,以及 Claude 无法从代码推导出的项目上下文;编码规范和工作流应该写在 CLAUDE.md 里。需要注意的是 auto memory 只加载前 200 行或 25KB,且官方把它当上下文而非强制配置,真正需要强约束的规则应该用 PreToolUse Hook。
Q:团队多人共用一个 Agent,记忆怎么共享? 这正是第一节那个对冲基金 Director 提出的痛点。可行路径是"人写共享层 + Agent 写经验层":团队共识、术语表、流程规范写进项目级 CLAUDE.md 并纳入版本管理;Agent 从纠正中积累的经验走 auto memory。这样新人上手时共享的是团队资产,而不是从零开始。
Q:接入记忆方案时本地服务和 MCP 怎么选? 本地二进制的优势是数据不出机器、延迟低,但需要自己维护进程和存储;MCP 方式的优势是接入标准统一、不侵入 Agent 主程序,适合已经有多套 Agent 运行时、想把记忆能力做成共享服务的团队。
Q:为什么"给 Agent 更多上下文"会变差? 因为上下文不是记忆。堆叠进来的大量信息里,相当比例与当前决策无关,Agent 需要先消耗注意力做筛选。更糟的是,新增内容会稀释关键信号的显著性——一条精确的经验淹没在二十条相似但不相关的记录里,效果反而不如只给它这一条。
延伸资源
Anthropic Claude Code 记忆机制文档:https://docs.claude.com/en/docs/claude-code/memory
MCP 服务标准化模型能力编排:https://developer.qiniu.com/aitokenapi/12984/mcp-user-manual
EGCForest:企业群聊的 Agent 记忆组织(arXiv 2610.19836)
Hindsight 记忆基准实时榜:https://benchmarks.hindsight.vectorize.io/
总结
Agent 记忆失效的根源不是"记不住",而是"记住了却没变好"。区分 Facts 和 Learnings 是整个问题的起点——前者该进数据库,后者才该进记忆;把记忆做成 Capture 到 Update 的五环节闭环、并用渐进披露替代最大化召回,是目前被验证更有效的做法。
据 Anthropic 官方文档表示,Claude Code 通过 CLAUDE.md 与 auto memory 两套机制跨会话携带知识,并支持子 Agent 独立维护记忆;hindsight 项目方则声称其在 LongMemEval 基准上取得当前最优表现,该数据已由 Virginia Tech Sanghani Center 与《华盛顿邮报》独立复现。本文内容基于 2026 年 10 月 16 日的 GitHub API 实测、arXiv API 检索与 Anthropic 官方文档整理,各项目 Star 数与论文结论可能随时间变化,建议以官方仓库与论文原文为准并定期更新。