claude-mem 是什么:10 万星的 Agent 跨会话记忆插件,真能省 Token 吗(2026 年 10 月)
发布日期:2026-10-30 | 信息来源:claude-mem GitHub 仓库与 v15.6.0 发布说明、docs.claude-mem.ai 官方文档
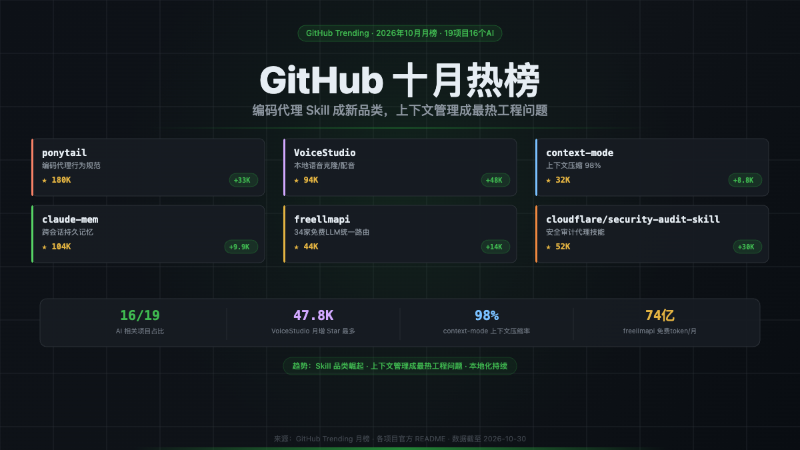
claude-mem 是开发者 Alex Newman(GitHub 账号 thedotmack)开源的 Coding Agent 持久记忆插件,2025 年 8 月发布,采用 Apache-2.0 协议。截至 2026 年 10 月 30 日,它在 GitHub 上已有约 10.5 万星,最新版本是 10 月 29 日发布的 v15.6.0。它通过生命周期钩子记录 Agent 每次调用工具的过程,交给一个后台模型压缩成"观察记录"存进本地 SQLite,下次开会话时只注入一份精简索引,Agent 需要哪条再按 ID 取全文。官方文档的示例里,同样的历史信息,一次性塞给模型要 35,000 Token,按索引取用只要约 920 Token。不过 claude-mem 本身也要消耗 Token:后台压缩默认走用户的 Anthropic 套餐。这部分可以改接任意 OpenAI 兼容接口,用便宜的小模型跑,这才是真正决定它划不划算的地方。
为什么 10 万人给它点了星
Coding Agent 每开一个新会话都是"失忆"状态。昨天排查过的 Bug、定下的目录结构、踩过的坑,今天都要重新读文件、重新解释一遍,这些重复阅读就是 Token 账单里最大的一块。
claude-mem 解决的就是这一件事:让 Agent 记住自己做过什么。它目前支持的工具已经不止 Claude Code:
Claude Code(插件市场安装)
OpenCode 1.3.4 及以上,包括 OpenCode 2
T3 Code(含 Codex 和 Claude Code 两种 provider)
Antigravity CLI、Pi、DeepSeek Harness、OpenClaw 网关等
它的更新也很频繁:10 月 28 日到 29 日,三天里连发了 v15.4.0、v15.5.0、v15.6.0 三个版本。其中 v15.5.0 新增了"OpenAI 兼容接口的观察记录批处理"。
它是怎么工作的:钩子、观察者、三层检索
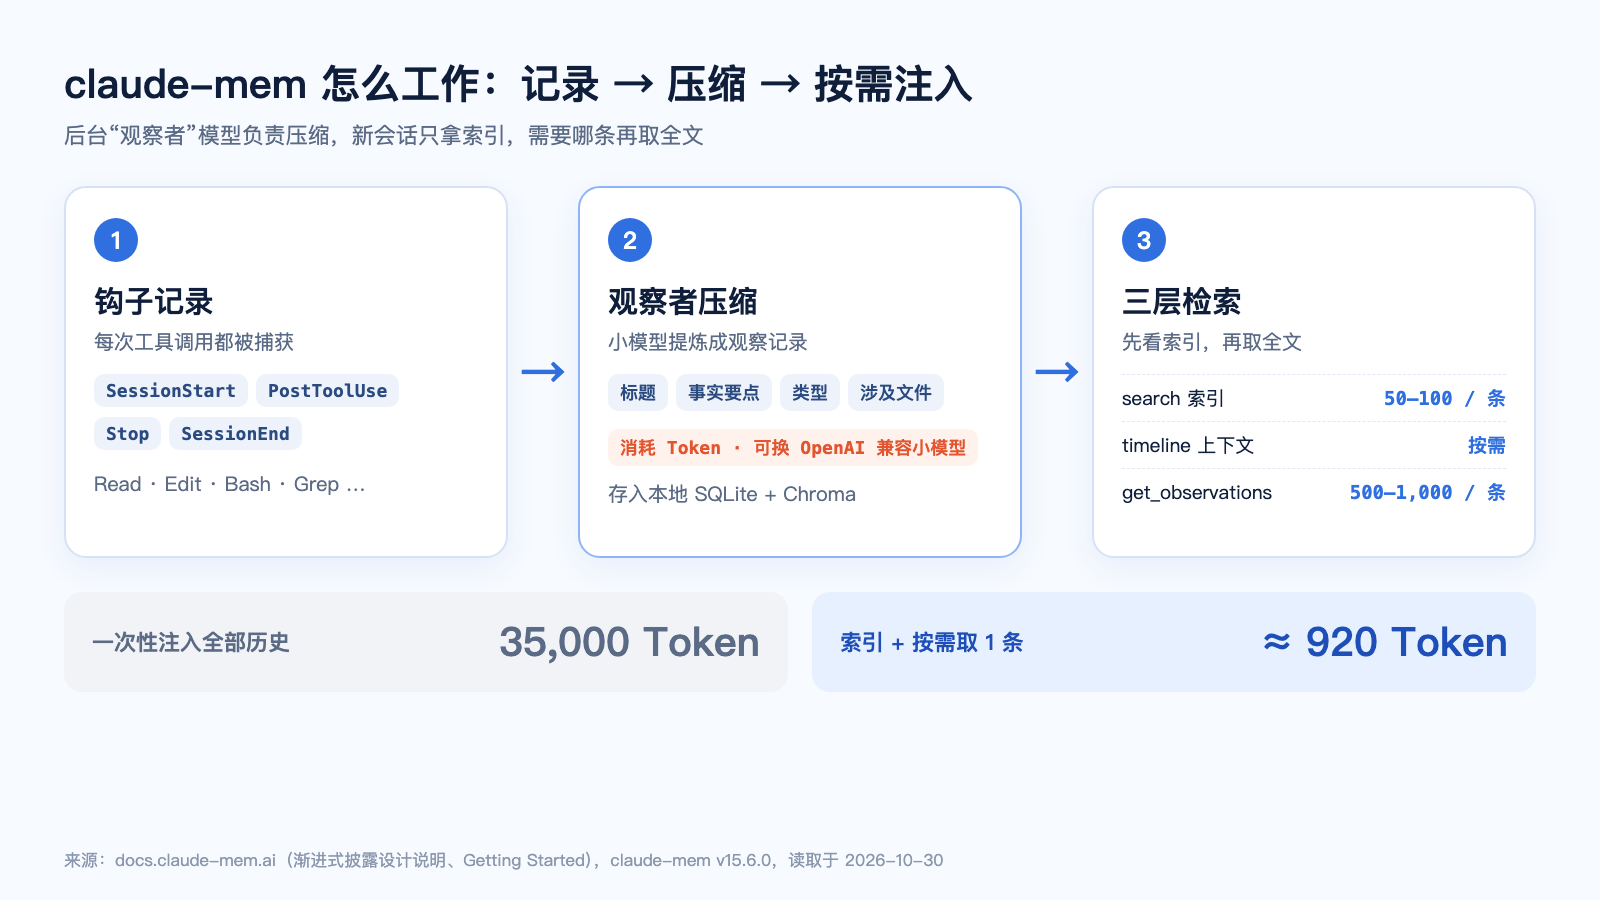
claude-mem 的架构可以拆成三步:
记录:在 Agent 的 SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop、SessionEnd 六个生命周期节点挂钩子,Read、Edit、Bash、Grep 等每一次工具调用都会被捕获。
压缩:一个后台"观察者"模型把原始记录提炼成标题、事实要点、类型(决策 / Bug 修复 / 功能等)和涉及文件,存进本地 SQLite,并配合 Chroma 向量库做混合检索。会话结束时,再自动生成一份包含"做了什么、学到什么、下一步"的总结。
注入:新会话启动时,默认注入最近 50 条观察记录的索引。
关键在第 3 步的"渐进式披露"。它提供的 MCP 检索工具分三层:
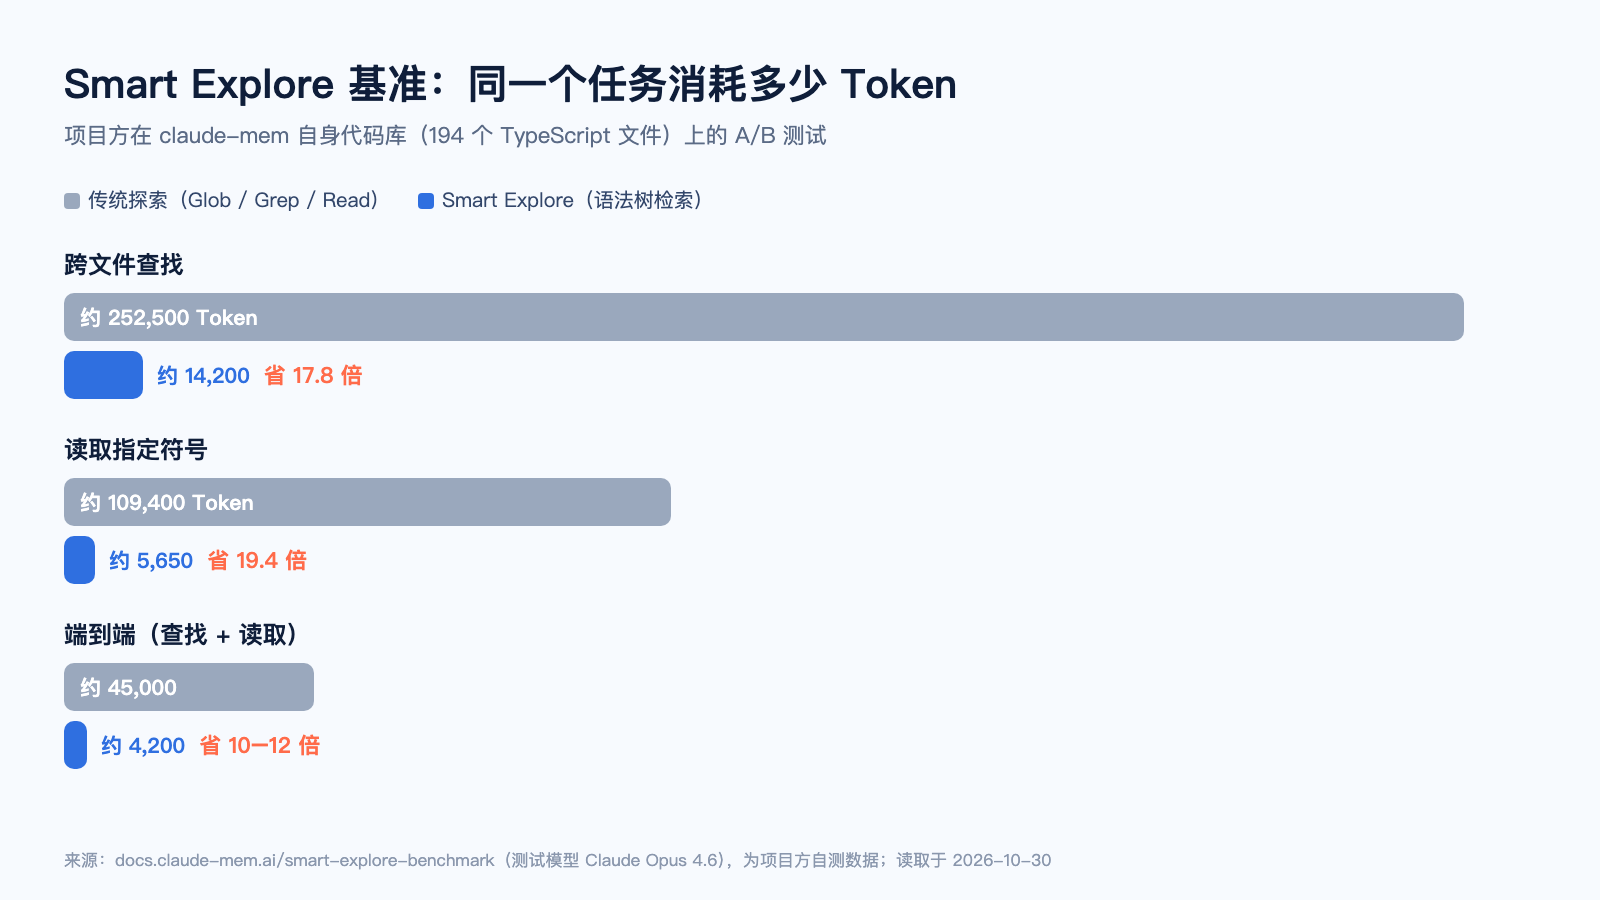
官方说法是"先筛再取,约省 10 倍 Token"。另一组数据来自它的 Smart Explore 基准测试:在 194 个 TypeScript 文件的代码库里做跨文件查找,基于语法树的 Smart Explore 用了约 1.4 万 Token,用 Glob、Grep、Read 的传统探索方式用了约 25 万 Token,差 17.8 倍。需要注意,这是项目方在自己代码库上做的测试,你的项目实际能省多少,要自己测。
容易被忽略的一笔账:记忆本身也要花 Token
claude-mem 在主会话里省下 Token,但后台的观察者每处理一次工具调用,都要调用一次模型。官方配置文档里有一段很直白的提醒:一次多 Agent 工作流可能派出几十到几百个子 Agent,每个子 Agent 的每次工具调用都会生成一条观察记录,"单次运行就可能产生成百上千条低价值记录",足以把免费额度打到 429 限流。
观察者默认用的是 Claude Haiku,跑在你的 Anthropic 套餐里,和主会话抢同一份额度。安装时登录 claude-mem 账号可以试用官方托管的观察者 30 天,试用到期后会自动回落到 Anthropic 套餐。
官方文档对这件事的判断是:观察记录提取量大、格式固定,"不需要前沿模型"。所以更划算的做法是把观察者换成便宜的小模型。claude-mem 支持把 CLAUDE_MEM_PROVIDER 设为 openai-compatible,接任何提供 /chat/completions 的接口,内置了 DeepSeek、MiniMax、讯飞星火、Ollama、vLLM 等预设,也可以自定义地址。
实操:安装 claude-mem,并把观察者换成小模型
下面以 Claude Code 为例,大约 10 分钟。
第 1 步:安装。 官方提醒,npm install -g claude-mem 只装 SDK,不会注册钩子,必须用下面的命令:
# 跳过账号登录,稍后自己配置观察者
CLAUDE_MEM_ONLINE_OPTIN=false npx claude-mem install
在 Claude Code 里也可以用插件市场安装:先执行 /plugin marketplace add thedotmack/claude-mem,再执行 /plugin install claude-mem。用 OpenCode 的话,把命令换成 npx claude-mem install --ide opencode。
第 2 步:配置观察者模型。 编辑 ~/.claude-mem/settings.json。以七牛云 Token Plan 为例,它的订阅 Key 兼容 OpenAI 接口,覆盖的模型里有 DeepSeek V4.1 Flash、GLM-5.3-Flash 这类轻量模型:
{
  "CLAUDE_MEM_PROVIDER": "openai-compatible",
  "CLAUDE_MEM_OPENAI_COMPAT_BASE_URL": "https://api.qnaigc.com/v1",
  "CLAUDE_MEM_OPENAI_COMPAT_MODEL": "deepseek/deepseek-v4.1-flash",
  "CLAUDE_MEM_OPENAI_COMPAT_OBSERVATION_BATCH_SIZE": "8",
  "CLAUDE_MEM_SKIP_AGENT_TYPES": "workflow-subagent,Explore,Plan",
  "CLAUDE_MEM_MODE": "code--zh"
}
Key 不要写在 settings.json 里,单独放进 ~/.claude-mem/.env:
echo 'OPENAI_COMPAT_API_KEY=你的订阅专用Key' >> ~/.claude-mem/.env几个配置项的作用:
OBSERVATION_BATCH_SIZE:把连续的几条观察记录合并成一次请求,取值 1 到 32,默认 1。调大能减少请求次数。SKIP_AGENT_TYPES:跳过指定类型子 Agent 的记录,避免多 Agent 工作流刷出大量低价值记录。code--zh:让观察记录用简体中文生成,内置模式,不用额外安装。模型 ID 以控制台模型广场显示的为准。
第 3 步:重启并验证。
npx claude-mem restart重新打开 Claude Code,新会话开头会出现上次工作的索引。浏览器打开 worker 启动时打印的地址,在 /viewer 页面可以查看所有记忆、会话和设置。
第 4 步:核对观察者用了多少。 跑一周后,到所用平台的用量明细里看观察者消耗了多少 Token。如果用的是七牛云 Token Plan,每天 18:00 到次日 08:00 DeepSeek V4 系列按 0.3 倍计积分,晚上干活的话这部分成本更低。
什么情况下值得装
值得装:在同一个仓库里连续开发几天甚至几周,经常要跟 Agent 重新解释"上次做到哪了"。
值得装:团队想共享踩坑记录。它的 TeamBrain 功能可以让每个人自己选择分享哪些记录。
先别装:大多是一次性的小脚本、临时问答,跨会话记忆用不上,反而要多付观察者的钱。
装之前想清楚:大量使用多 Agent 并行工作流的话,一定先配好
SKIP_AGENT_TYPES,否则观察记录的数量会远超预期。
隐私方面,记忆默认存在本地 ~/.claude-mem/。用 <private> 标签包住的内容不会被存储。v15.5.0 还修复了对 token、secret、api_key 等字段的自动脱敏。截图记录默认关闭,云同步也要手动开启。
常见问题
Q:claude-mem 和 Claude Code 自带的 CLAUDE.md 有什么区别? CLAUDE.md 是你手写的固定说明,每次全文加载;claude-mem 是自动记录 Agent 实际做过的事,按索引按需取用。两者可以同时用:规范写进 CLAUDE.md,过程记忆交给 claude-mem。
Q:不想用 Anthropic 额度,能完全用本地模型吗? 可以。观察者支持 Ollama、LM Studio、vLLM 预设,设好 CLAUDE_MEM_OPENAI_COMPAT_MODEL 为本地已加载的模型 ID 即可,不需要 Key。没设模型 ID 时会回落到 Claude。
Q:观察者的额度用完了会怎样? 由 CLAUDE_MEM_QUOTA_FALLBACK_PROVIDER 决定:默认回落到你的 Anthropic 套餐,也可以设为另一个 OpenAI 兼容接口,或者设为 off 直接等待恢复。
总结
claude-mem 用"钩子记录 + 小模型压缩 + 索引按需取用"解决了 Coding Agent 跨会话失忆的问题。官方数据显示,按需检索能把注入的上下文压缩一个数量级。但它的观察者本身也在持续消耗 Token,把观察者换成便宜的 OpenAI 兼容小模型,并过滤掉子 Agent 的记录,才能让账单真正降下来。本文信息基于 2026 年 10 月 30 日的 claude-mem v15.6.0 和官方文档,项目更新很快,配置项请以 docs.claude-mem.ai 最新说明为准。
延伸阅读
claude-mem GitHub 仓库:https://github.com/thedotmack/claude-mem
claude-mem 配置文档:https://docs.claude-mem.ai/configuration
OpenAI 兼容观察者配置:https://docs.claude-mem.ai/usage/openai-compatible-provider
Smart Explore 基准测试:https://docs.claude-mem.ai/smart-explore-benchmark
七牛云 Token Plan(多模型 API 统一接入):https://www.qiniu.com/ai/plan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free