一文读懂 DeepInfer:DeepSeek 线上服务同款推理引擎全面开放
发布日期:2026-10-20 | 话题:DeepInfer / DeepSeek 推理框架 / 大模型推理开源
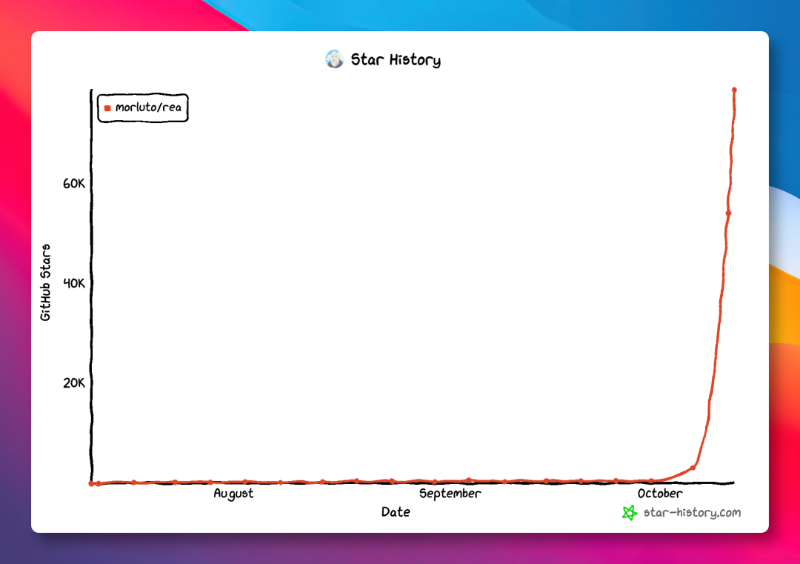
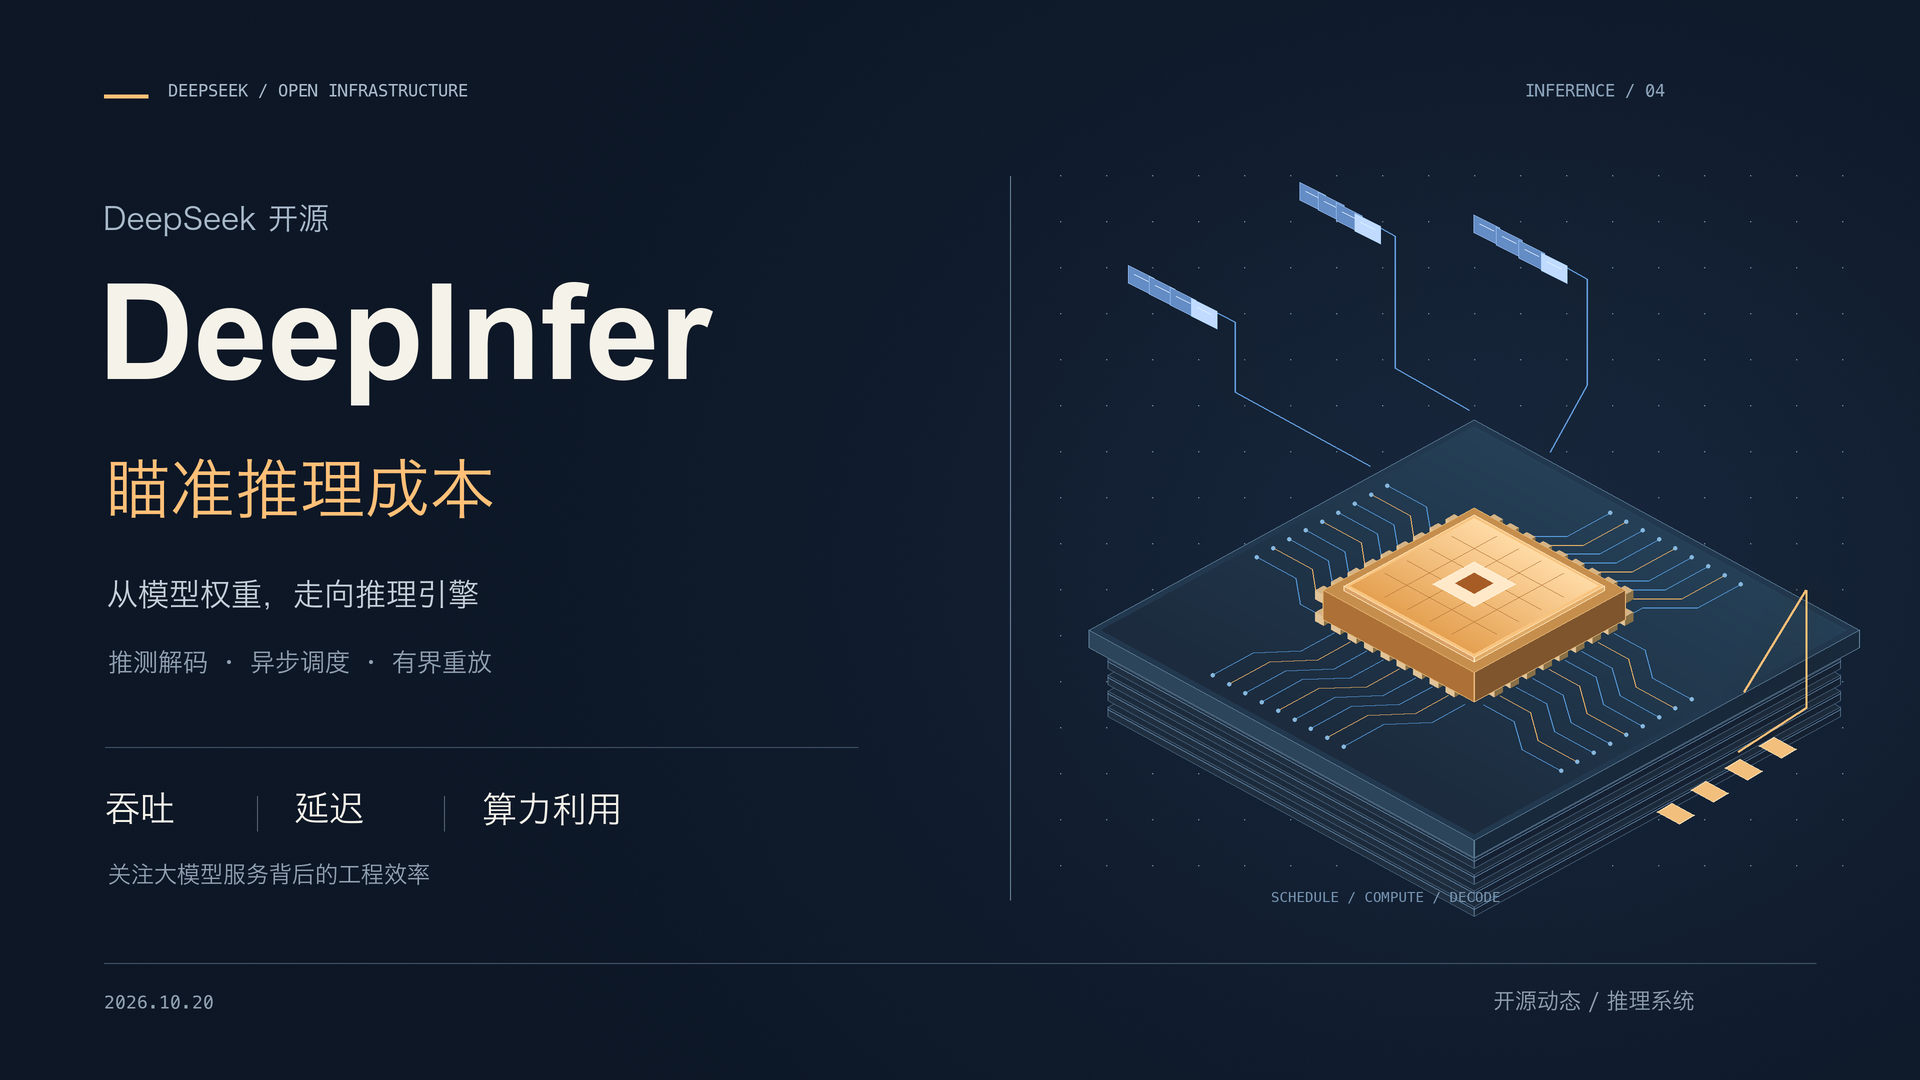
DeepInfer 是 DeepSeek 于 2026 年 10 月 16 日正式开源的生产级大模型推理框架,Apache 2.0 许可,当前已支持 DeepSeek-V4.1-Flash 的大规模离线推理,同步开源的 deepseek-recipe 组件提供与官方 API 完全对齐的 Token 编解码逻辑。框架核心能力涵盖分布式并行(Attention DP / MoE EP + EPLB)、投机解码(DSpark + 置信度调度验证)、SWA Bounded Replay、结构化输出和异步调度,兼容英伟达 SM100(Blackwell)及华为昇腾 950 两种硬件平台。开源仓库上线四天 Star 数达 598,deepseek-recipe 仓库同期 496 Stars,技术细节另见 DeepSeek 知乎报告。本文从框架定位、核心技术组件、硬件要求、快速上手、与 vLLM/SGLang 的关系,以及对开发者和企业的实际影响逐一展开。
DeepInfer 是什么
DeepInfer(仓库:deepseek-ai/DeepInfer)是支撑 DeepSeek 线上大规模推理服务的内部推理引擎,此次开源发布的是离线推理版本,包含在生产环境中验证过的核心调度与算子能力。
官方定义:High-performance, large-scale inference framework for DeepSeek models,Apache License 2.0,Python 3.12 + CUDA 13(英伟达)或 CANN 9.2(昇腾)环境运行。
DeepSeek 同时开源了配套组件 deepseek-recipe——用 Rust 编写、提供 Python 绑定的编解码库,负责将不同格式的 API 请求(Messages、Chat Completions、Responses)统一转换为内部 Conversation 格式,再渲染为模型提示词并编码为 Token ID,确保社区自托管时与 DeepSeek 官方 API 行为完全对齐。
核心技术组件
DeepInfer 集成了 DeepSeek 此前陆续开源的多个底层算子库,形成完整的推理栈:
底层算子层
并行与调度层
Attention DP / 均衡 CP:数据并行注意力计算,支持均衡的上下文并行
MoE EP + EPLB:专家并行配合专家负载均衡,减少热点专家的计算瓶颈
异步调度(零开销批调度器):CPU 批组织与设备计算重叠,默认开启
推测解码层
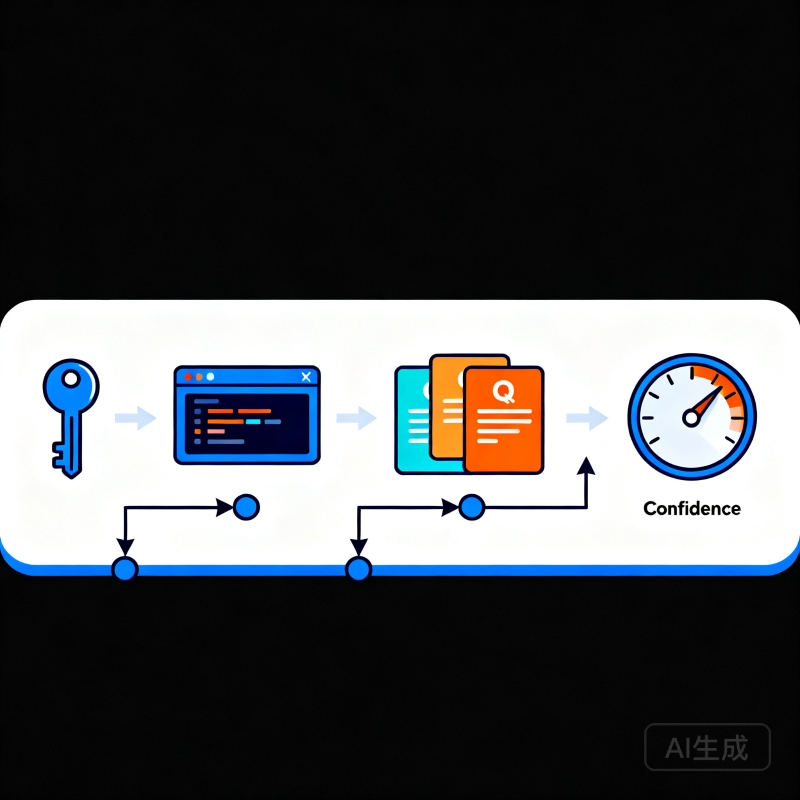
DSpark + 置信度调度验证(Confidence-Scheduled Verification):用草稿 token 加速解码,同时根据置信度估计动态调度验证时机。通过环境变量 DEEPINFER_ENABLE_MTP_VARLEN=1 启用,DEEPINFER_USE_NEXTN_DECODE 控制最大草稿长度(默认 5)。
SWA Bounded Replay
Decoder SWA Bounded Replay:通过只重放有界后缀来减少 Decode 阶段的 Prefill 计算量。对 V4.1 的默认配置:DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact,DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140,保留后缀需覆盖 SWA 窗口加最大回溯长度。
确定性推理
设置 DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0 并为 SamplingParams 传入固定 seq_seed,可实现相同输入必然产生相同输出的确定性推理(仅限英伟达平台)。
deepseek-recipe:官方对齐的编解码组件
deepseek-recipe(仓库:deepseek-ai/deepseek-recipe)以 Rust 实现核心逻辑,提供 Python 绑定,覆盖以下能力:
格式转换:Messages / Chat Completions / Responses 三种 API 格式互转,支持流式响应和完整响应
提示词渲染:DeepSeek V4 和 V4.1 的对话渲染,含思考模式(thinking mode)与工具调用
Token 上限自动推算:
ConversationRequest::resolve_max_tokens根据提示词长度和上下文窗口自动确定max_tokens——普通模式默认 8192,思考模式 65536,思考模式 max effort 131072结构化输出:支持
json_schema和regex两种约束格式多模态:图像以 base64 或外部 URL 提供,由 OpenCV 预处理后接入 V4.1
对于自托管推理服务的开发者,deepseek-recipe 解决了一个常见痛点:自行实现的提示词渲染与 DeepSeek 官方存在细微差异,导致模型行为不一致。使用官方同款组件可消除这类偏差。
硬件要求与环境
DeepInfer 当前支持两类硬件平台:
来源:DeepInfer README,deepseek-ai/DeepInfer,2026 年 10 月。
性能基准测试在 Prefill 4 张 SM100 GPU + Decode 64 张 SM100 GPU(各在一个 scale-up 域内)的配置下完成,可通过 examples/sweep/run_sweep.sh 复现。
注意:此次开源版本为离线推理,生产级在线服务还需自行补充:KV 缓存系统、VE/Prefill/Decode 分离部署(引擎侧功能已基本实现)、以及跨数据并行副本的负载均衡。
快速上手
环境准备
# 英伟达平台
export DEEPINFER_ACCELERATOR=nvidia
./build.sh

# 昇腾平台
export DEEPINFER_ACCELERATOR=ascend
./build.sh
离线推理示例
# 默认加载 deepseek-ai/DeepSeek-V4.1-Flash-1017(首次运行自动下载到 HuggingFace cache)
python examples/offline_inference.py

# 使用本地权重
DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017 python examples/offline_inference.py
启用投机解码
DEEPINFER_ENABLE_MTP_VARLEN=1 DEEPINFER_USE_NEXTN_DECODE=5 python examples/offline_inference.py确定性推理
DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0 python examples/offline_inference.py与 vLLM / SGLang 的关系
DeepInfer README 明确注明:DeepInfer 最初主要基于 vLLM 构建,同时借鉴了 SGLang 和 TensorRT-LLM 的设计,并向这些项目的开发者致谢。
这意味着 DeepInfer 不是从零重写的竞品,而是在 vLLM 基础上针对 DeepSeek 自身架构(MLA 注意力、MoE 专家并行、SWA 滑动窗口注意力)进行深度定制优化的结果。对已经使用 vLLM 部署 DeepSeek 模型的团队来说,DeepInfer 提供了一个"官方调优版本"的参考基准和直接可用的替代方案。
常见问题
Q:DeepInfer 和 vLLM 部署 DeepSeek 的性能差距有多大?
官方在 4 张 SM100 GPU(Prefill)+ 64 张(Decode)的配置下提供了 Pareto 曲线图(吞吐 vs 延迟),但未直接给出与 vLLM 的对比数字。DeepInfer 集成了 FlashMLA、SWA Bounded Replay、DSpark 等针对 DeepSeek 架构的专项优化,理论上在相同硬件上可实现更优的吞吐/延迟曲线。具体差距建议在目标硬件上实测对比。
Q:deepseek-recipe 是否可以独立于 DeepInfer 使用?
可以。deepseek-recipe 是独立的编解码库,可接入任意推理后端(vLLM、SGLang、TensorRT-LLM 等)。对已有推理服务希望提升 API 兼容性的团队,单独集成 deepseek-recipe 即可获得与 DeepSeek 官方对齐的提示词渲染逻辑。
Q:消费级显卡(如 RTX 4090)能否运行 DeepInfer?
当前版本要求英伟达 SM100 架构(Blackwell 系列,如 H200/B200),不支持 Ampere/Ada Lovelace 架构的消费级显卡。面向消费级部署,vLLM + int4 量化仍是更实际的路径。
Q:开源版本是否包含在线服务能力?
此次开源为离线推理版本,KV 缓存系统和 Prefill/Decode 分离部署未包含在内。DeepSeek 公告表明后续新模型的推理代码和优化将持续更新至 DeepInfer 仓库。
Q:企业私有化部署是否可以直接用 DeepInfer?
Apache 2.0 许可允许商业用途,但当前版本缺少生产级在线服务所需的 KV 缓存和负载均衡组件,适合作为性能基准参考或离线批量推理场景。完整在线服务需在此基础上自行补充上述组件,或等待后续开源更新。
结语
DeepInfer 的开源意义不止于一个工具的发布。此前 DeepSeek 已陆续开放 FlashMLA、DeepGEMM、DeepEP、TileLang 等底层算子,本次将推理框架本身一并开源,形成从算子到调度的完整栈。对需要大规模自托管 DeepSeek 模型的企业来说,DeepInfer 提供了官方调优的参考实现;对 AI 基础设施社区来说,它公开了 DeepSeek 线上服务的核心调度思路——投机解码与置信度调度、SWA 有界重放、异步批调度的具体实现方式。对于需要同时调用 DeepSeek 和其他主流模型的团队,兼容 OpenAI 格式的推理服务(如七牛云 Token Plan)可在不自建推理栈的前提下,通过统一 API 接入 DeepSeek V4.1-Flash 等模型,按实际用量灵活控制成本。
本文数据来源:DeepInfer GitHub 仓库(deepseek-ai/DeepInfer)、deepseek-recipe 仓库(deepseek-ai/deepseek-recipe)、DeepSeek 官方公告,均基于 2026 年 10 月 20 日数据。
延伸资源
DeepInfer 仓库:https://github.com/deepseek-ai/DeepInfer
deepseek-recipe 仓库:https://github.com/deepseek-ai/deepseek-recipe
DeepSeek 知乎技术报告:https://zhuanlan.zhihu.com/p/2095560295930508953
七牛云 Token Plan(DeepSeek 多版本统一调用):https://www.qiniu.com/ai/plan