Muse Spark Open部署完整指南:HF申请、SGLang/vLLM启动与816B硬件配置
更新日期:2026年10月16日
本文按 Meta 官方发布页、开发者文档、Hugging Face 模型元数据和官方部署示例整理。命令已做静态核对,未在本机下载 537GB/1.65TB 权重,也未运行真实 GPU 推理或测吞吐。
Meta 在 2026 年 10 月 15 日发布 Muse Spark Open,并将它称为“目前能力最强的美国开放权重模型”。这句话有明确范围:是 Meta 对美国实验室开放权重模型的定位,不等于未经限定的全球排名。模型总参数 816B,每个 token 约激活 42B,原生支持文本、图片、音频和视频输入,文本输出,上下文窗口为 1,048,576 token,主要面向编码和长程 Agent 任务。
先理解“开放权重”意味着什么
开放权重允许开发者取得模型参数并自行选择推理框架,但下载权重不会自动获得代码执行、搜索、桌面控制或其他工具权限。工具定义、权限隔离、执行器和结果回传仍由 Agent 应用负责。
Muse Spark Open 是稀疏 MoE。816B 是总参数,42B 是每个 token 的激活量,不能把它当作 42B 稠密模型估算显存。官方列出的推理入口包括 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、MLX、llama.cpp 和 Unsloth;不同入口的版本、量化格式和硬件要求要分别核对。
硬件和权重格式怎么选
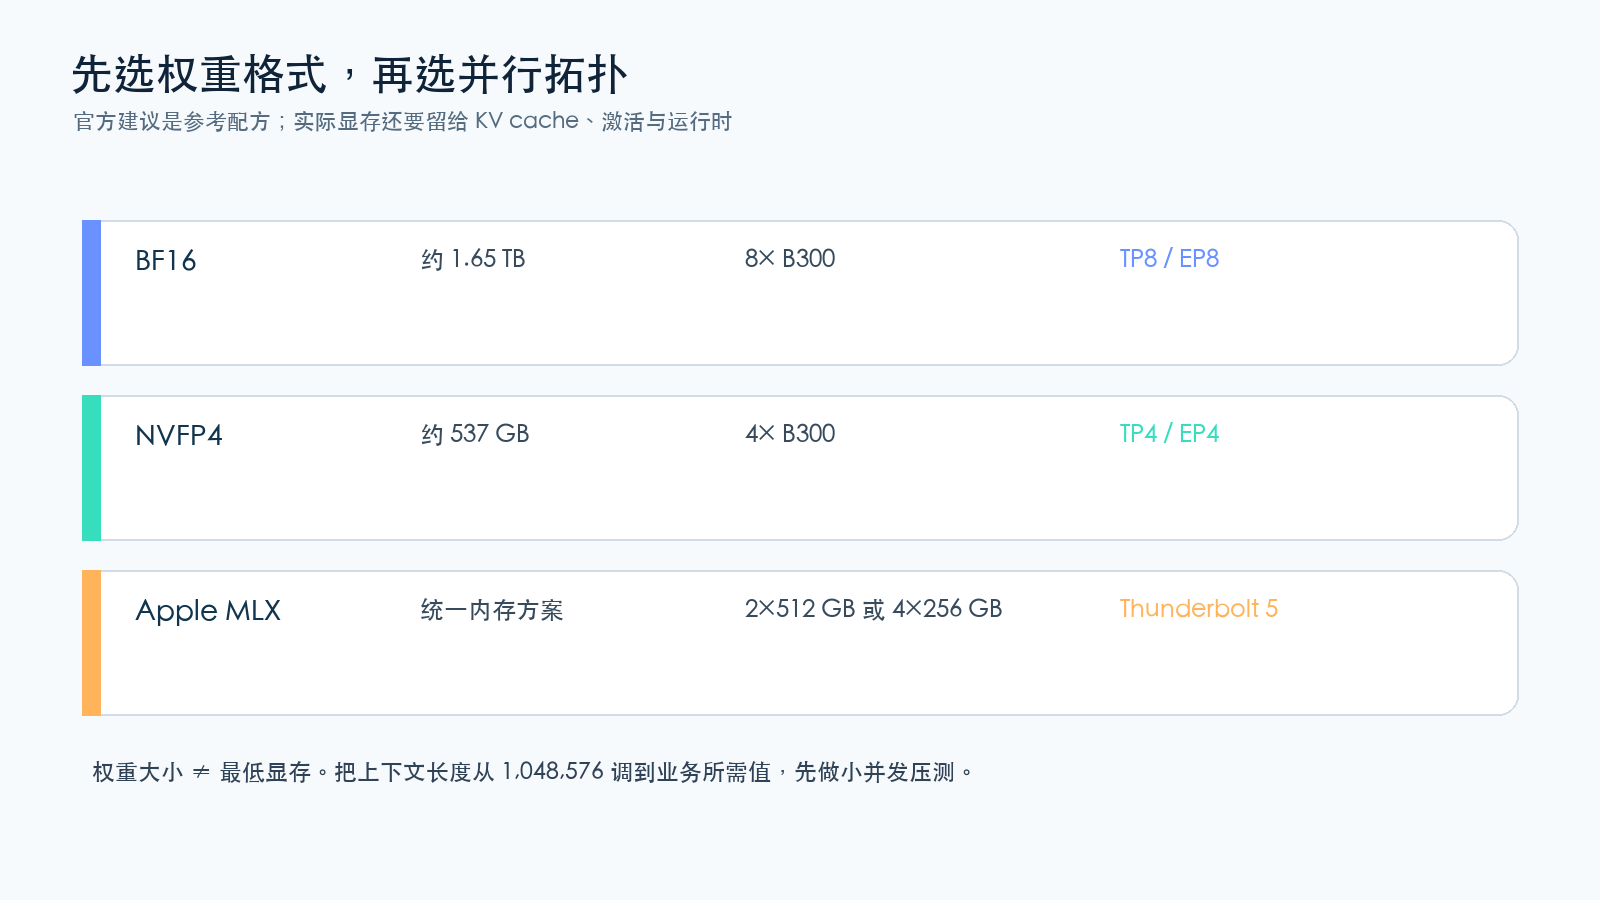
官方 OSS Cookbook 给出的权重 footprint 是:BF16 约 1.65TB,NVFP4 约 537GB。它们只是权重本身的体积,还要为 KV cache、激活、通信缓冲区和运行时预留空间。
1M token 是模型上限,不是每个服务都应该直接打开的值。官方设置文档说明,62 层中有 46 层使用最近 2,048 token 的滑动窗口,另外 16 层使用 full attention;full attention 层的 KV cache 会随上下文增长。第一次上线可以把 SGLang 的 --context-length 或 vLLM 的 --max-model-len 设成业务需要的值,例如 32K 或 64K,再用真实任务逐步放大。
第一步:申请 Hugging Face gated 模型访问
模型仓库是手动门控(gated)。在 Hugging Face 模型页提交访问申请并同意 Muse Model License,审核通过后再在部署机登录:
python3 -m pip install -U "huggingface_hub>=0.30"
hf auth login
hf whoami
申请表会要求提供身份、国家和机构/职位等信息。文章不复述个人信息字段,实际填写以 Hugging Face 页面和 Meta 隐私政策为准。不要把访问令牌写进脚本、镜像或公开日志;建议使用部署账号的凭证存储。
第二步:下载 BF16 或 NVFP4 权重
官方部署索引提供两个仓库。磁盘至少要覆盖权重、临时分片、校验文件和运行时缓存,生产环境还要给日志与回滚版本留空间。
# BF16,约 1.65TB
hf download meta-models/Muse-Spark-Open-816B-A42B \
  --local-dir ./muse-spark-open

# NVFP4,约 537GB
hf download meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
  --local-dir ./muse-spark-open-nvfp4
下载完成后先检查 config.json、generation_config.json、tokenizer、processor 配置和许可证文件是否齐全。多分片 safetensors 的分片数量可能随仓库 revision 变化,容量判断以官方 footprint 为准,不要用匿名文件列表自行推导“最低显存”。
第三步:用 SGLang 启动 NVFP4 服务
下面是官方 NVFP4 参考路径的精简启动命令,目标是 4 张 B300,TP4/EP4,监听本机 30000 端口:
sglang serve \
  --model-path meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
  --tp-size 4 \
  --ep-size 4 \
  --quantization modelopt_fp4 \
  --moe-runner-backend flashinfer_trtllm \
  --mem-fraction-static 0.8 \
  --host 0.0.0.0 \
  --port 30000 \
  --reasoning-parser muse \
  --tool-call-parser muse
如果使用本地目录,把 --model-path 换成 ./muse-spark-open-nvfp4。官方文档还给出了 TensorRT-LLM attention、DFlash 推测解码和 HiCache 的变体;先让基础服务稳定,再逐项加入优化参数。SGLang、FlashInfer、TensorRT-LLM 和 GPU 驱动版本必须按当前官方兼容矩阵锁定,不能只复制命令而忽略环境。
BF16 参考命令的核心变化是模型目录、--dtype bfloat16、--tp-size 8 和 --ep-size 8,对应 8 张 B300。不要把 NVFP4 权重目录与 BF16 参数混用。
第四步:用 vLLM 作为备选服务
官方 vLLM 示例使用 NVFP4、4 路 tensor parallel 和 expert parallel:
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
  --tensor-parallel-size 4 \
  --enable-expert-parallel \
  --max-model-len 1048576 \
  --reasoning-parser muse \
  --tool-call-parser muse \
  --enable-auto-tool-choice
如果业务只需要 32K 上下文,把 --max-model-len 1048576 改成 32768,并重新观察显存、首 token 延迟和并发。官方示例还展示了 DSpark speculative decoding;它依赖额外 draft model 和运行时版本,第一次部署建议先去掉 --speculative-config,确认基础路径可用后再单独压测。
第五步:用 OpenAI 兼容接口做 smoke test
SGLang 示例监听 30000 端口时,可以先发一个短文本请求。把 stream 打开便于观察长推理是否持续返回:
curl 127.0.0.1:30000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
    "messages": [
      {"role": "user", "content": "用一句话解释稀疏 MoE。"}
    ],
    "reasoning_effort": "low",
    "stream": true
  }'
返回内容中,使用 muse reasoning parser 的运行时会把推理内容放到 reasoning_content,最终回答仍在标准消息字段中。开启工具调用时,需要同时使用 muse tool-call parser 和自动工具选择;工具的 JSON schema、执行超时、网络权限和回传内容要在应用侧做白名单控制。
推理参数和停止标记
Muse Spark Open 的 reasoning_effort 接受四个级别:
默认值是 xhigh。高推理强度通常会产生更多推理 token,建议使用流式响应并在服务端设置请求超时、最大输出 token 和并发上限。官方没有列出 none 或 max,客户端不要自行发送这两个值。
如果必须显式设置 stop,只使用 <|eot|> 或 EOS。不要把 <|eom|> 当作停止标记,否则可能在工具调用或最终答案完成前截断输出。实际 token 字符串以当前 tokenizer 和运行时模板为准。
多模态请求怎么接
模型原生接收文本、图片、音频和视频输入,但多模态的内容块格式由运行时的 processor 和 OpenAI 兼容层决定。建议按下面顺序验收:
先用纯文本完成启动、鉴权、流式响应和错误码检查。
再用一张小图片验证 processor、图片尺寸限制和显存峰值。
最后加入音频或视频,并单独记录预处理耗时、上下文占用和请求体大小。
需要工具调用时,把多模态输入和 tools 放在同一个最小任务里,确认
tool_calls没有被 stop 参数截断。
本文没有声称在本机完成这些推理测试;上面的请求是按官方接口形态整理的 smoke test 模板。
部署后的工程化检查
权重分发、GPU 推理和 API 网关应分别验收。权重文件、tokenizer、量化包和校验清单可以放进七牛云 Kodo 私有空间,部署节点用短期下载凭证拉取到本地云盘;Kodo 的官方文档定义的是对象上传、下载和权限控制,不等于把权重直接挂成 GPU 显存。QVM 文档提供云主机、云硬盘、专有网络和安全组能力,可以承载下载器、网关、预处理/后处理和监控服务,但公开规格页没有给出 Muse Spark Open 的兼容性证明,正式推理仍要先核对 GPU、显存、互联和多机网络。
如果部署节点与对象存储处于官方实践覆盖的同一区域,可按 QVM 与 Kodo 的内网互通文档核对加速域名、带宽与地域限制;跨地域不能直接套用同一结论。七牛云 AI 推理控制台还支持为其自身 API Key 设置消费限额、模型范围、IP 白名单并查询用量和请求日志,这些治理项只作用于七牛云 AI 推理接口,不能自动替代自建 Muse 服务的鉴权、限流和审计。
上线前至少记录:
权重 revision、运行时版本、驱动和 CUDA/ROCm 版本;
目标上下文、并发、首 token 延迟、生成速度和 OOM 次数;
reasoning_effort、是否流式、是否启用工具调用;工具调用失败率、超时、重试和敏感数据脱敏日志;
模型许可证、使用政策和产品界面的署名位置。
许可证和 Model-as-a-Service 条款
Hugging Face 元数据把许可证标为 muse-model-license,仓库同时提供 LICENSE.md 和 USE_POLICY.md。分发模型或衍生模型时,要保留版权、许可证和使用政策;使用模型的产品、服务界面、文档、网站或设置中,需要显著展示“Built with Muse Spark Open”。
许可证还规定了 Model as a Service 条款:如果开发者或关联方通过 API 或类似接口向第三方提供模型输出,且连续 12 个月合并总营收超过 2,000 万美元,在把该软件或衍生模型纳入这类服务前,需要通知 Meta 并签署书面协议。该段是许可证条件的摘要,具体上线应以仓库最新 LICENSE.md、USE_POLICY.md 和法律意见为准。Meta 不主张模型输出的所有权,但软件、输出和结果按“AS IS”提供。
到这里,完整路径可以拆成四个可复核节点:HF gated 访问成功、权重目录完整、SGLang/vLLM 进程健康、OpenAI 兼容 smoke test 返回内容。任何一个节点没有通过,都不要直接进入长上下文和高并发压测。
参考资料
Meta Muse Spark Open 模型页:https://dev.meta.ai/models/muse-spark-open/
Meta 获取模型文档:https://dev.meta.ai/docs/muse-spark-open/get-the-model
七牛云 AI 大模型企业订阅:https://www.qiniu.com/ai/plan