10 月大模型怎么选:Opus 5.5、GPT-6 Astra、Gemini 4 Argon 实测对比
发布日期:2026-10-21 | 数据截至 2026-10-20
2026 年 10 月的前沿大模型三强,分别是 Anthropic 于 9 月 22 日发布的 Claude Opus 5.5、OpenAI 于 9 月 3 日发布的 GPT-6 Astra,以及 Google 于 10 月 13 日全面开放的 Gemini 4 Argon。三家都号称"最强",但 10 月 15 日更新的 SlopCodeBench 给出了一个更冷静的结论:在 36 道多阶段编程题上,所有前沿模型的严格通过率都挤在 12.2% 到 16.3% 之间,差距只有几个检查点,成本却能相差 8 倍以上;更反直觉的是,把推理强度从 Medium 拉到 XHigh,Opus 5.5 的成本涨了 4.22 倍,严格通过数反而从 28 降到 25。本文按"发布节点、核心能力、实测对比、怎么选"的顺序梳理三款模型,并给出一套按单次成功成本选模型的实操方法。
三款模型分别是什么时候来的
2026 年 9 月到 10 月,三家头部厂商在六周内先后交出了新一代旗舰:
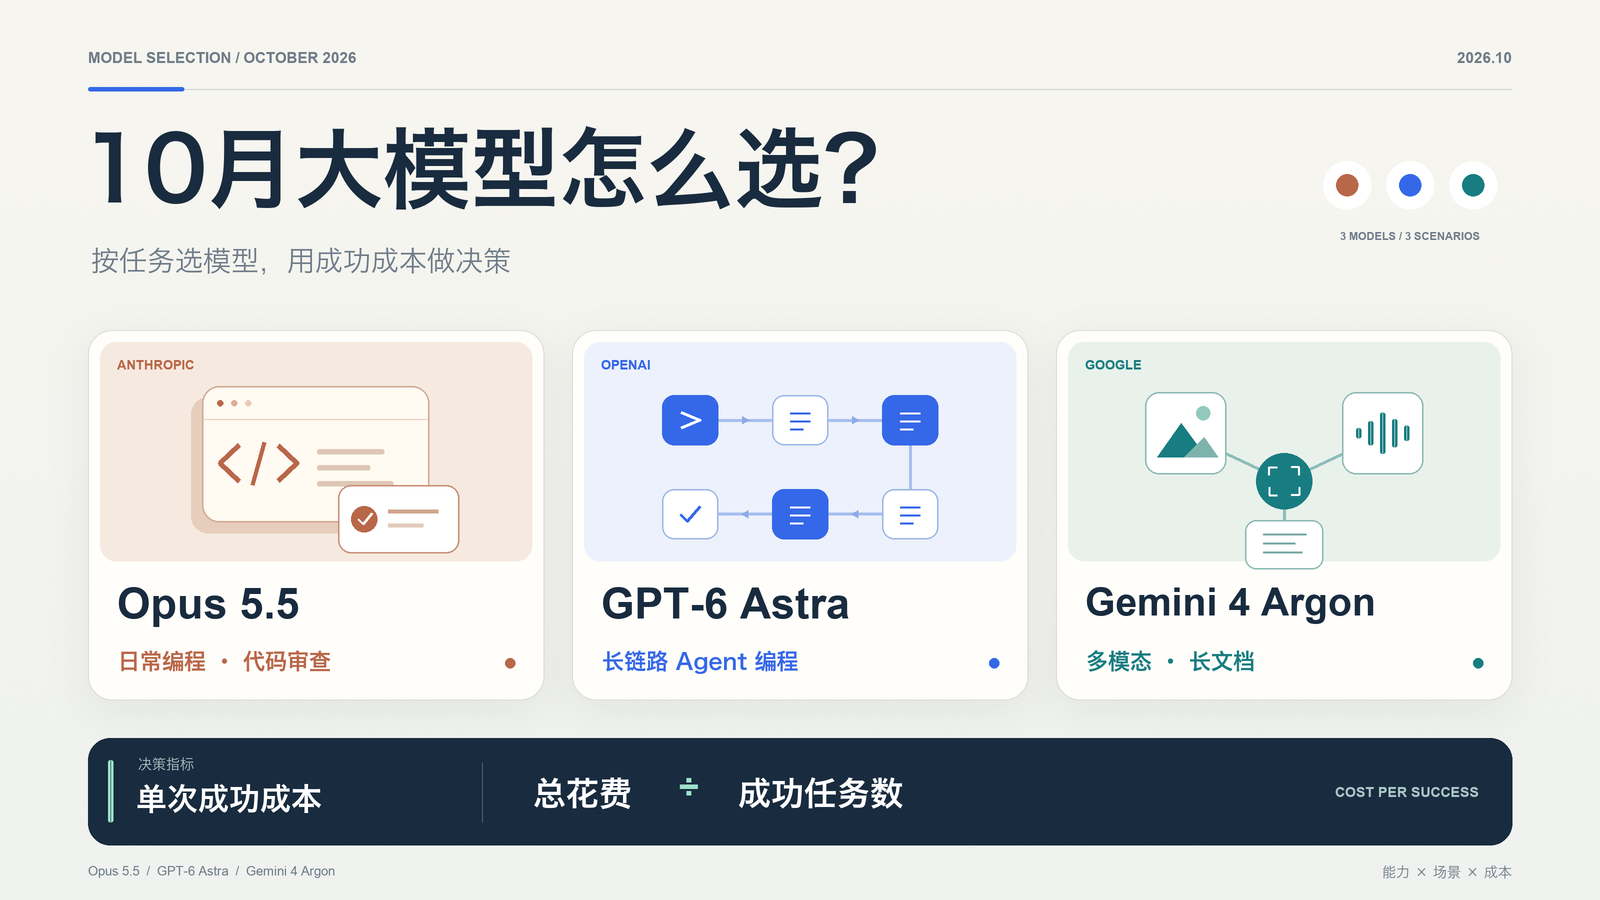
GPT-6 Astra(9 月 3 日):OpenAI 称其为"迄今最强"的模型,支持文本和图像输入,上下文窗口 100 万 Token。发布时先向少量机构开放,随后陆续开放给付费版 ChatGPT 和 API,同时上架 AWS Bedrock 与 Microsoft Azure。
Claude Opus 5.5(9 月 22 日):Anthropic 官方定位是"在 Agent 编程和知识工作上领先",并称在典型工作负载下运行成本比 Opus 5 低 40%。
Gemini 4 Argon(10 月 13 日全面开放):Google 新一代前沿模型,上下文窗口 1,048,576 Token,可输入文本、图像、视频、音频和 PDF,输出为文本。
时间线意味着一件事:如果你的团队还在用 9 月之前的默认配置,现在是重新评估模型路由的窗口期。
价格:同样是旗舰,账单形状完全不同
三款模型的标价差异,比能力差异更值得先看:
数据来源:OpenAI 发布公告与 dev.to 作者 Gabriel Anhaia 的整理(2026-09);Gemini 4 Argon 价格来自开发者 Kartit 的实测文章(2026-10-14)。
独立评测机构 Artificial Analysis 的判断很直白:GPT-6 Astra 在智能指数上得分 60,在其追踪的 202 个模型中排第 14,分数与 GPT-5.6 Sol 接近,单价却约为后者的 2.5 倍;但在 Coding Agent 指数上,Astra 与 Claude Fable 5 持平且更便宜。换句话说,Astra 做通用任务不划算,做长链路 Agent 编程却可能是笔好买卖。
编程实测:差距比宣传小得多
SlopCodeBench 是一个模拟"需求不断变化"的编程基准:模型先写程序,再接收新需求修改旧代码,后续检查点同时测试新功能和旧功能是否还正常。HumanLayer 的 Dex Horthy 在 2026 年 10 月 15 日发布了完整跑分(36 道题、196 个检查点):
这张表里有三个值得记住的结论:
头名优势很薄:Astra XHigh 拿下最高严格通过率,但只比成本不到四分之一的 GPT-6.1 Sol Medium 多两个检查点。
Opus 5.5 Medium 最"稳":核心通过率 73.98% 全场最高,也就是主功能做对的比例最高,但改需求时保住旧功能的能力并不突出。
XHigh 不是万能加速器:三组同模型对比中,XHigh 成本是 Medium 的 2.11 到 4.22 倍,只有 Astra 的严格通过数上升了。作者也提醒,每个设置只跑了一次,不能断言"推理越多越差",只能说"加推理强度不是买分数的可靠方式"。
Gemini 4 Argon 发布较晚,没有进入这轮 SlopCodeBench。开发者 Kartit 在 10 月 14 日做了一组同提示词对比:一次性生成 3D 卡丁车游戏,Argon 用时 220.6 秒、花费 0.306 美元且能运行;Astra 用时 323.4 秒、花费 0.704 美元,作者评分 10/10;Opus 5.5 在 32,000 Token 输出上限处被截断。在 82 道带标注的短问答上,Argon 与 Astra 均为 82/82,Opus 5.5 为 81/82(一道格式错误)。
一句话选型建议
把上面的数据压缩成决策:
长链路 Agent 编程、需要最高成功率:GPT-6 Astra,可以开 XHigh,但只给真正困难的任务开。
日常编程、代码审查、重构:Claude Opus 5.5 用 Medium 即可,核心功能正确率最高,不必为 XHigh 多付 4 倍。
多模态输入、长文档、视觉设计类前端:Gemini 4 Argon,百万级上下文、价格最低,11 月 30 日前还有首发价。
预算敏感的批量任务:GPT-6.1 Sol Medium 在 SlopCodeBench 上以 178.51 美元拿到与 Astra Medium 相同的严格通过数,是本轮性价比最高的组合。
实操:别看单价,算"单次成功成本"
模型标价只是起点。同样标价的两个模型,一个话多一个话少,实际账单能差 3 倍;便宜模型失败重试两次再升级,成本反而更高。真正该比的是每次成功任务花了多少钱。
第一步:给每次调用记录花费和是否成功。 "成功"按业务定义,例如 JSON 通过校验、补丁能编译、客服回复无需人工修改。
def cost_per_success(rows):
    """rows: [{"usd": 0.12, "accepted": True}, ...]"""
    spend = sum(r["usd"] for r in rows)
    wins = sum(1 for r in rows if r["accepted"])
    return float("inf") if wins == 0 else spend / wins
第二步:小流量对照。 让新模型承接 10% 流量跑一周,按模型分别计算 cost_per_success,再决定默认路由。
第三步:先便宜、后升级。 默认调用低价模型,校验失败时才升级到旗舰模型,并预设单请求成本上限,超限直接拒绝。
第四步:推理强度默认 Medium。 SlopCodeBench 的数据说明,XHigh 应作为"失败后升级"的选项,而不是全局默认。
第五步(Gemini 4 Argon 用户):调大两个超时参数。 Argon 首个 Token 前可能思考超过 5 分钟,opencode 默认会报 ProviderHeaderTimeoutError。在 ~/.config/opencode/opencode.json 中加入:
{
  "provider": {
    "google": {
      "options": {
        "headerTimeout": 1800000,
        "chunkTimeout": 1800000
      }
    }
  }
}
同时设置环境变量 OPENCODE_EXPERIMENTAL_OUTPUT_TOKEN_MAX=65536,解除 opencode 默认 32,000 Token 的输出上限。另外,Argon 的一次 Blender 建模会话消耗了 1020 万输入 Token,缓存命中仅约 4%,花费 22.13 美元。保持提示词开头固定(Google 对 6,144 Token 以上的共享前缀自动缓存)、缩短单次会话,是控制 Agent 成本最直接的办法。
国内团队的另一条路径:给 Token 预算设上限
对国内开发团队来说,海外旗舰模型适合用来攻坚,而日常批量任务往往交给国产模型。这时预算可控和单价一样重要。以七牛云 Token Plan 企业套餐为例,页面公开的计费规则有几条可以直接拿来做预算:
月费即封顶:订阅不支持后付费,超出额度的请求会被拒绝,不会产生意外超支;额度按周刷新,未用完不结转。
闲时倍率:每日 18:00 到次日 08:00(北京时间)为闲时,部分模型按 ×0.3 倍率计费,叠加包年 4 折,最低约合刊例价 1.2 折,适合把批处理、离线评测安排在夜间。
一个 Key 覆盖多模型:统一 API Key 接入 4 家国产模型厂商的 17 个模型,兼容 Completions、Responses、Messages 三种接口,上文的"先便宜后升级"路由可以在同一套接口内完成对照测试。
档位:Enterprise S / M / B 三档,月付分别为 2,999 元、4,999 元、9,999 元。
上面的 cost_per_success 指标同样适用:把夜间闲时跑出的成功率和花费记下来,再决定哪些任务留给海外旗舰模型。
争议与提醒
这轮对比也有局限。SlopCodeBench 每个设置只跑一次,无法排除随机波动;代码质量指标显示 Opus 5.5 XHigh 写出的代码"冗余代码覆盖率"最低(77.75%,Medium 为 94.25%),说明 XHigh 换来的可能是更干净的代码而非更多通过数,具体取决于你更看重哪一项。此外,Astra 的 DeepSWE v1.1 成绩(74.1%)是 OpenAI 自报数据,Argon 的对比来自单个开发者的实测,都应当作参考而非定论。
总结
2026 年 10 月的三款前沿模型在编程能力上已经非常接近:SlopCodeBench 上从 5 月 GPT-5.5 的 14.8% 到 10 月 Astra 的 16.3%,半年只涨了 1.5 个百分点。选型时与其追逐榜首,不如按任务类型分配模型、默认使用 Medium 推理强度,并用"单次成功成本"而非单价做决策。本文数据来自 SlopCodeBench(HumanLayer,2026-10-15)、Artificial Analysis 与各厂商官方公告,模型价格变化频繁,正式预算前请以官方定价页为准。
延伸阅读
SlopCodeBench 10 月测评:github.com/humanlayer/advanced-context-engineering-for-coding-agents
SlopCodeBench 论文:arxiv.org/abs/2603.24755
Artificial Analysis 模型评测:artificialanalysis.ai
Anthropic 新闻页:anthropic.com/news
七牛云 Token Plan:https://www.qiniu.com/ai/plan