GPT-6、Grok 4.7、Fable 5.1、Opus 5.5 横评:性能、价格与选型(2026)
发布日期:2026-09-24
截至 2026 年 9 月,GPT-6 Astra、Grok 4.7、Claude Fable 5.1 与 Claude Opus 5.5 分别是 OpenAI、xAI 和 Anthropic 提供官方 API 的前沿模型;本文中的 GPT-6 特指旗舰型号 GPT-6 Astra。四者都面向复杂推理、编程或知识工作,但价格、上下文、推理方式和优势任务差异很大,选型应同时比较任务成功率、延迟和每个成功任务的成本。
四款模型的定位并不相同
GPT-6 Astra 是 OpenAI 面向最难端到端工作的旗舰模型,官方模型页把复杂推理、编程、计算机操作、研究和文档创作列为主要任务。
截至 2026 年 9 月 24 日,它支持 105 万 Token 上下文、12.8 万 Token 最大输出,以及 Web Search、File Search、代码执行、Computer Use 和 MCP 等 Responses API 工具。
Grok 4.7 是 xAI 于 2026 年 9 月 21 日发布的编程与知识工作模型。
xAI 称它使用了更大的基础模型和更长的强化学习训练,训练任务更偏向需要数小时完成的问题,并强化了自我验证和长上下文管理。
Claude Fable 5.1 于 2026 年 9 月 1 日发布,Anthropic 将它定位为高难度推理和长周期 Agent 工作模型。
Claude Opus 5.5 于 2026 年 9 月 22 日发布,官方称它在多数任务上达到 Fable 5.1 的水平,同时把标准价格降到每百万输入/输出 Token 4/20 美元。
规格与价格对比(截至 2026 年 9 月 24 日)
价格不能只看输入单价。假设一次任务累计使用 100 万输入 Token 和 20 万输出 Token,不计缓存、工具费和长上下文加价,按 2026 年 9 月 24 日官方标准价格估算:GPT-6 Astra 与 Fable 5.1 各约 20 美元,Opus 5.5 约 8 美元,Grok 4.7 约 3.2 美元起。
实际账单还会受推理强度、重试次数和输出长度影响。GPT-6 Astra 的官方页面明确说明,当输入超过 27.2 万 Token 时,整次请求按两倍输入与缓存价格、1.5 倍输出价格计费。
截至 2026 年 9 月 24 日,Fable 5.1 与 Opus 5.5 的缓存读取价格分别为每百万 Token 0.25 美元和 0.20 美元。长会话与代码 Agent 应把缓存命中率纳入测试。
同一指标下,谁的表现更强
四款模型没有一张完全统一、由独立机构同批运行的公开总榜。
截至 2026 年 9 月 24 日,能够交叉核对的一项是 GDPval-AA v2.1:Anthropic 的 Opus 5.5 发布页给出 Opus、Fable 和 Astra 数据,xAI 的 Grok 4.7 发布页给出 Grok、Fable 和 Astra 数据,两边重合的 Fable 与 Astra 数值一致。
这项结果说明 Opus 5.5 在该知识工作评测中领先,但不能推导出它在所有任务上领先。
Anthropic 2026 年 9 月发布页的同表数据显示,Terminal-Bench 4.0 中 Opus 5.5 为 66.4%、GPT-6 Astra 为 57.9%、Fable 5.1 为 55.8%。在面向科学研究的 Terminal-Bench-Science 0.1 中,Astra 以 64.6% 高于 Opus 5.5 的 58.7%;AutomationBench 上 Astra 为 41.4%,也略高于 Opus 5.5 的 40.0%。
xAI 2026 年 9 月官方发布页对 Terminal-Bench 4.0 的测试给出 Grok 4.7 为 37.6%、Fable 5.1 为 57.9%。
Fable 在 Anthropic 与 xAI 两个页面中的数字相差 2.1 个百分点,说明 harness、effort 和运行批次会改变结果,因此不能把不同厂商页面上的所有分数直接拼成精确排名。
四类任务怎么选
复杂端到端工作:先测 GPT-6 Astra
当任务同时需要推理、代码执行、联网检索、文件处理、计算机操作和 MCP 工具时,GPT-6 Astra 的官方工具覆盖最完整。它适合复杂研究、跨工具工作流和对失败恢复要求高的 Agent,但标准单价较高,超长输入还有阶梯加价。
成本敏感的编程任务:先测 Grok 4.7
Grok 4.7 的标准输入/输出价格最低,适合代码修改、终端任务和需要大量重复运行的工作流。它在 xAI 官方 EEBench 中得到 64.0%,高于同页 Fable 5.1 的 56.4%;但在同页 Terminal-Bench 4.0 与多小时办公任务中落后于 Fable,因此不能仅凭低单价替代任务验证。
极难的长周期 Agent:把 Fable 5.1 放入上限测试
Fable 5.1 的默认推理强度为 high,思考模式始终开启,官方延迟标注为 slower。它的 100 万 Token 上下文和长周期 Agent 定位适合代码库级迁移、多步研究和复杂文档任务,但输入/输出单价与 GPT-6 Astra 相同。更合理的用法是处理其他模型没有通过的高难样本,而不是承接全部流量。
质量与成本平衡:重点测试 Opus 5.5
Opus 5.5 的标准价格是 Fable 5.1 的 40%,上下文和最大输出保持一致。Anthropic 官方表示,它在典型工作负载上的运行成本比 Opus 5 低 40%,输出速度快 30% 以上;在发布页列出的知识工作和多项 Agent 编程基准中,它也达到或超过 Fable 5.1。对于代码 Agent、研究和企业知识工作,它是四款模型中需要优先做成本收益测试的一档。
用自己的任务做一次可复现横评
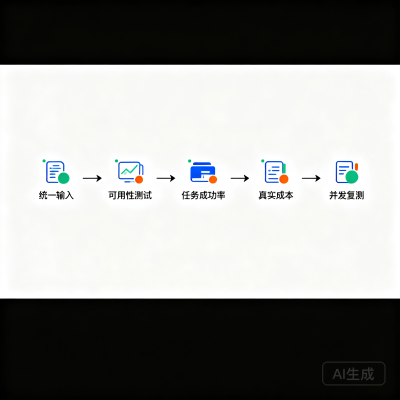
厂商榜单适合缩小候选范围,生产决策仍应使用同一批任务、同一套工具和同一验收条件。一个可在一天内完成的流程是:
准备 30 条脱敏样本,分别覆盖代码修复、终端操作、资料研究、表格处理、长文档理解和多模态输入。
固定 system prompt、工具 schema、最大输出、超时和重试次数;推理强度选择各模型的生产候选档位,并单独记录。
用自动规则判断是否成功,例如测试是否通过、引用是否可追溯、表格公式是否正确、JSON 是否可解析。
记录首 Token 延迟、总耗时、输入/输出 Token、缓存命中、工具调用次数和失败重试。
计算“成功任务成本”,再分别以质量、速度和成本设权重,避免只看单价或单项榜单。
如果团队还要比较多款国产模型,七牛云 Token Plan 官方页面截至 2026 年 9 月 24 日显示,一个订阅 API Key 可统一访问套餐内多款主流模型,兼容 Completions、Responses 和 Messages 接口,额度按周刷新并按模型积分消耗。它可以作为另一组多模型测试入口,但可用模型与积分倍率应以订阅页当天信息为准。
选型结论
GPT-6 Astra 的长处是端到端能力与工具生态,Grok 4.7 的优势是标准 Token 单价,Fable 5.1 用于探索高难长周期任务的能力上限,Opus 5.5 则在当前官方价格与多个 Agent/知识工作指标之间形成较强平衡。
据 OpenAI 官方模型页,Astra 的工具覆盖与 105 万 Token 上下文适合复杂工作流;据 Anthropic 与 xAI 的官方发布页,同一模型在不同评测环境中仍会出现分数差异。最终采购或路由策略应以内部样本的成功任务成本为依据。
本文数据截至 2026 年 9 月 24 日,模型价格、可用区域、限流、Beta 工具和榜单成绩可能继续更新,接入前应再次核对文末官方资料。
参考资料
OpenAI:GPT-6 Astra 模型文档:developers.openai.com/api/docs/models/gpt-6-astra
xAI:Introducing Grok 4.7:x.ai/news/grok-4-7
xAI:Grok Models & Pricing:docs.x.ai/developers/models
Anthropic:Claude Fable 5.1 模型文档:platform.claude.com/docs/en/models/fable-5-1/overview
Anthropic:Introducing Claude Fable 5.1 and Claude Mythos 5.1:anthropic.com/claude-fable-and-mythos-5-1
Anthropic:Introducing Claude Opus 5.5:anthropic.com/claude-opus-5-5
Anthropic:Claude Opus 5.5 模型文档:platform.claude.com/docs/en/models/opus-5-5/overview