vLLM vs SGLang vs DeepInfer:2026 年部署 DeepSeek 推理框架怎么选
发布日期:2026-10-21 | 话题:vLLM SGLang DeepInfer 对比 / DeepSeek 推理部署 / LLM 推理框架选型
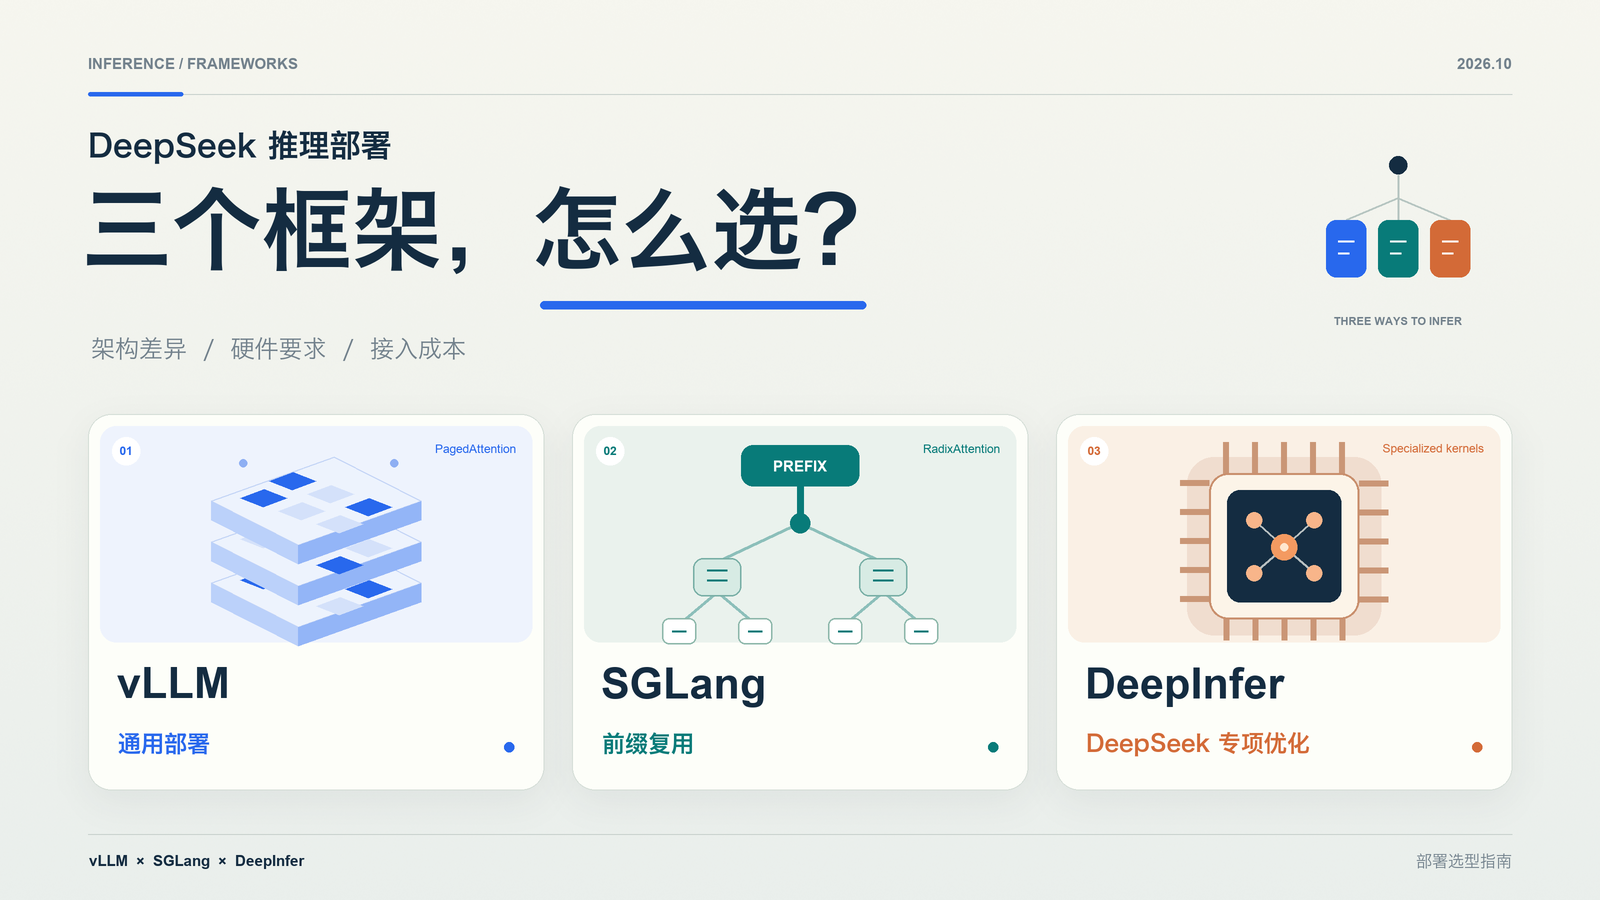
2026 年 10 月,DeepSeek 开源了内部推理框架 DeepInfer,与此同时 vLLM 发布 v0.32.0(2026-10-18,94,449 Stars),SGLang 发布 v0.5.22(2026-10-19,37,518 Stars)。三个框架同台竞技,DeepInfer 是 DeepSeek 线上生产服务实际跑的方案,vLLM 是社区覆盖最广的通用选择,SGLang 在多轮对话和长前缀复用场景有结构性优势。三者关系并非你死我活:DeepInfer README 明确写明"最初主要基于 vLLM 构建,同时借鉴了 SGLang 和 TensorRT-LLM"。本文从架构核心差异、DeepSeek 模型适配、硬件要求、接入成本四个维度横向对比,给出不同场景的选型结论:硬件受限选 vLLM,多轮对话/RAG 高吞吐选 SGLang,追求官方调优基准或需要昇腾支持选 DeepInfer,不想自建推理栈则直接走兼容 OpenAI 格式的推理 API。
三框架定位一句话总结
来源:各框架 GitHub 仓库,2026 年 10 月 21 日。
核心架构差异
vLLM:PagedAttention + 最广覆盖
vLLM 的核心创新是 PagedAttention——受操作系统虚拟内存设计启发,将 KV Cache 映射到非连续物理块,按需分配,消除了传统方案预留连续显存导致的碎片问题,支撑更高并发序列数。
v0.32.0 的主要更新:
Model Runner V2 默认启用,支持 GPU n-gram 投机解码和弹性专家并行(Elastic EP)
低精度 KV Cache 全覆盖:NVFP4 KV Cache 扩展到 SM8x/SM90/SM12x,FP8 KV Cache 在 GLM-5.x 上节省 50% KV 显存
vllm download-kernels预装 FlashInfer 编译内核,vllm preload保持 autotune 表热缓存,减少冷启动时间OpenAI 兼容接口(Chat Completions + Responses),直接替换
base_url即可接入
适合场景:快速适配新模型、多模型统一服务、需要广泛硬件支持(Ampere/Ada/Hopper/Blackwell,AMD ROCm)。
SGLang:RadixAttention + 多轮对话结构性优势
SGLang 的核心是 RadixAttention——用**基数树(Radix Tree)**统一管理所有请求的 KV Cache,当多个请求共享相同前缀(同一 system prompt、RAG 文档块、Agent 工具定义)时,直接复用已缓存的 KV,跳过重复 prefill 计算。
v0.5.22 默认启用 Rust 前缀缓存核心,同时支持:
PD 分离(Prefill-Decode Disaggregation):Prefill(计算密集)和 Decode(访存密集)独立部署、独立扩缩
HiCache:分层 KV Cache,热数据留 GPU,冷数据卸到 CPU/NVMe
xAI、NVIDIA、AMD、Cursor 等生产用户,每天全球生产环境生成万亿级 token
适合场景:多轮对话、RAG 问答(固定文档块大量复用)、Agent 工具链(相同工具定义前缀)、需要 PD 分离部署的高并发服务。
DeepInfer:DeepSeek 架构专项优化
DeepInfer 在 vLLM 基础上针对 DeepSeek 特有架构进行深度定制:
FlashMLA:Multi-head Latent Attention 专项内核,DeepSeek V3/V4 系列的标志性注意力机制
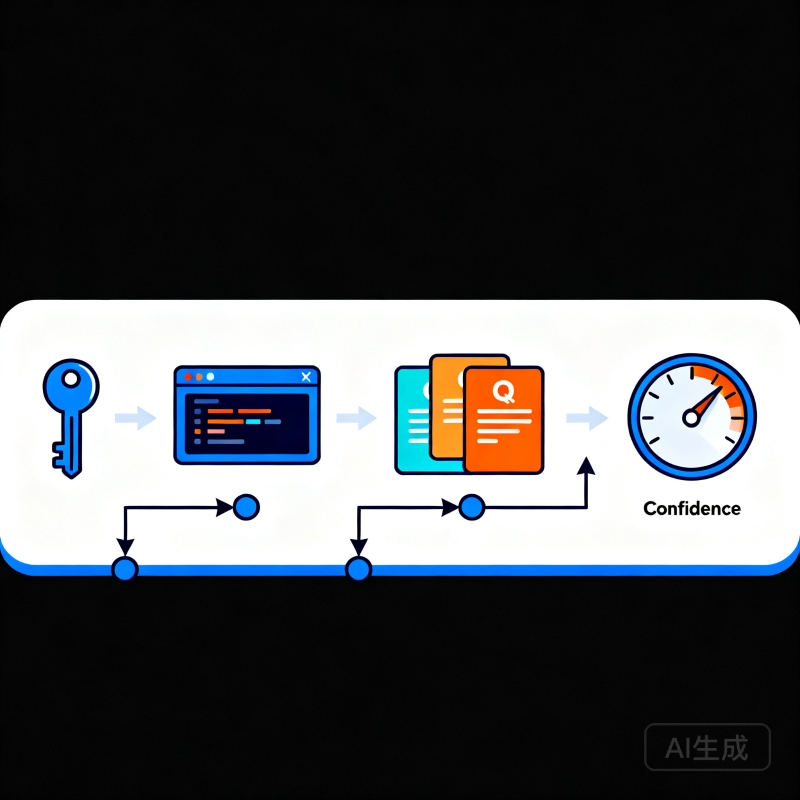
DSpark + 置信度调度验证:投机解码配合动态置信度,控制验证时机而非固定窗口
SWA Bounded Replay:只重放有界后缀,减少 Decode 阶段的 Prefill 计算量
MoE EP + EPLB:专家并行加专家负载均衡,缓解 MoE 热点专家瓶颈
昇腾 950 NPU 原生支持:英伟达之外,原生适配华为昇腾平台
当前版本为离线推理版本,在线服务所需的 KV 缓存系统和 Prefill/Decode 分离部署尚未包含在开源版中。
硬件要求对比
来源:各框架官方文档,2026 年 10 月。
关键结论:DeepInfer 目前只支持最新一代英伟达 Blackwell(SM100)和华为昇腾 950,消费级显卡(RTX 4090 及以下)无法运行。RTX 系列用户的唯一选项是 vLLM 或 SGLang。
DeepSeek 模型支持现状
DeepInfer 当前仅官方支持 DeepSeek-V4.1-Flash,其他模型的推理代码将在官方仓库持续更新。
快速上手对比
vLLM 启动 DeepSeek
pip install vllm
vllm serve deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --tensor-parallel-size 2 \
  --max-model-len 32768 \
  --port 8000
SGLang 启动 DeepSeek
pip install sglang[all]
python -m sglang.launch_server \
  --model-path deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --tp 2 \
  --port 30000
DeepInfer 启动(需 SM100 GPU)
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
# 默认使用 DeepSeek-V4.1-Flash-1017,首次自动下载
python examples/offline_inference.py
三个框架均提供兼容 OpenAI Chat Completions 格式的 HTTP 接口,接入已有应用只需替换 base_url。
选型决策框架
常见问题
Q:DeepInfer 和 vLLM 部署同一个模型,性能差距有多大?
DeepInfer 官方只提供了自身在 SM100 GPU 上的 Prefill/Decode Pareto 曲线,没有与 vLLM/SGLang 的直接横向数字对比。DeepInfer 集成的 FlashMLA、SWA Bounded Replay、DSpark 均针对 DeepSeek 架构专项优化,理论上在相同硬件(SM100)上吞吐/延迟应优于通用框架,但具体差距需要在相同模型、硬件、并发条件下实测复现。
Q:SGLang 的 RadixAttention 对所有场景都有效吗?
不是。RadixAttention 的收益取决于请求间的前缀重复率。单次长文档问答、每次前缀完全不同的场景收益有限;多轮对话(相同 system prompt)、RAG(重复文档块)、Agent 工具链(重复工具定义)等场景收益最显著。纯 batch 单轮推理场景,vLLM 和 SGLang 差距不大。
Q:三个框架可以同时运行、按场景路由吗?
技术上可以,但运维成本较高。通常的做法是主平台选一个覆盖 80% 场景的框架,特殊场景(如昇腾部署)单独跑 DeepInfer。对于不需要极致调优的团队,通过兼容 OpenAI 格式的统一 API 平台(如七牛云 Token Plan)调用 DeepSeek,可以跳过推理框架选型和运维问题,直接按用量计费。
Q:vLLM v0.32.0 的 Elastic EP 对 DeepSeek MoE 模型有帮助吗?
有帮助。Elastic EP(弹性专家并行)允许在不同请求 batch 之间动态调整专家的 GPU 分配,减少负载不均导致的专家等待。DeepSeek V4 系列是 MoE 架构,每次只激活部分专家,Elastic EP 可以在高并发时降低热点专家的排队延迟。
Q:DeepInfer 的离线版本无法做在线服务,什么时候能用于生产?
DeepInfer 公告表明后续新模型推理代码和优化将持续更新至仓库,在线服务所需的 KV 缓存系统和 Prefill/Decode 分离部署"绝大部分引擎功能已实现",但未给出具体时间表。目前适合用于离线批量推理和性能基准测试,在线生产服务仍推荐 vLLM 或 SGLang。
结语
vLLM、SGLang、DeepInfer 三者并非替代关系,而是在不同维度各有专长的互补生态。vLLM 凭借 94k Stars 和最广的模型/硬件覆盖,仍是 2026 年底开发者上手最快的通用选择;SGLang 的 RadixAttention 在多轮对话和 Agent 场景有结构性优势,是 xAI 等大规模生产用户的选择;DeepInfer 则代表 DeepSeek 自己跑生产的方式,其 SM100 + 昇腾双平台支持和专项算子优化,是持有企业级硬件的团队值得关注的参考实现。三个框架均为 Apache 2.0,可自由选用和组合。
本文数据来源:vLLM GitHub(vllm-project/vllm v0.32.0)、SGLang GitHub(sgl-project/sglang v0.5.22)、DeepInfer GitHub(deepseek-ai/DeepInfer),均基于 2026 年 10 月 21 日数据,框架迭代快,选型前建议以官方最新 README 为准。
延伸资源
SGLang 仓库:https://github.com/sgl-project/sglang
DeepInfer 仓库:https://github.com/deepseek-ai/DeepInfer
七牛云 Token Plan(DeepSeek 多版本 API,无需自建推理栈):https://www.qiniu.com/ai/plan