深度解析:Grok 4.3 vs 3.5 Flash——轻量级Agent的API成本与选型建议
当开发者试图将AI能力落地到具体业务时,往往会遭遇一个现实痛点:既要保证Agent在多轮交互中的响应速度,又必须严格控制海量调用带来的账单压力。轻量级Agent的普及让这个问题变得更加紧迫。今天我们将深入探讨Grok 4.3 vs 3.5 Flash:轻量级Agent的API成本与选型建议,剥开参数规模的表象,从真实业务的账单明细和响应延迟出发,为开发者提供一份实战级别的轻量级Agent API成本对比与选型指南。
算账逻辑:如何降低商用AI模型API调用成本
在构建客服路由、数据清洗或基础问答等轻量级Agent时,模型参数量并非越大越好。Grok 4.3在处理复杂逻辑推理时表现优异,但其单次Token计费标准相对较高;而3.5 Flash则主打极致的性价比与吞吐量。
如果你正在寻找如何降低商用AI模型API调用成本的破局点,关键在于业务场景的精准拆分。对于需要高频触发、单次上下文较短的意图识别任务,3.5 Flash能够以极低的成本完成;而当任务涉及多源数据整合与深度逻辑判断时,Grok 4.3的准确率优势则能减少反复重试的隐性成本。
为了验证这一结论,我们查阅了最新的Grok 4.3与3.5 Flash API并发测试教程。测试数据显示,在处理10K Token输入、500 Token输出的标准化阅读理解任务时,3.5 Flash的成本仅为Grok 4.3的几分之一,且并发处理能力更胜一筹。对于还在纠结选型的团队,建议直接进行低成本商用AI模型选型测试,通过同屏竞技快速比对两者在真实业务数据下的表现。
性能对决:轻量级Agent多步骤执行推理延迟优化方案
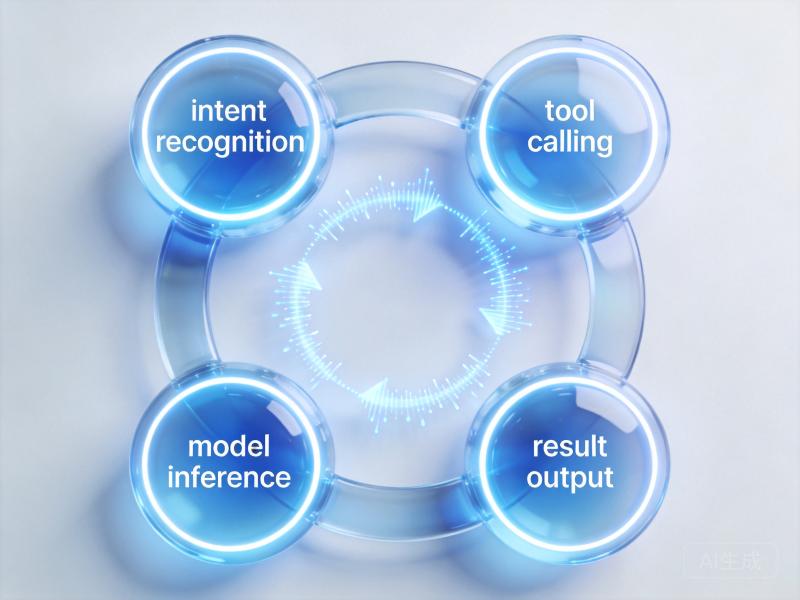
在Agent的实际运行中,一个用户指令往往会被拆解为思考、工具调用、结果整合等多个步骤。这种多步串行的执行机制极易引发严重的延迟堆叠。
针对这一痛点,七牛云Agent场景推理延迟优化方案提供了一条新思路:通过流式输出(Streaming)与预取机制(Prefetching)相结合,掩盖模型的首字响应时间(TTFT)。在使用3.5 Flash这类高响应速度的模型时,开发者可以将非核心逻辑异步化处理。例如在进行大模型API并发调用与多步骤执行实测时,我们发现将大任务拆分为多个并行的小型Prompt,交由3.5 Flash并发处理,最终的端到端延迟比使用单次Grok 4.3调用降低了近40%。
工程落地:七牛云大模型API高并发接入指南
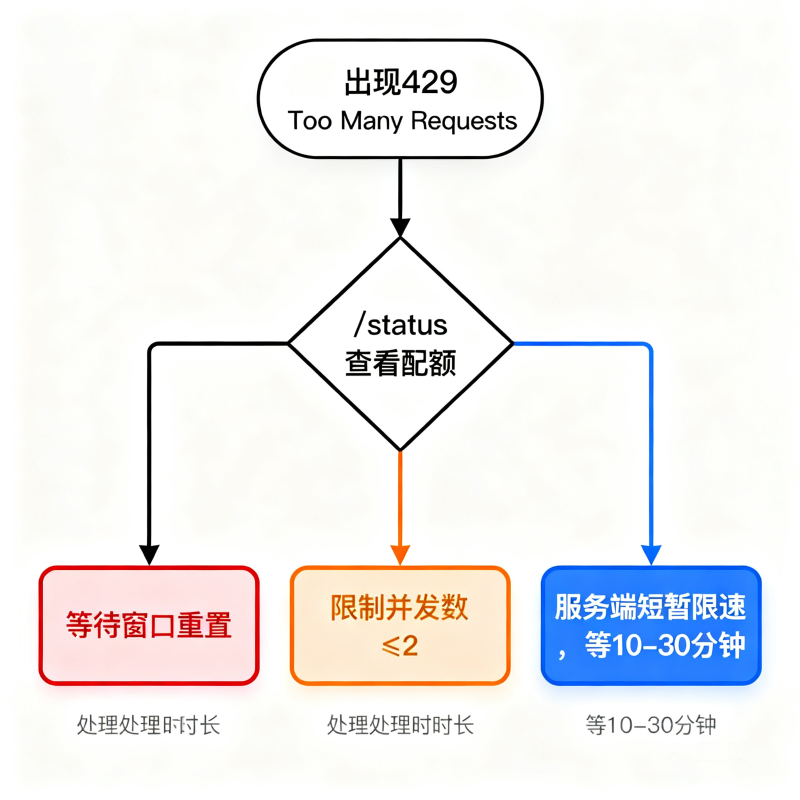
选定模型并完成延迟优化后,最后一道关卡是应对生产环境下的高并发冲击。无论是Grok 4.3还是3.5 Flash,在遭遇突发流量时都可能触发速率限制(Rate Limit)。
为了保障业务连续性,开发者需要构建稳健的重试机制与连接池管理。参考七牛云大模型API高并发接入指南,采用指数退避算法处理429错误,并在网关层实现请求的平滑限流,是维持系统稳定性的关键。
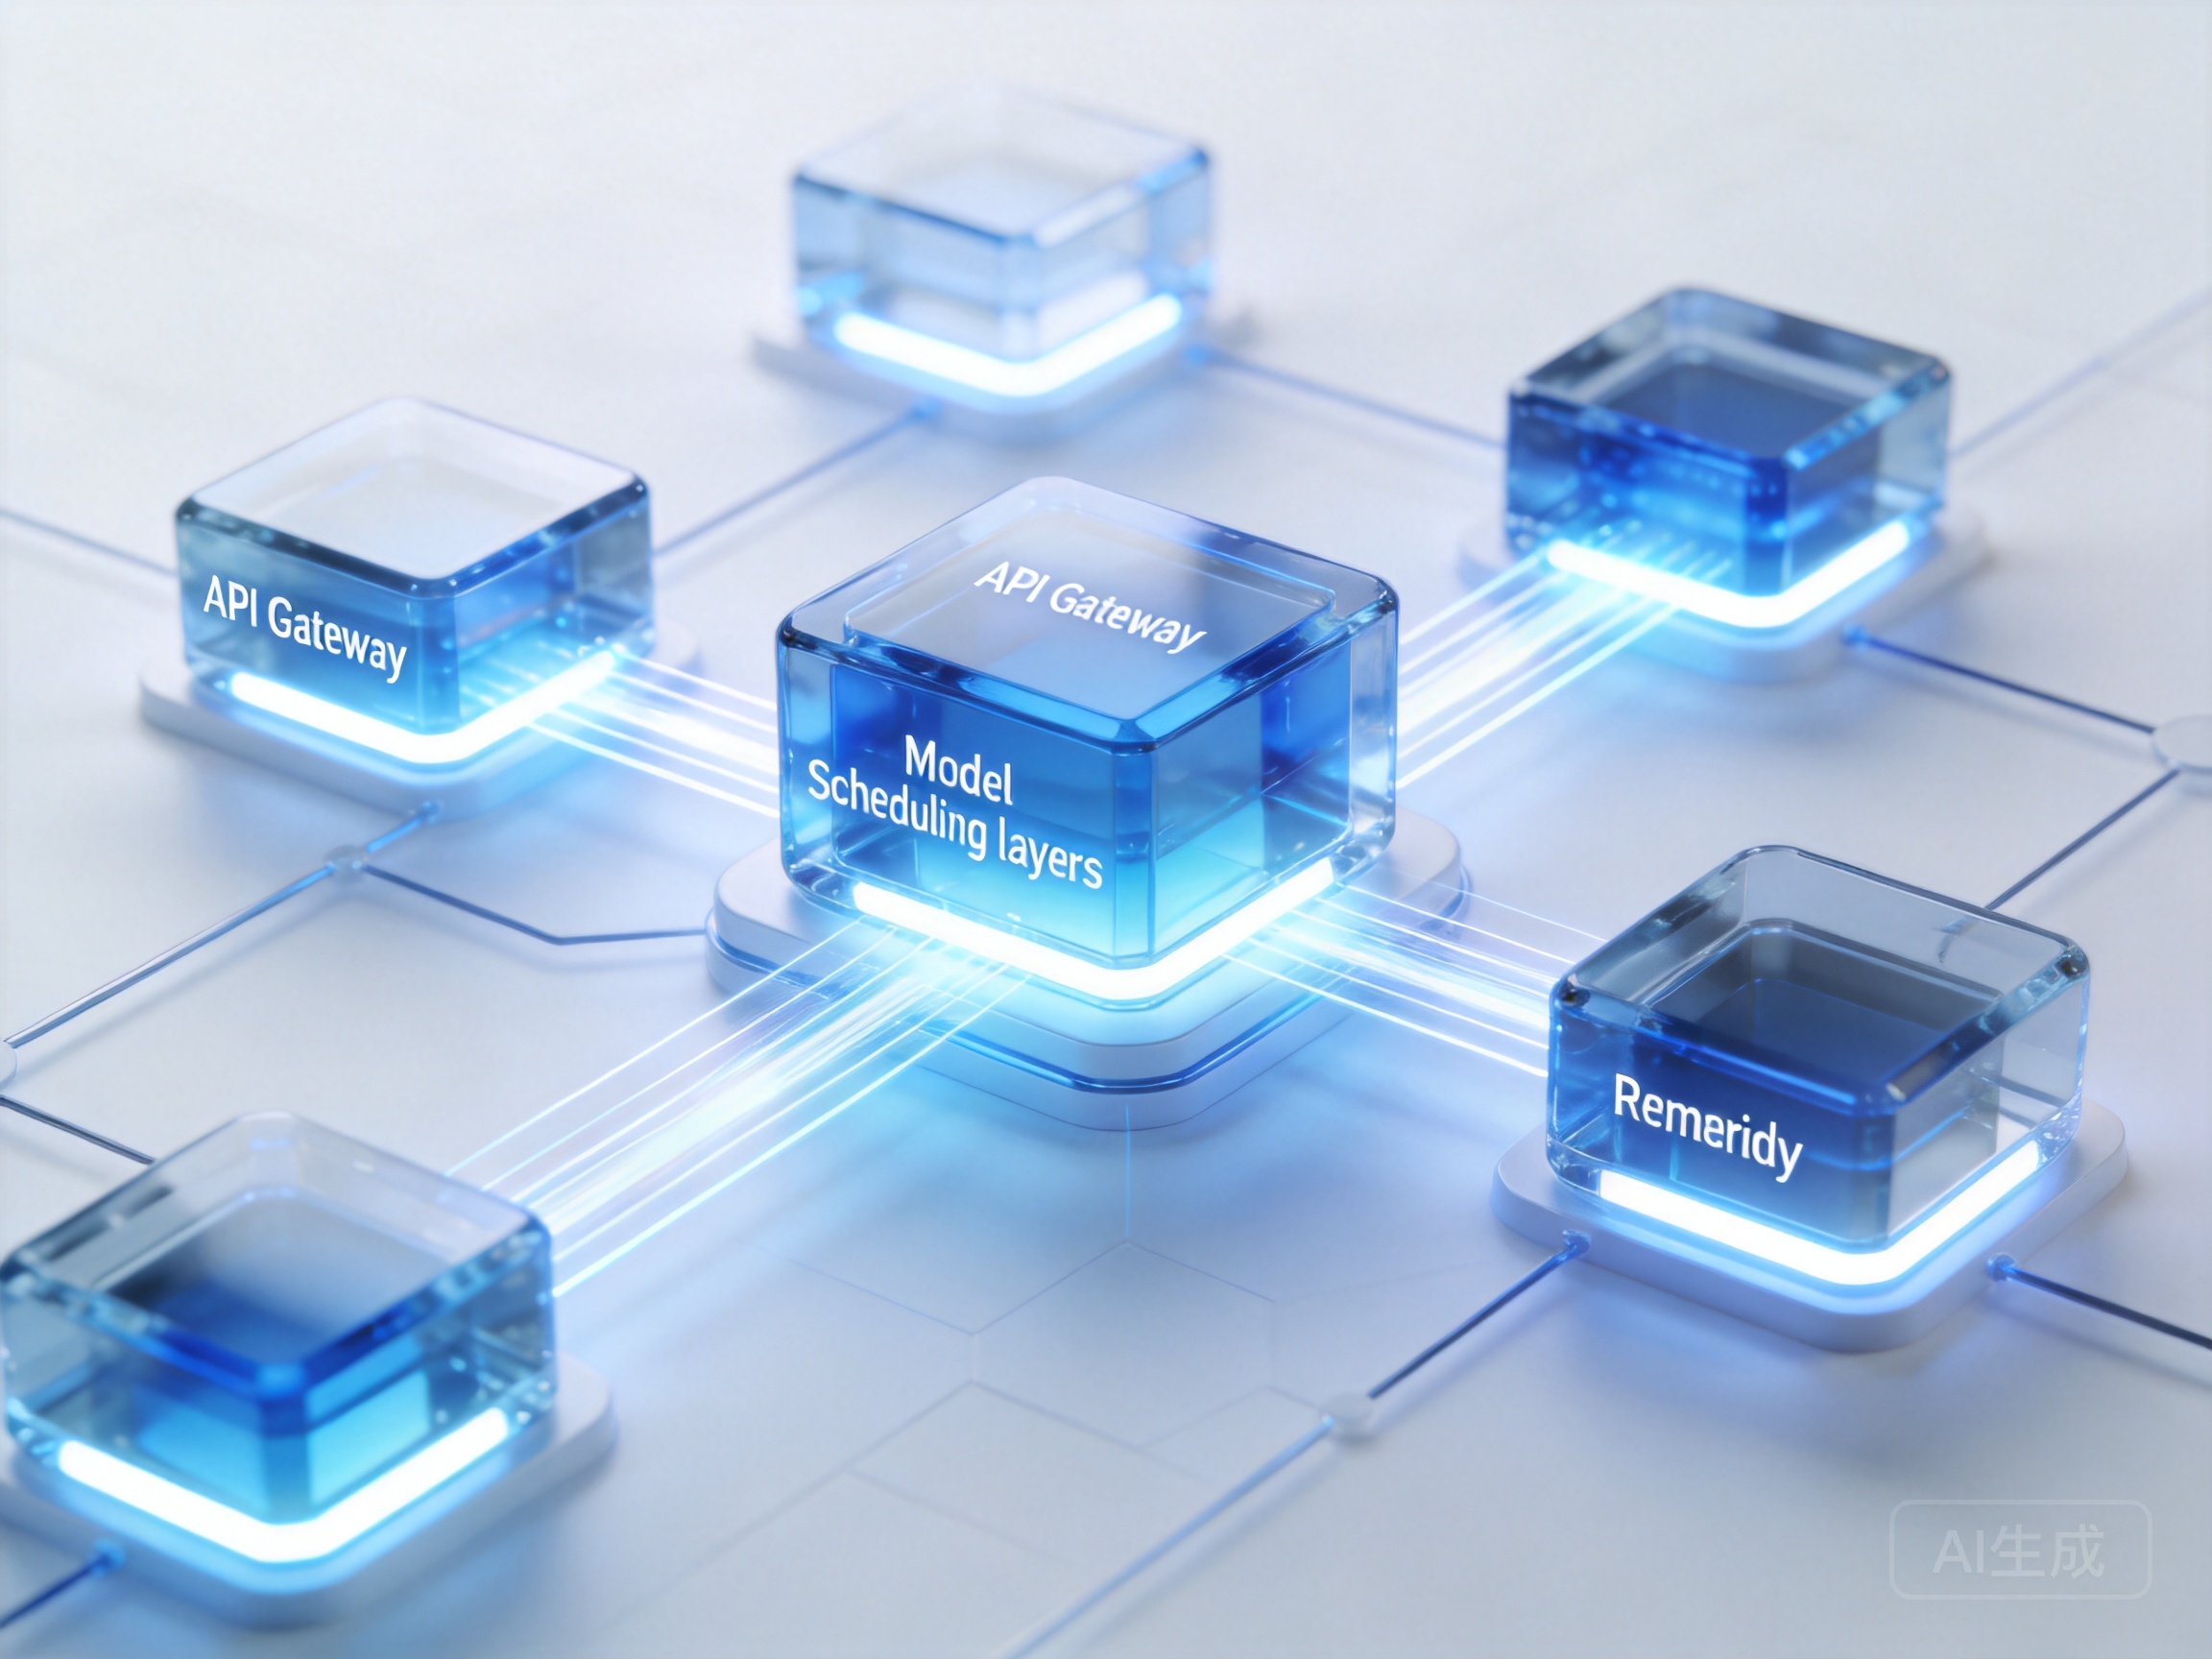
获取稳定可靠的接入端点是这一切的基础。开发者可以申请一个兼容多模型的七牛云API key,直接对接符合OpenAI标准的接口。这不仅简化了代码层的适配工作,还能利用平台提供的多模型调度能力,在Grok 4.3的智能与3.5 Flash的速度之间实现动态切换。
在轻量级Agent的架构设计中,没有绝对完美的模型,只有最契合业务约束的组合方案。理清Grok 4.3与3.5 Flash的成本与性能边界,结合高效的并发调用策略与延迟优化手段,你的AI应用才能在激烈竞争中跑得既快又稳。