AI与智能服务
未读
工业视觉RAG多模态模型本地低延迟部署落地
现代制造车间面临一个严峻挑战:产线缺陷种类繁多,传统机器视觉需要频繁重新训练模型。一旦引入云端大模型,又会遭遇断网停工和数据泄露的致命风险。打破这一僵局的核心在于工业机器视觉结合RAG:多模态模型本地部署与低延迟推理落地。这套方案让产线不仅能“看见”缺陷,还能查阅本地技术手册“思考”成因,彻底改变了
AI与智能服务
未读
多Agent协同系统性能调优与API降本
当企业级应用从单体大模型转向多智能体架构时,开发团队往往会遭遇意想不到的性能瓶颈。多个智能体在并发执行任务、共享上下文并频繁调用外部工具时,极易触发底层大模型接口的流控拦截,同时带来呈指数级上升的账单。多Agent协同系统性能调优:API频次限制突破与推理成本控制,已经成为工程师在系统走向生产环境前
AI与智能服务
未读
Vibe Coding无代码开发避坑指南:非技术创始人如何用Atoms搞定AI应用
当非技术背景的创业者试图将绝妙的业务创意转化为落地的AI产品时,往往会被复杂的底层逻辑、环境配置和服务器运维劝退。如今,AI氛围编程(Vibe Coding)理念的兴起打破了这一壁垒。开发者只需通过自然语言描述和可视化拖拽,就能让应用成型。但在这条看似平坦的快车道上,依然暗藏着逻辑死锁与部署崩溃的陷
AI与智能服务
未读
LM Arena盲测榜单:开源大模型性价比拆解
企业在接入AI模型时常被静态跑分迷惑,实际业务中却遭遇延迟高、逻辑断裂等问题。要真正筛选出适合业务的基座,必须依赖动态的、盲测的评估机制。今天我们通过一份详细的LM Arena模型盲测榜单:开源大模型推理性能与性价比全维度拆解,来看看如何拨开跑分迷雾,找到真正好用的开源模型。 破除跑分迷信:开源大模
AI与智能服务
未读
Loop Engineering 是什么?2026 年最热 AI 工程方法论完全解析
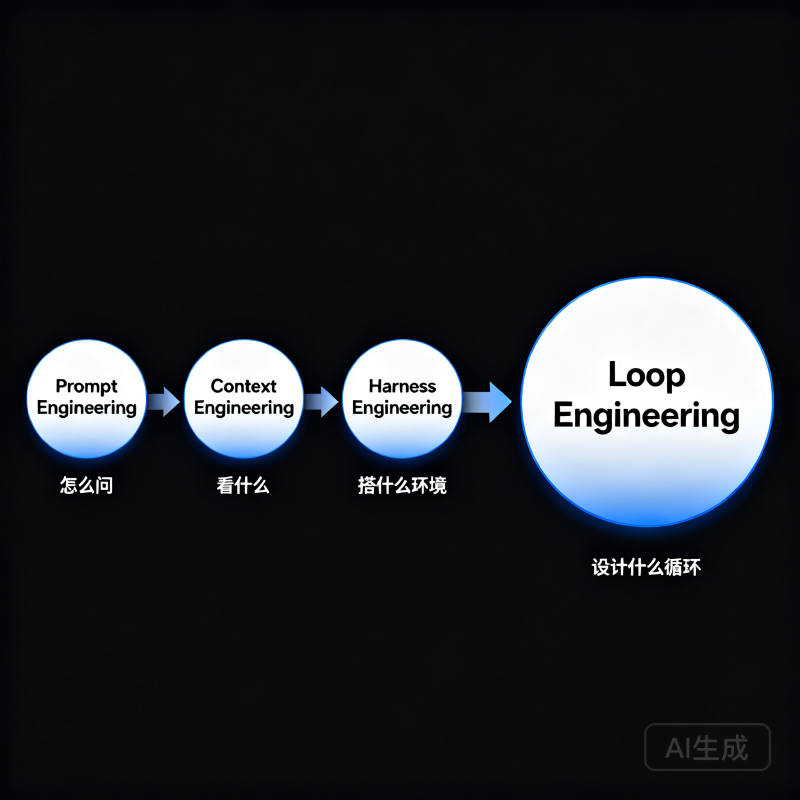
话题:AI Agent 工程 | 适用人群:开发者、AI 工程师、产品经理 Loop Engineering(循环工程)是 2026 年 6 月由 OpenClaw 创始人 Peter Steinberger 在一条引发 800 万次浏览的推文中正式提出的 AI Agent 工程范式——其核心主张是
AI与智能服务
未读
Ollama 模型选择全攻略:2026 年新手到底该 ollama run 哪个模型?
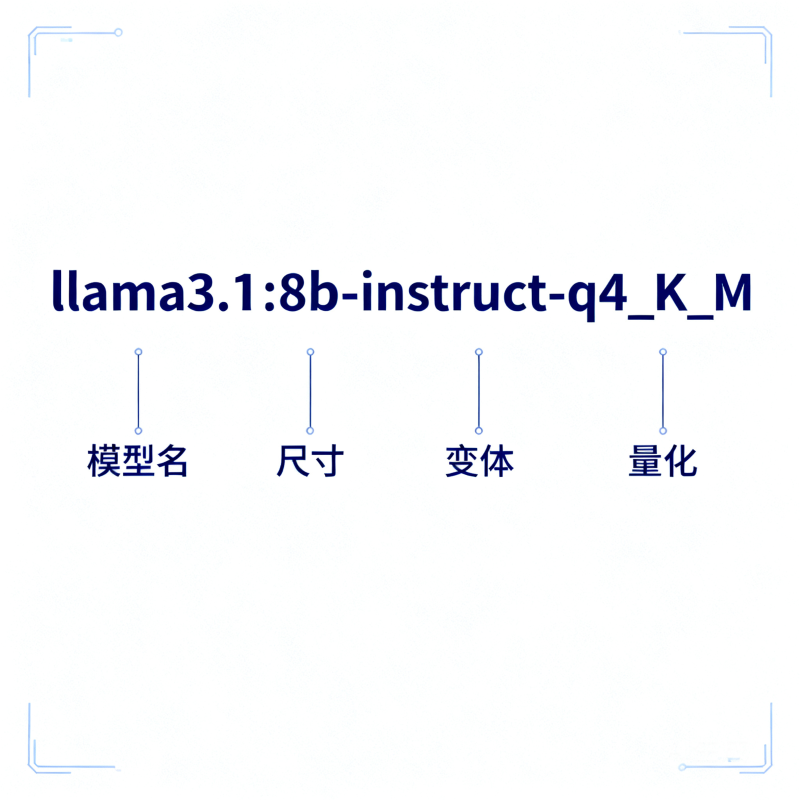
关键词:Ollama 模型选择、本地大模型、量化 tag、ollama run Ollama 是 2026 年最主流的本地大模型运行工具,本质上是给底层的 llama.cpp 套了一层傻瓜式外壳,一行 ollama run 命令就能把开源模型拉到本机离线运行。它的官方模型库已经覆盖从 270M 到
AI与智能服务
未读
端侧小模型推理优化与显存控制:突破移动端硬件瓶颈的实战指南
在智能手机和 IoT 设备上运行大语言模型,开发者最常遇到的噩梦就是 OOM(内存溢出)和设备发烫。要把动辄几个 G 的模型塞进只有极少可用运行内存的手机里,传统的云端部署思维完全行不通。要在有限的硬件资源下实现流畅的交互体验,核心在于掌握端侧小模型推理优化与显存控制的底层逻辑。 移动设备如何部署本
AI与智能服务
未读
LM Arena吞吐实测:推理模型选型指南
面对海量并发请求,企业在自有服务器上运行大模型往往会遭遇严重的显存瓶颈与延迟问题。很多技术团队在跑通了简单的测试节点后,一旦接入真实的生产环境,系统吞吐量就会断崖式下跌。这时候,一份详尽的LM Arena吞吐实测:本地代码推理模型性能对比与选型指南就成了刚需。到底用哪个框架才能榨干GPU的每一滴算力
AI与智能服务
未读
昆仑芯vs天数智芯实测:字节Doubao私有化部署底座选型指南
企业在接入大模型时,数据安全往往是不可跨越的红线。字节跳动的Doubao模型凭借出色的逻辑推理与文本生成能力,成为众多企业内部知识库改造与智能客服升级的优选。然而,当面临实际落地时,动辄百万的传统GPU集群采购成本让不少IT团队望而却步。为了寻找真正可落地的替代方案,技术团队通常会将目光转向国产算力