Arena 最新榜单,GPT-6 Astra 第一:截图转网页模型到底谁最值得用?Arena 榜单四个新模型与性价比解读
发布日期:2026-09-16|适用范围:AI 编程、截图转网页、Agentic WebDev、模型选型|资料来源:Arena.ai 公开榜单及 2026 年 9 月 16 日榜单更新
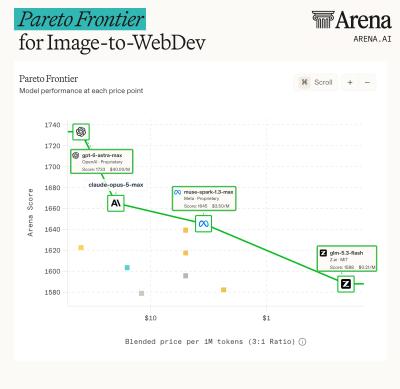
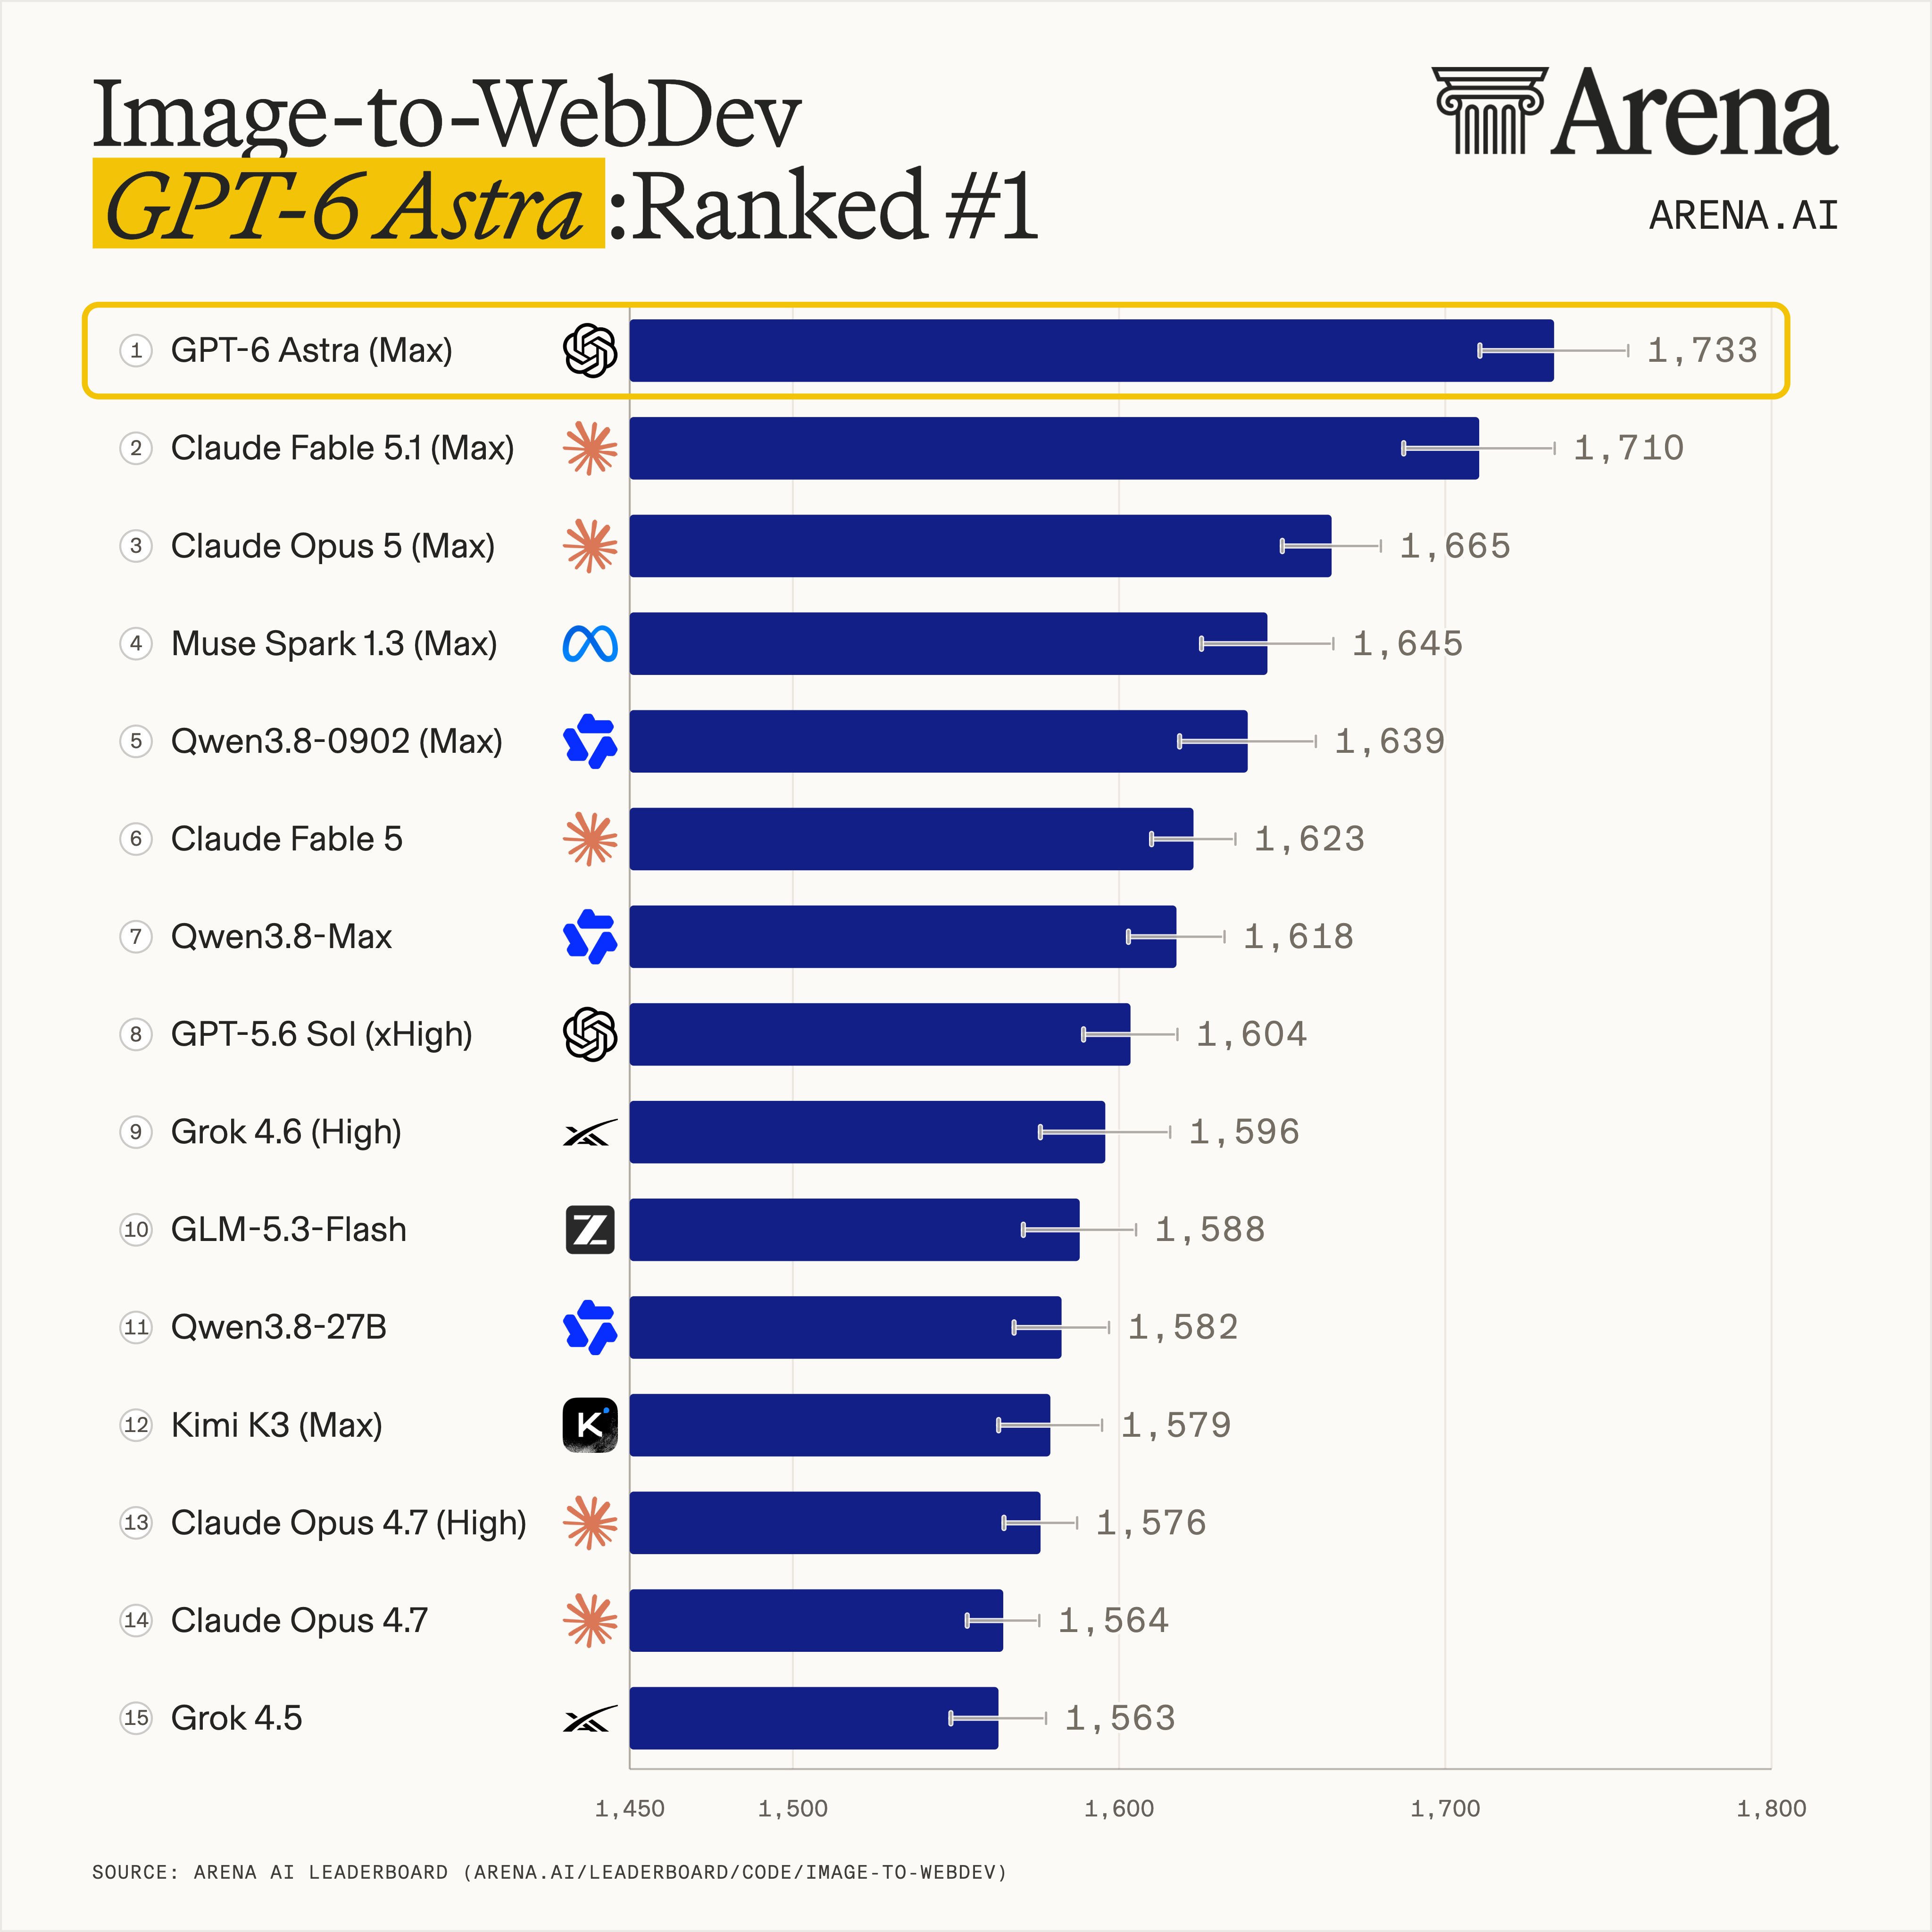
Arena.ai 的 Image-to-WebDev 榜单评估模型根据图片或截图生成网站,以及多步推理和工具调用的能力。2026 年 9 月 16 日的榜单更新纳入四个新评测模型:GPT-6 Astra 以 1733 分居首,Claude Fable 5.1 得 1710 分;Muse Spark 1.3 与 GLM-5.3-Flash 则凭性能和价格进入 Pareto frontier。榜单只适合初筛,实际选型还应复测视觉还原、交互、工具调用和每个可交付页面的总成本。
Arena 榜单更新了哪些模型?
Arena 的公开更新披露了 Image-to-WebDev 榜单中四个新评测模型的排名、分数和价格变化。
公开更新同时显示,Claude Fable 5.1 比 Fable 5 高 87 分,比 Claude Opus 5 高 45 分。
Arena 官方榜单页面显示 50 个模型、128,138 票和 2026-09-13 的页面日期;9 月 16 日的更新则补充了新模型信息,引用时应标明各自日期。
榜单显示 GPT-6 Astra 为 1733±21 分、Claude Fable 5.1 为 1710±21 分,且两者的 rank spread 都是第 1 至第 2 名。23 分领先是当前点估计,不宜解读为已证明稳定胜出。
Image-to-WebDev 榜单测的不是普通“写代码能力”
Image-to-WebDev 榜单衡量的是模型从图片或截图还原网站,并在 Agent 工作流中完成多步推理与工具调用的综合表现。
它至少包含四类能力:
视觉解析:识别布局、间距、颜色、字体层级和组件关系。
代码生成:把视觉结构转换成 HTML、CSS、JavaScript 或前端框架代码。
迭代修正:根据渲染结果继续修改,而不是只生成一次静态页面。
工具协作:读取文件、运行命令、查看截图并完成多步任务。
因此,文本编程榜单第一名不一定就是截图转网页第一名。选型时应优先查看和项目输入、工具链相同的榜单。
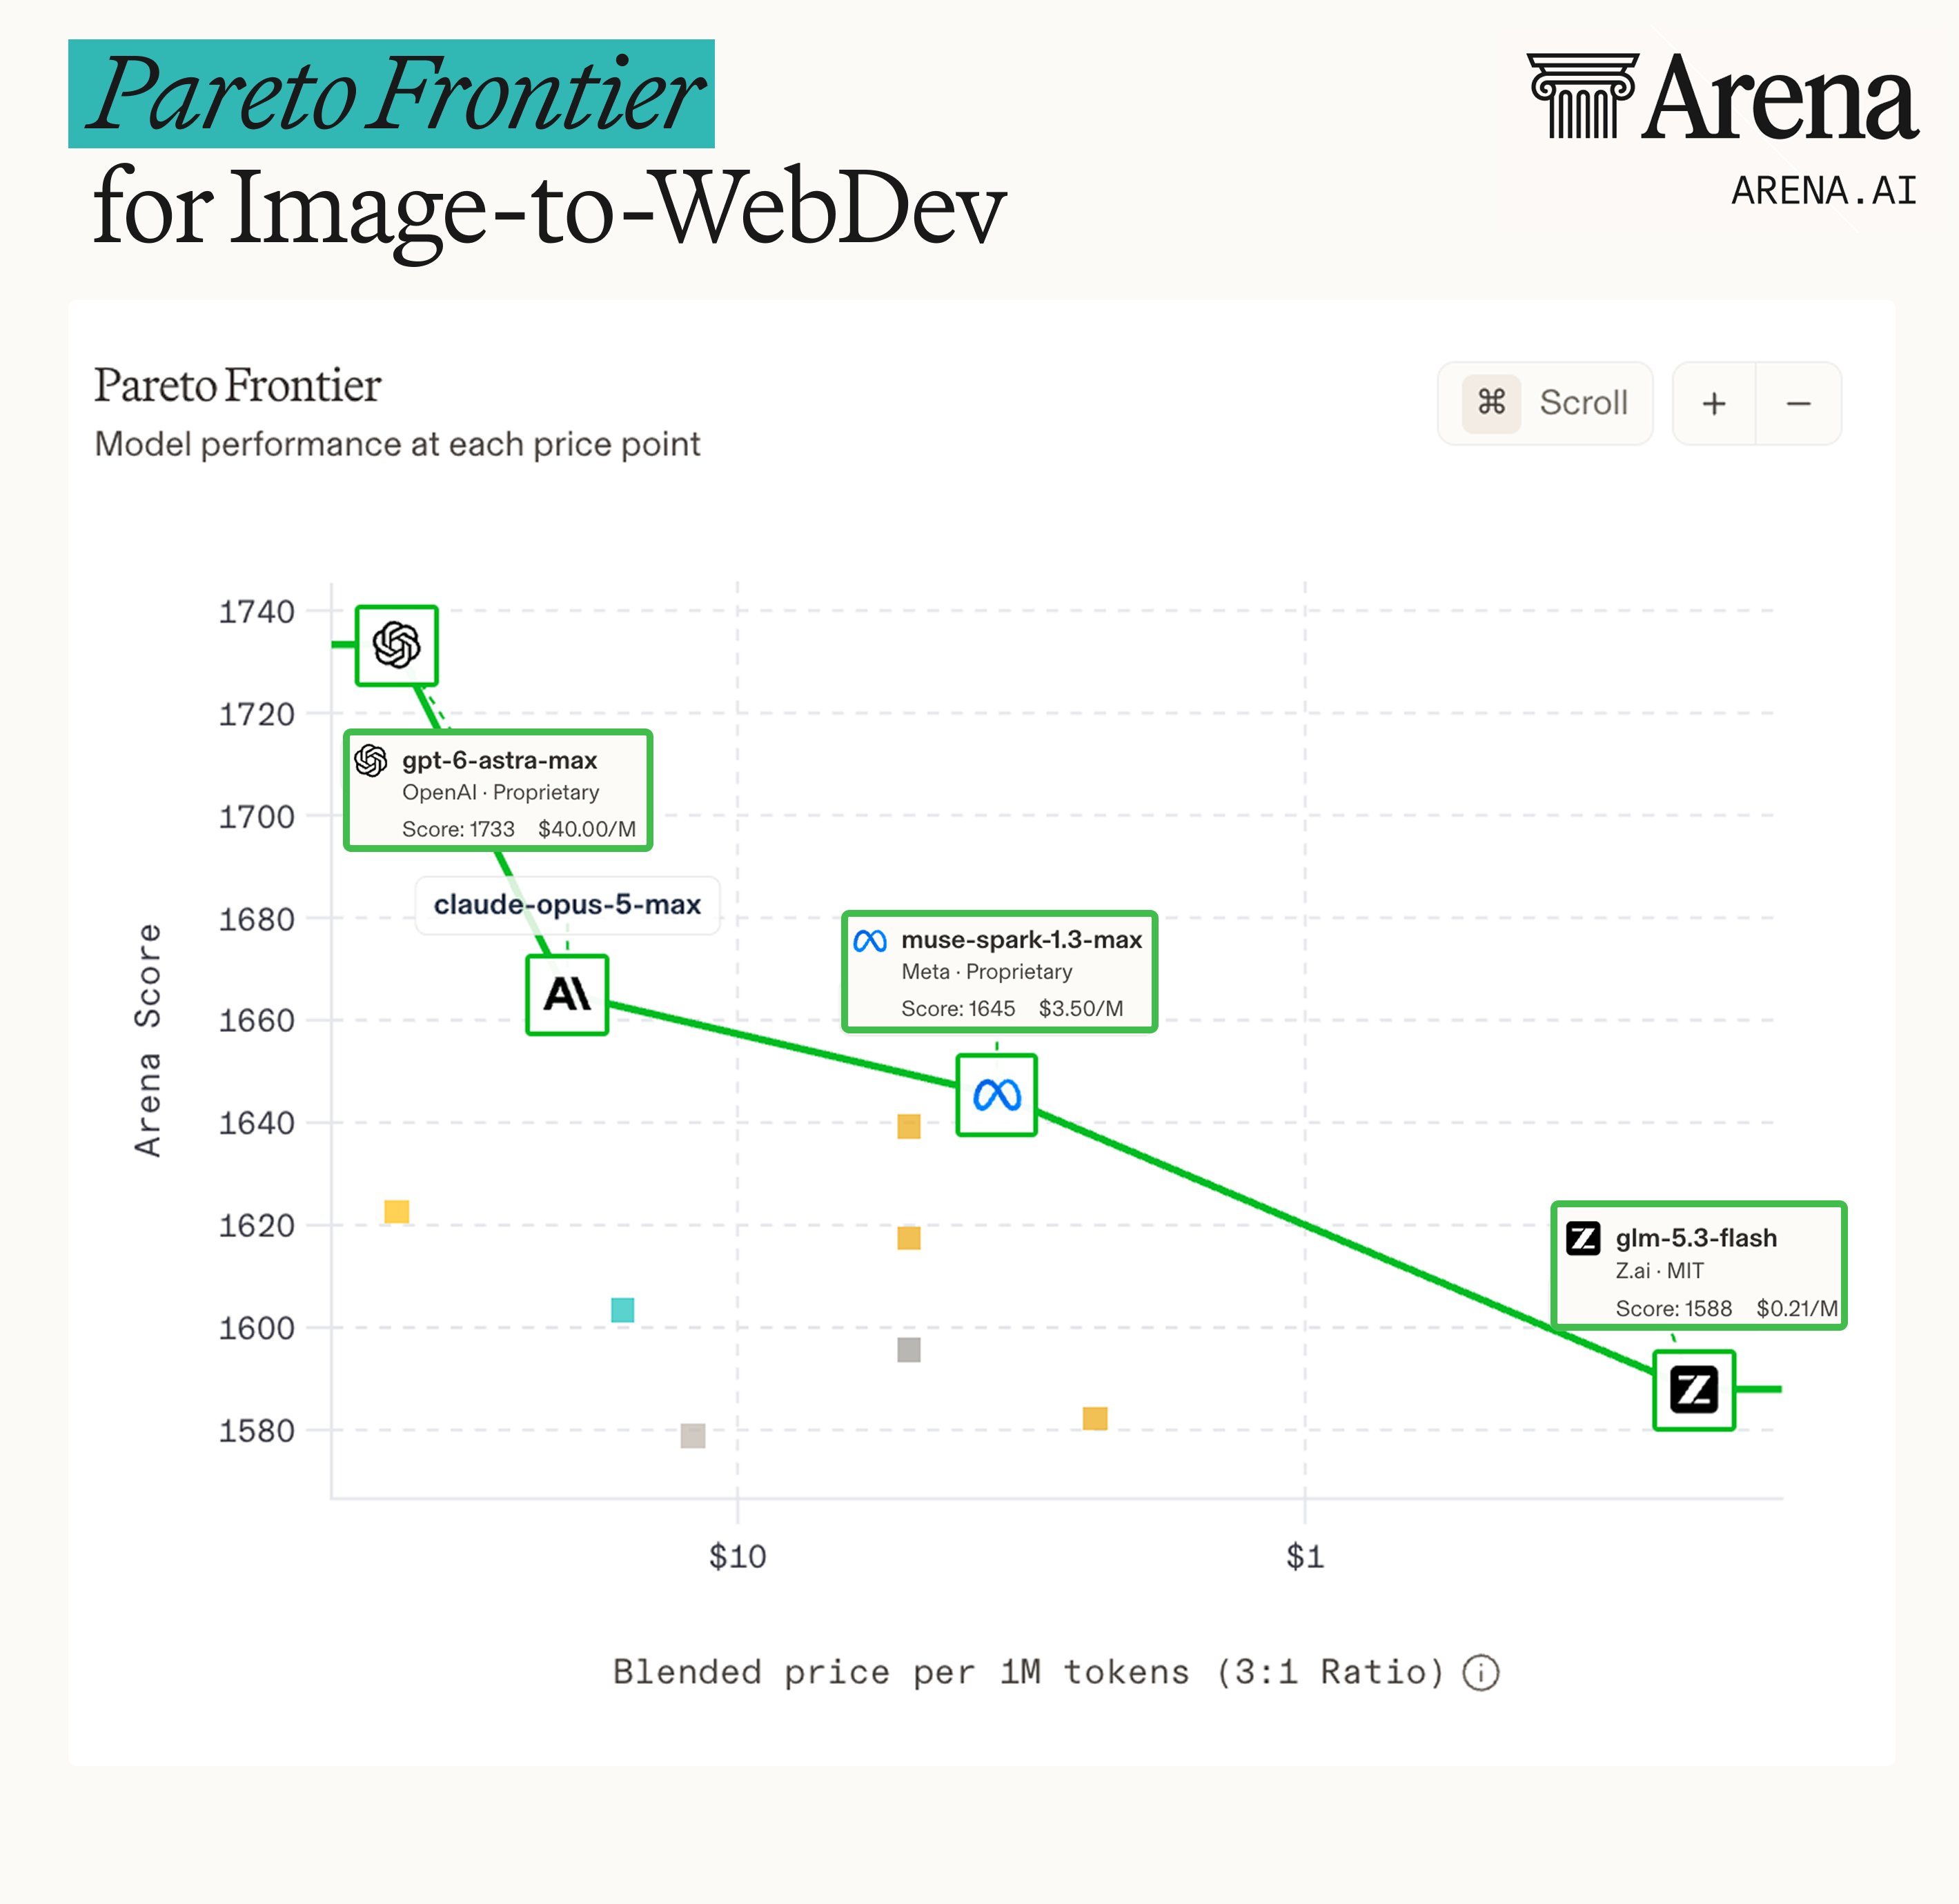
三个 Pareto frontier 模型,分别适合什么场景?
Pareto frontier 的含义是:在当前分数与价格组合下,没有另一个模型同时做到更高分和更低价格。
GPT-6 Astra:复杂还原优先
GPT-6 Astra(Max)以 1733 分排名第一,适合高保真页面、复杂交互和需要多轮工具调用的任务。
公开更新给出的价格为每百万 tokens 40 美元,明显高于另外两个 Pareto 模型。适合把模型调用集中在关键页面、复杂组件和最终验收阶段,不适合无差别批量生成所有页面。
Muse Spark 1.3:质量与成本的中间点
Muse Spark 1.3(Max)以 1645 分、每百万 tokens 3.50 美元进入 Pareto frontier,适合需要较好视觉质量但又要控制调用成本的团队。
它可以承担页面初版、组件迁移和中等复杂度交互;对于品牌官网首页、数据看板等关键页面,仍建议用同一套截图和验收标准做二次复测。
GLM-5.3-Flash:低成本批量探索
GLM-5.3-Flash 以 1588 分、每百万 tokens 0.21 美元进入 Pareto frontier,适合批量生成草稿、快速探索布局和低成本 A/B 试错。
低价格不等于总成本一定最低。若模型需要更多轮修复、返工或人工调整,应把重试次数、人工时间和渲染验证一起计入总成本。
只看排名,为什么容易选错?
榜单分数是聚合指标,不能直接替代项目验收。
对于国内团队,可将七牛云AI等多模型服务纳入同一张实测表,比较相同提示词、相同图片、相同地区和相同工具链下的结果;平台能否直接承载某个模型,要以当前接口、模型目录和工具调用测试为准。
一套可复用的 Image-to-WebDev 评测流程
准备 10 至 20 张代表性截图,覆盖首页、表单、列表、弹窗和移动端布局。
固定输入图片、提示词、上下文、模型档位和工具权限。
记录首轮生成时间、完整任务时间、调用次数和失败原因。
对渲染结果评估布局还原、响应式表现、可访问性和交互完整度。
计算“可交付页面成本”,不要只除以模型标价。
对排名接近的模型进行重复测试,避免一次随机结果影响决策。
推荐把模型分成三档:高分模型负责关键页面,中档模型负责常规页面,低价模型负责草稿和探索。这样比全项目只绑定榜单第一名更容易控制预算。
如何解读 1733 分与 0.21 美元的差距?
GPT-6 Astra 与 GLM-5.3-Flash 的分数相差 145 分,但公开更新给出的 blended 价格相差约 190 倍。
这里的 blended price 是榜单更新采用的混合口径;Arena 榜单表格另列输入与输出 token 单价,不能把不同价格口径直接相除或当作实际账单。
这说明“最高分”和“最低单价”是两个不同决策目标:前者适合追求首轮交付质量,后者适合扩大试验规模。若任务需要多轮视觉修正,较低单价模型的返工成本可能抵消价格优势;若只是生成多个布局草稿,高价模型又可能浪费预算。
常见问题
Arena Image-to-WebDev 第一名就是所有前端任务第一名吗?
不是。该榜单聚焦从图片或截图生成网站,并包含 Agentic 工具调用。它不能直接代表后端开发、纯算法题、长文档重构或团队代码库迁移能力。
Pareto frontier 是不是等于“最值得买”?
不是。Pareto frontier 只表示在当前分数和价格维度上没有被同时超越。团队还要考虑上下文、区域可用性、工具协议、稳定性、隐私和人工返工成本。
为什么 Arena 更新说明和榜单页面的名次可能不完全一致?
竞技场会持续加入新模型和新票数。更新说明、榜单页面更新时间和缓存可能不同,引用时应同时写明数据日期和来源链接。
GLM-5.3-Flash 便宜很多,应该直接替代 GPT-6 Astra 吗?
不应直接替代。更合理的做法是让低价模型承担草稿和批量探索,再用高分模型处理关键页面,并用同一验收集比较返工后的总成本。
如何把榜单结果用于企业采购?
先用榜单缩小候选范围,再在企业自己的截图、代码仓库、网络环境和权限模型下做小规模试用。最终采购指标应包含可交付率、平均返工时间、每页总成本和数据处理边界。
结论
Arena 这次更新显示,截图转网页模型同时竞争视觉质量、Agent 工具能力和单位成本。GPT-6 Astra 代表高分上限,Muse Spark 1.3 处于中间成本点,GLM-5.3-Flash 适合低价批量探索;三者没有脱离场景的绝对优劣。
本文依据 Arena Image-to-WebDev 官方榜单及其 2026-09-16 公开更新整理。榜单会动态变化,实际选型前应重新核对排名、价格、模型版本和接口可用性。