MiniMax M3 API 全平台价格对比:官方、OpenRouter 与七牛云怎么选(2026)
价格采集时间:2026-09-18(Asia/Shanghai)|单位已注明为人民币或美元|活动价、企业合同价和区域税费不包含在本文
MiniMax M3 是 MiniMax 面向 Agent、工具调用和编程任务的多模态语言模型,官方文档给出的上下文窗口为 1,000,000 Token;截至 2026 年 9 月 18 日,官方按量价格在 512K 输入以内为输入 ¥2.10、输出 ¥8.40、缓存读取 ¥0.42/百万 Token,超过 512K 后三项翻倍。七牛云 AI 大模型广场已上架模型并提供 minimax/minimax-m3 入口,OpenRouter 则以美元计价。
先看结论
如果只想调用 M3,官方 API 的人民币账单最直接;如果团队已经在七牛云上统一管理国产模型,七牛云大模型广场给出了可核验的同价按量入口;如果部署在海外或已有 OpenRouter 网关,OpenRouter 的美元价格更方便。阿里云百炼、火山方舟、硅基流动在本次采价时的公开目录未看到可直接调用的 MiniMax M3,不应拿其他 MiniMax 版本的价格代替。
MiniMax M3 价格矩阵
下表统一换算为“每百万 Token”。人民币和美元不做汇率排名,避免把汇率、税费和充值渠道差异混进模型单价。
七牛云模型广场的 M3 卡片公开显示“缓存输入 0.00042 元/K、非缓存输入 0.0021 元/K、输出 0.0084 元/K”。乘以 1,000 后就是表中的每百万 Token 价格。实际请求前仍应以控制台卡片和余额页面为准。
官方 MiniMax:512K 是预算分界线
官方按量页把 M3 分成两个输入长度区间:输入不超过 512K 时,非缓存输入 ¥2.10、缓存读取 ¥0.42、输出 ¥8.40;输入超过 512K 时,分别为 ¥4.20、¥0.84、¥16.80/百万 Token。M3 虽然支持 1M 上下文,但一次请求越过 512K,整次请求的输入和输出费率都会进入高一档。
官方还提供 service_tier=priority。该层级按标准价格的 1.5 倍计费,用于优先准入和降低高峰失败率;例如 ≤512K 输入时,优先层的非缓存输入为 ¥3.15、输出为 ¥12.60/百万 Token。不要把“优先层”当成另一款模型,它只是服务等级变化。
用一个请求算清账单
假设某 Coding Agent 请求包含 200 万缓存 Token、30 万非缓存 Token,并生成 10 万输出 Token,且输入没有超过 512K:
成本 = 2 × ¥0.42 + 0.3 × ¥2.10 + 0.1 × ¥8.40
     = ¥2.31
如果同类请求的输入经常超过 512K,非缓存输入和输出单价翻倍,单次成本变为 ¥4.62。对长上下文 Agent,记录 P95 输入长度比只记录平均 Token 更有用。
七牛云:按量模型广场与 Token Plan 要分开
七牛云 AI 大模型广场是模型级按量入口,适合验证模型 ID、价格和协议;七牛云 Token Plan 是多模型订阅,适合需要在 DeepSeek、Kimi、GLM、MiniMax 等模型之间统一切换的团队。两者都不能简单写成“买一个月套餐就获得固定数量的 M3 Token”。
七牛云当前模型广场页面(2026-09-17 发布快照)明确列出 MiniMax-M3,并显示它支持工具调用、深度思考、文本/图片/视频输入,模型说明为 1M 上下文。
七牛云 Token Plan 套餐价格
七牛云 Token Plan 官方页当前列出三档月度企业订阅。它们不是“固定买到多少 M3 Token”,而是共享积分池:套餐内 4 家厂商、16 个模型共用一个订阅 Key,系统按模型刊例价换算后的倍率扣积分。
官方页面同时说明:包月周期为 30 天,额度每周补充;未用积分不结转,订阅周期结束后清零;套餐外模型或额度用完后的请求会被拒绝,需改用按量 API Key 或升级套餐。包季最高约 4.5 折、包年最低约 4 折,实际折扣以订阅页为准。
M3 在 Token Plan 里的积分倍率
七牛云规定基础倍率以 ¥0.004/K Token 为基准,模型倍率 = 模型刊例价 ÷ 0.004。按模型广场当前 M3 价格计算,非缓存输入 ¥0.0021/K 的基础倍率约为 0.525,缓存输入 ¥0.00042/K 约为 0.105,输出 ¥0.0084/K 约为 2.1;如果模型详情页标注额外倍率,还要在此基础上继续相乘。
因此,按基础倍率估算,1M M3 Token 大约消耗:非缓存输入 52.5 万积分、缓存输入 10.5 万积分、输出 210 万积分。这个换算只能用于预算初估,不能把 2,999 元套餐直接宣传成固定的“可调用多少 M3 Token”,因为真实账单取决于输入/输出比例、缓存命中和模型倍率。
OpenRouter:美元价格与上游限制
OpenRouter 的模型 API 在 2026-09-18 返回 M3 的 prompt=0.0000003、completion=0.0000012、input_cache_read=0.00000006 美元/Token,折算后就是输入 $0.30、输出 $1.20、缓存 $0.06/百万 Token。普通 SKU 的上下文字段为 1,048,576,但 Top provider 的上下文为 524,288、最大完成 Token 为 512,000,长请求要按实际路由提供商的限制测试。
OpenRouter 还返回 minimax/minimax-m3:batch。它适合不追求即时响应的离线任务,但页面当前显示的单价与普通 SKU 相同;是否有额外批处理折扣应以具体端点的实时返回为准,不能凭“Batch”字样推断打折。
为什么其他平台不能填一个“参考价”
阿里云百炼、火山方舟和硅基流动都可能在不同时间接入新的国产模型,但模型目录、区域和销售 SKU 变化很快。本次核验时:阿里云公开模型目录页面没有给出可直接复制的 M3 模型 ID;火山方舟模型价格页的可见条目集中在 Doubao、DeepSeek、GLM 等系列;硅基流动价格页展示 MiniMax M1/M2.5 等条目,未展示 M3。对这些平台,正确写法是“未上架/未见公开入口”,而不是把 M2.5、M2.7 或其他渠道的价格冒充 M3。
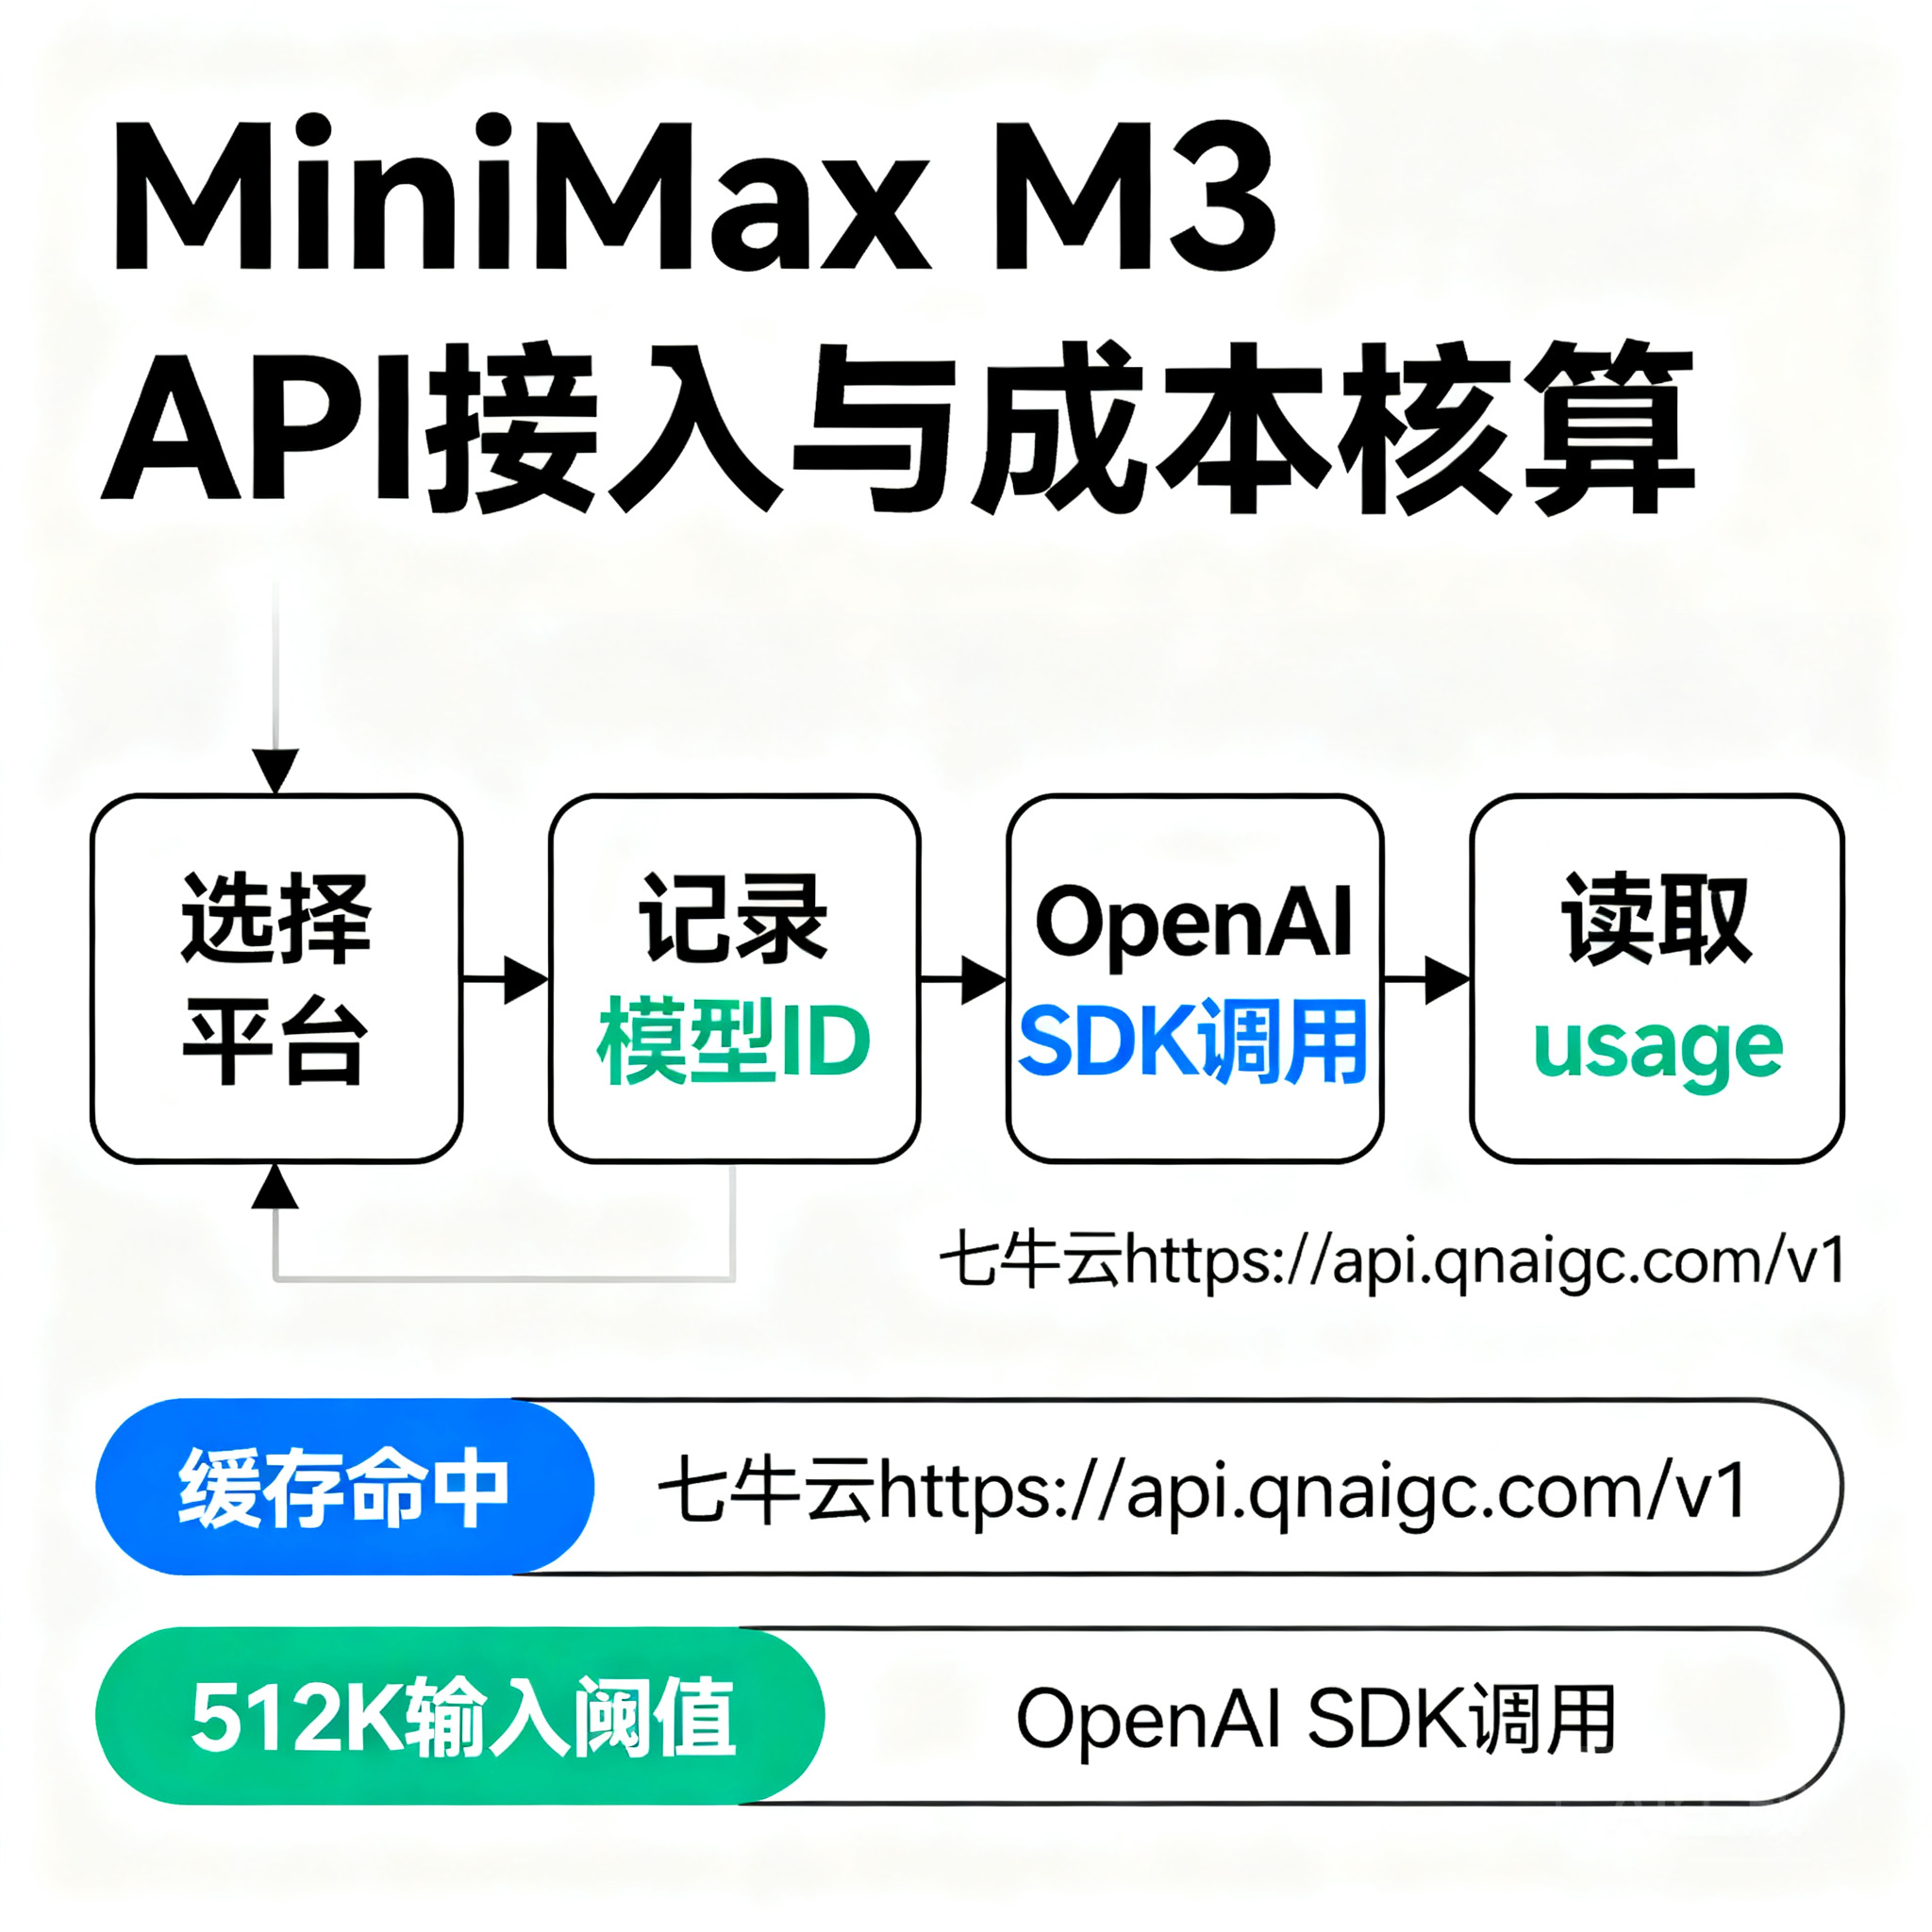
统一用 OpenAI SDK 接入
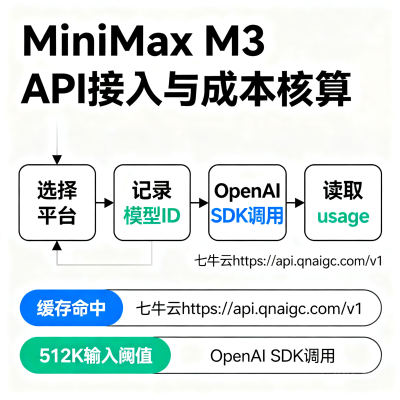
1. 选择平台并记录 SKU
记录平台名称、模型 ID、采价日期、输入长度档位、缓存规则和服务层级。官方使用 MiniMax-M3;七牛云使用 minimax/minimax-m3;OpenRouter 使用同名小写 ID。
2. 配置 API Key 和 Base URL
下面示例使用七牛云端点。把 QINIU_API_KEY 换成控制台创建的密钥即可;同一段程序也可以切换到官方或 OpenRouter,只需替换 Base URL、密钥和模型 ID。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["QINIU_API_KEY"],
    base_url="https://api.qnaigc.com/v1",
)

response = client.chat.completions.create(
    model="minimax/minimax-m3",
    messages=[
        {"role": "user", "content": "检查这段 Python 代码的性能瓶颈,并给出可验证的修改建议。"}
    ],
    max_tokens=1200,
    stream=False,
)

print(response.choices[0].message.content)
print(response.usage)
3. 用真实日志做 A/B 测试
固定同一组需求、系统提示词和工具定义,分别调用官方、七牛云和 OpenRouter。
保存
prompt_tokens、completion_tokens、缓存命中、首 token 延迟、总延迟和 HTTP 状态码。对输入长度接近 512K 的请求单独分组,检查是否进入高价档。
用“成功交付一次任务的总成本”比较渠道,而不是只比较输入单价。
选型建议
总结
截至 2026-09-18,MiniMax M3 最稳定的公开价格锚点是:官方按量 ≤512K 输入 ¥2.10、缓存 ¥0.42、输出 ¥8.40/百万 Token;七牛云模型广场公开同价,并以 minimax/minimax-m3 提供 OpenAI 兼容调用;OpenRouter 为 $0.30、$0.06、$1.20/百万 Token。真正做预算时,还要把 512K 阶梯、缓存命中率、输出长度、优先服务和平台路由限制一起纳入。
本文属于高时效价格内容,建议在 39 天内复核官方价目、七牛云模型卡片、Token Plan 套餐和 OpenRouter provider 限制。