最新!Qwen3.8-Omni-Flash发布全解:原生全模态+1M上下文,音视频Agent价格砍掉九成
发布日期:2026-09-18
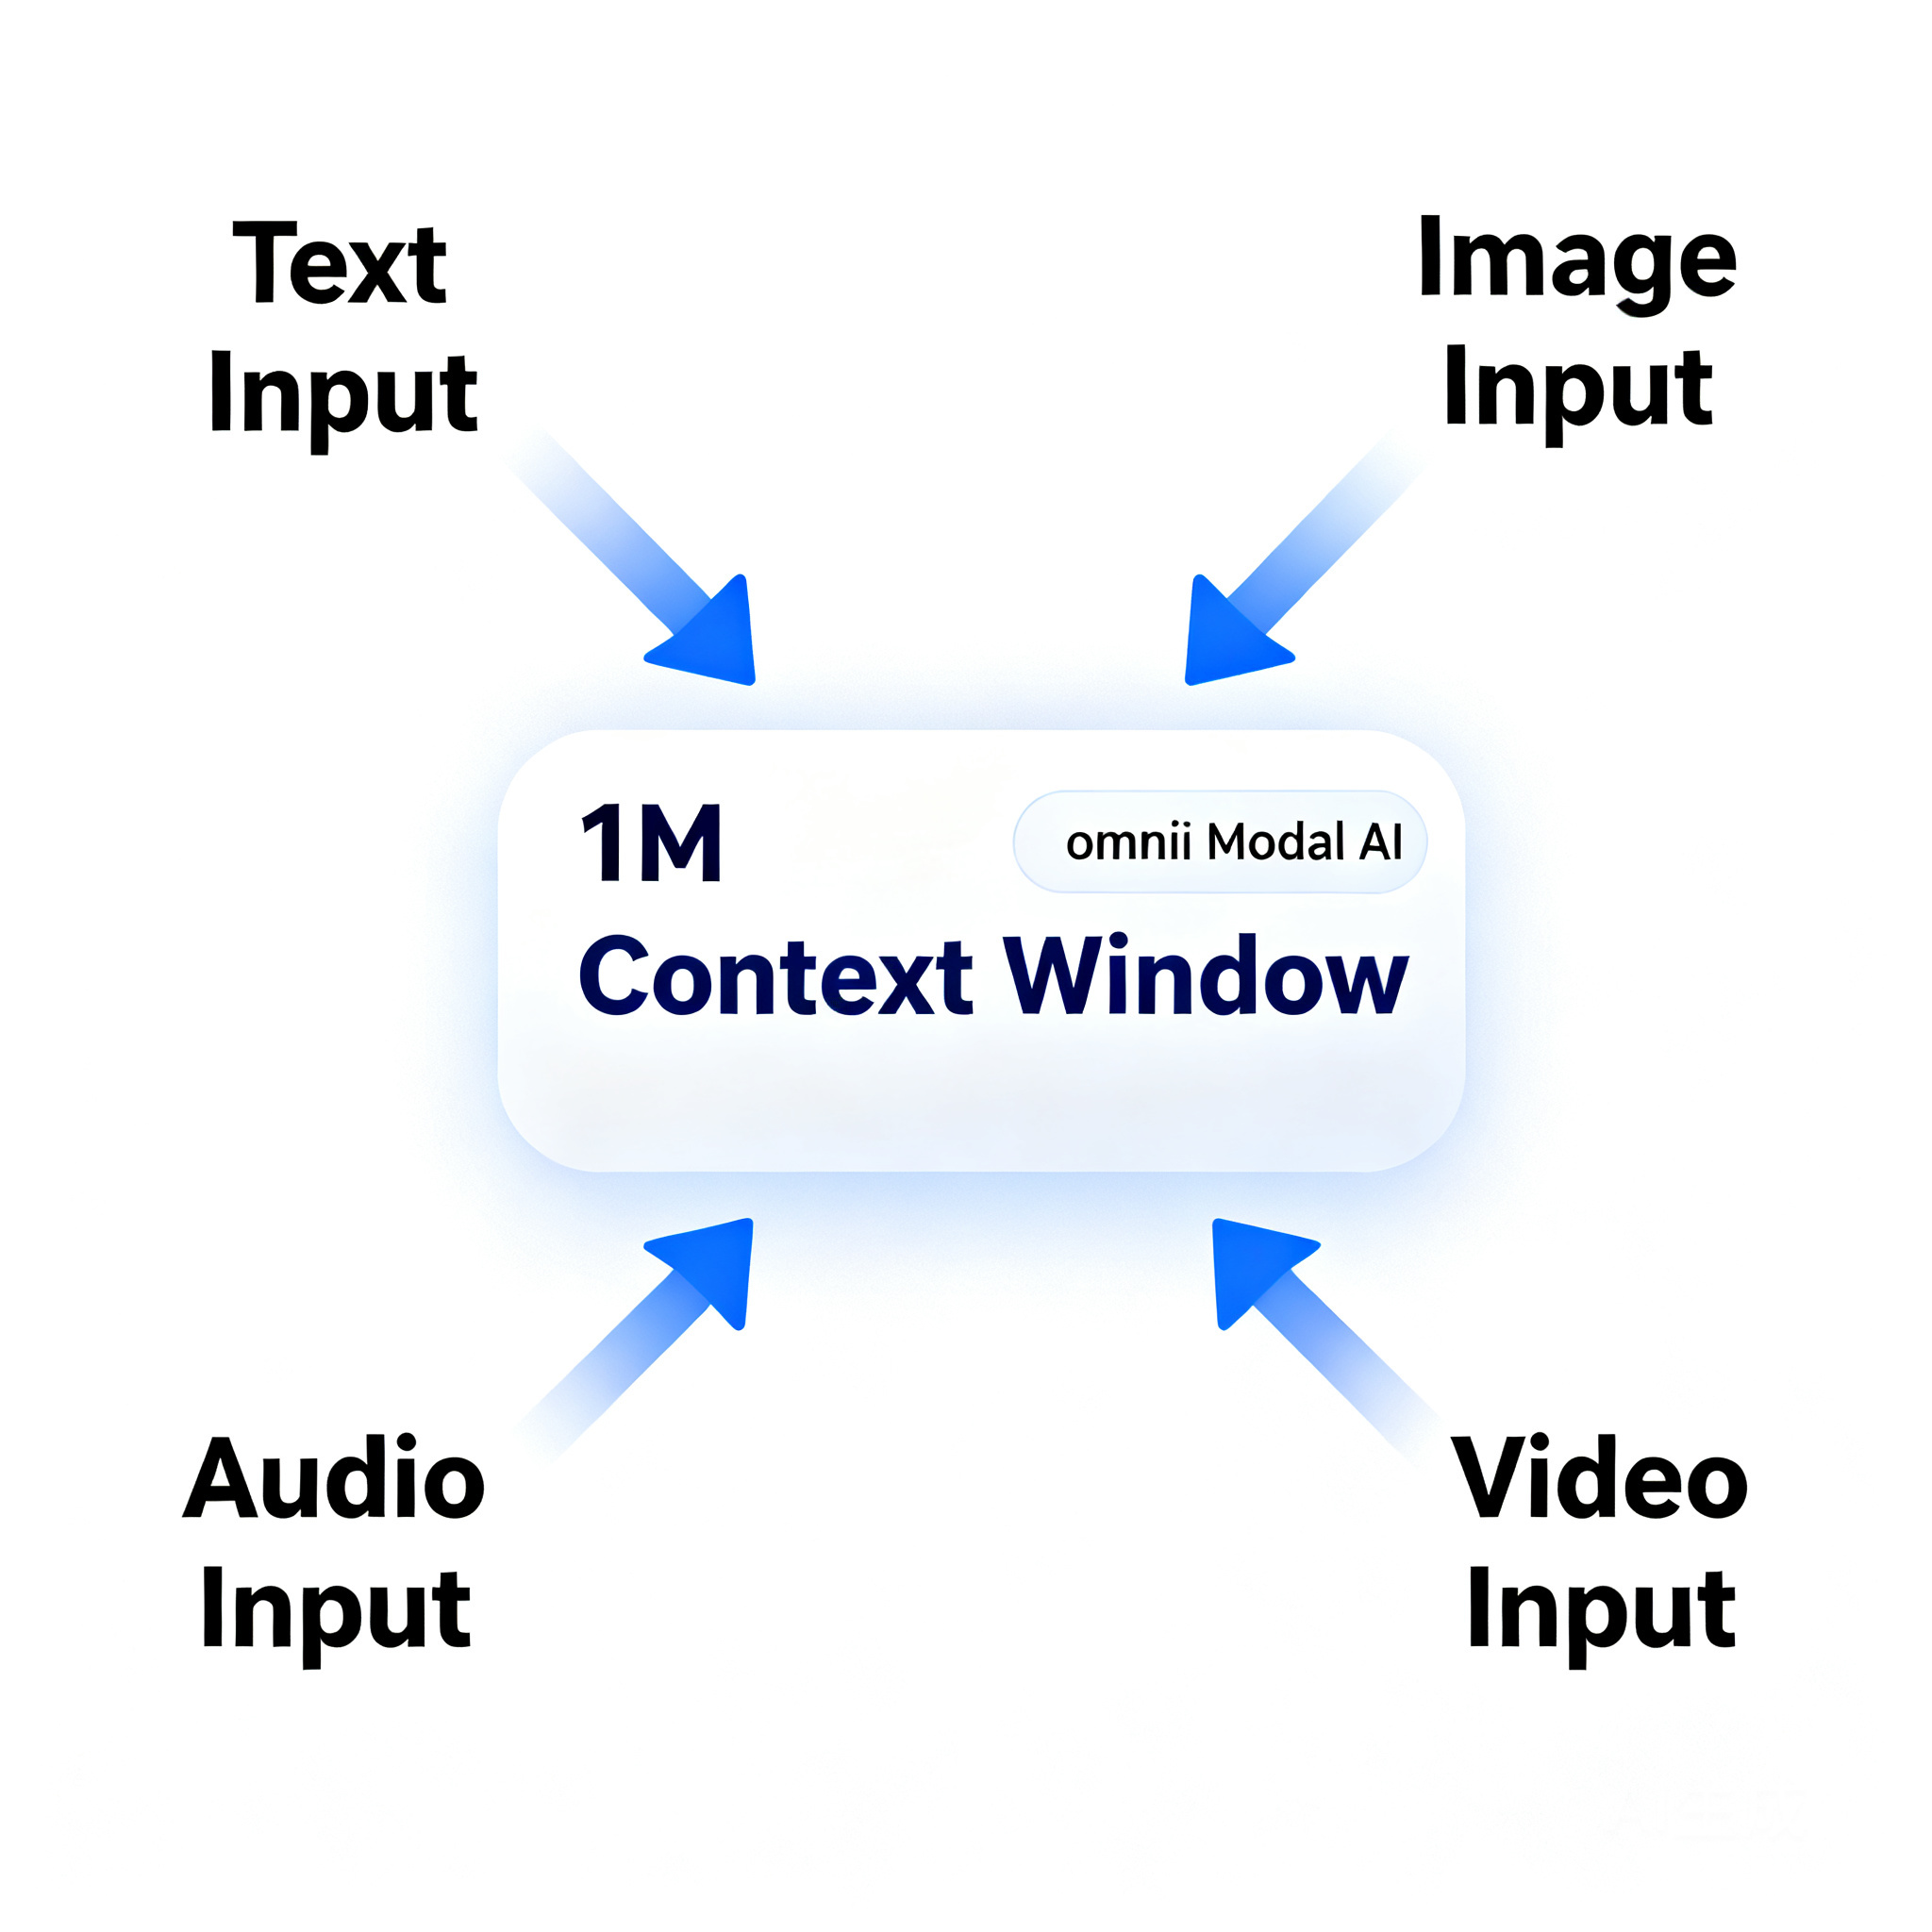
Qwen3.8-Omni-Flash是阿里Qwen团队在2026年9月推出的下一代原生全模态模型,一次吃进文本、图像、音频、视频四种输入并保持1M token上下文,文本能力与同尺寸纯文本模型相当,全模态能力显著拉升,配套Realtime API与Qwen-MM-Plugins直接进Agent工作流。本文基于Qwen官方博客与QwenCloud模型页,还原评测涨幅、价格降幅、场景矩阵与落地三件套,并给出与Flash底座的关系和接入要点。
核心定义:Omni-Flash是什么
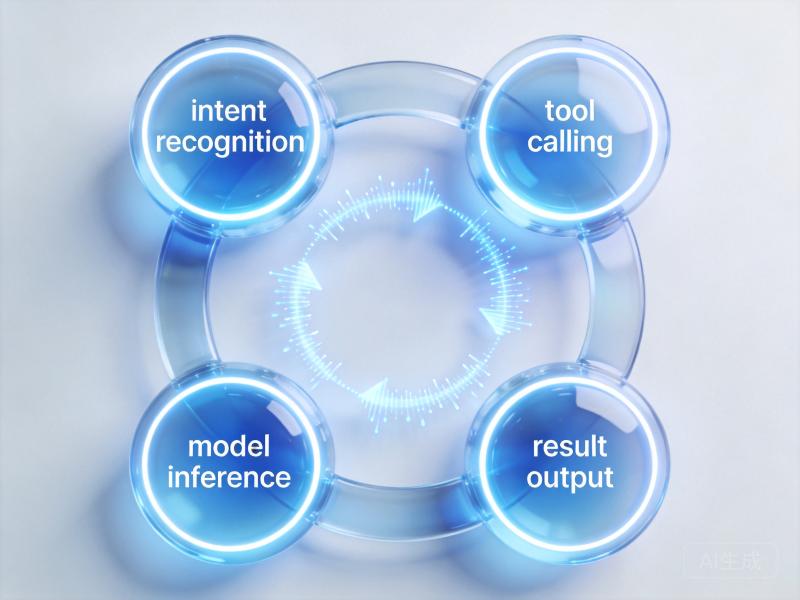
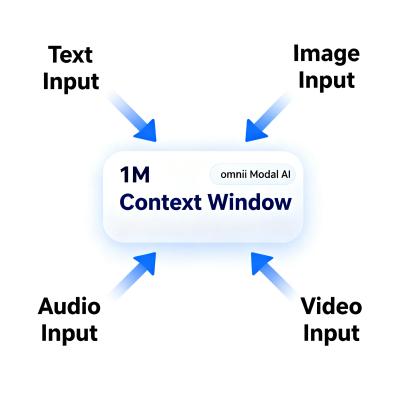
Qwen3.8-Omni-Flash是构建于Qwen3.8-Flash-Next架构上的原生全模态旗舰模型。据Qwen官方博客2026年9月版本,模型原生接受文本、图像、音频、视频输入,上下文窗口为1M token,为真实生产力场景的Agent能力而设计,覆盖编程、知识工作、GUI交互与音视频一体化任务。
原生是关键词:不是外挂转写通道,而是同一模型内理解四模态,输出为文本。
评测:29项平均+25%,三块Agent榜单点名
据Qwen官方博客,在29项评测上其平均分较Qwen3.5-Omni-Plus提升超25%,文本性能与同尺寸纯文本模型相当。
音视频Agent与长程任务是主战场:WildClawBench-MM提升36.5分,AgenticVBench提升22.3分,UniClawBench拿到69.6分。据官方表述,口号即Omni Senses加Agentic Delivery,榜单选的也全是交付向基准,不是纯问答刷分。
价格:音频每小时-98%,音视频每小时-93%
性能涨的同时价格直接砍。据Qwen官方博客,每小时音频输入价格下降超98%,每小时音视频输入价格下降超93%。
QwenCloud模型页2026年9月版本给出Token口径:输入每百万0.15美元,输出每百万0.47美元,隐式缓存输入每百万0.016美元。配额为每分钟200万Token、每分钟3万次请求,最大输入991K、最大输出131K,思考模式下输入983K,最大推理262K。
此前Flash底座据IT之家等2026年8月26日报道,千问AI平台定价为每百万Token输入1元、输出3元,Omni版本国际站走美元口径,对照时注意区分平台与币种。
场景:1M上下文一次装下音视频活
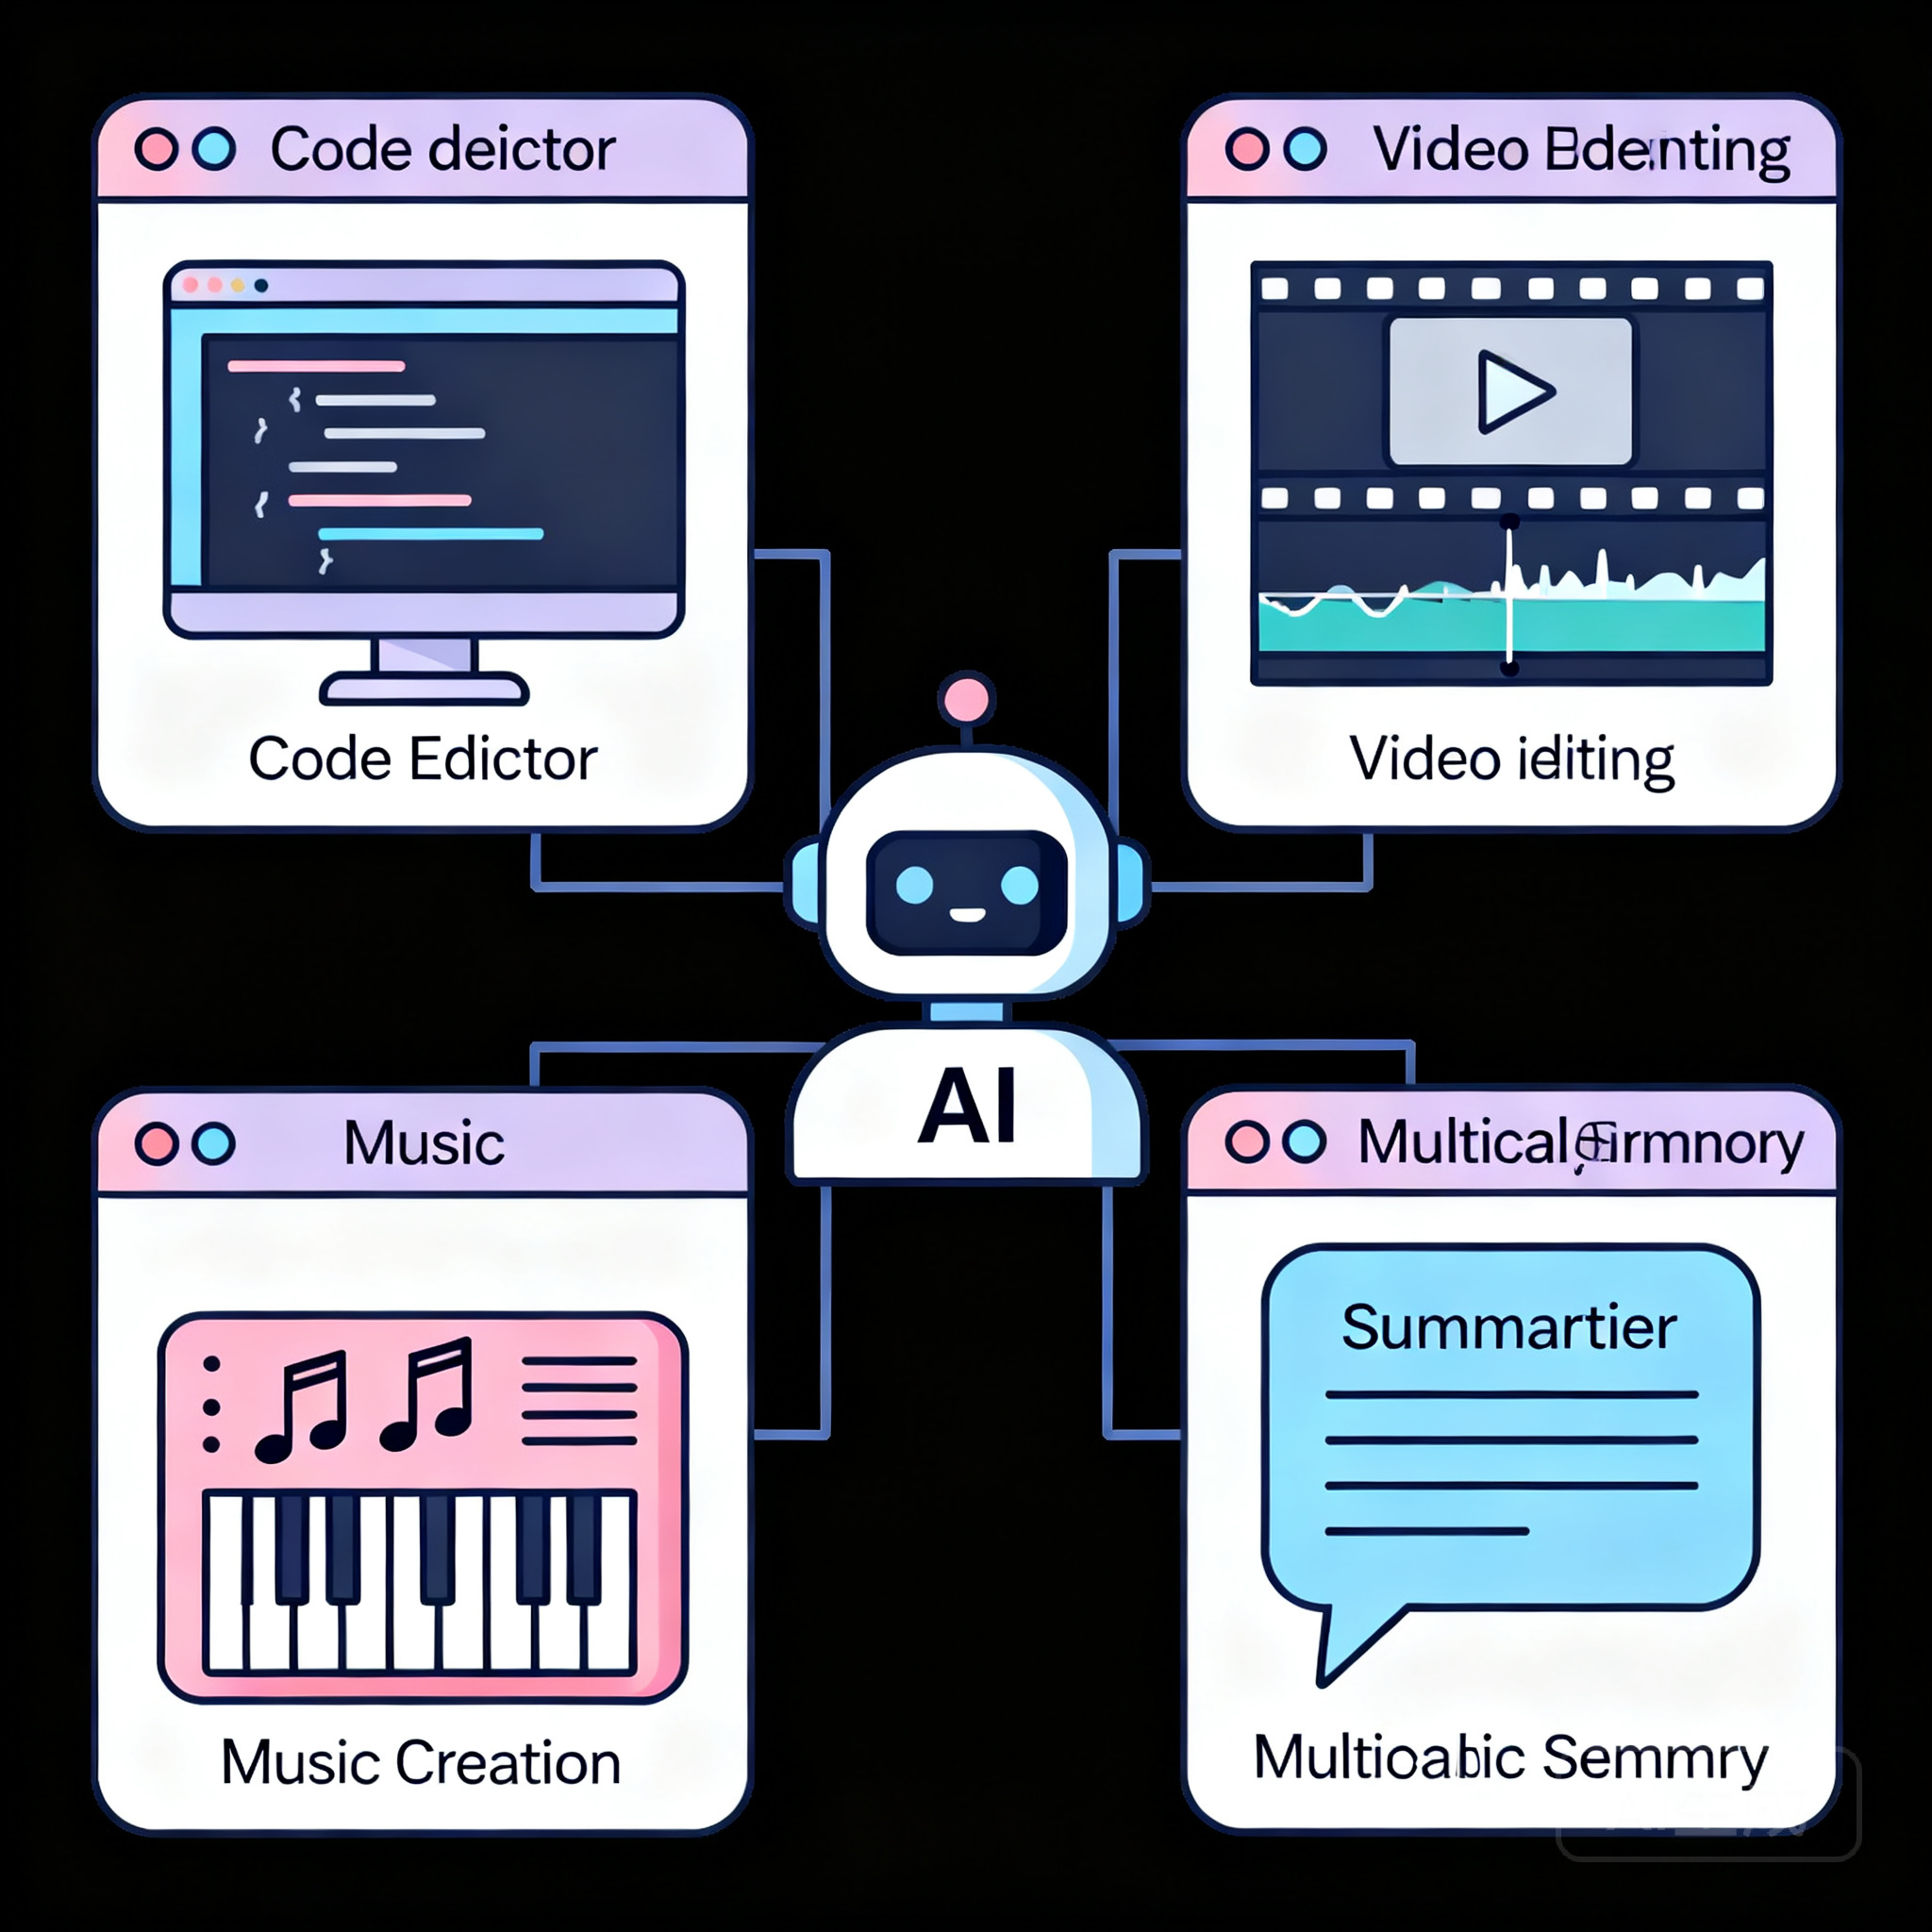
1M窗口配四模态,官方点名的活全是长料:视频剪辑、音乐MV创作、影视制作与解说、多媒体总结、音视频对话,外加编程、知识工作、GUI交互。据QwenCloud模型页,模型支持双声道与四声道空间音频理解,兼容DashScope与OpenAI双协议,内置web_search等工具,函数调用、结构化输出、上下文缓存、批量调用均可用。
一句话:以前音视频Agent要拼转写加切片加多模型,现在一路端到端,窗口一次给到991K输入上限。
落地三件套:Realtime API、MM-Plugins、Studio
模型发布同时给了三件交付物。据Qwen官方博客,QWEN3.8-OMNI-FLASH API与REALTIME API同步上线,Qwen Studio与QWEN-LIVE HARNESS承接体验侧。
最值得开发者看的是Qwen-MM-Plugins。据官方博客,这是一个面向Agent Harness的多模态插件套件,赋予Agent理解图像、音频、视频、文档的能力,支持长视频记忆与内容创作,已适配Codex、Claude Code、Qwen Code、Gemini CLI、Qoder、CodeBuddy、OpenClaw七家,社区可贡献。安装直接在常用办公Agent里用自然语言说一句:
Help me install the core, api, and omni-related plugins from https://github.com/QwenLM/Qwen-MM-Plugins.OpenAI协议调用长这样,模型名填qwen3.8-omni-flash,输出只支持文本:
from openai import OpenAI
import os
client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{"role": "user", "content": "Who are you?"}],
    modalities=["text"],
    stream=True,
    stream_options={"include_usage": True},
)
与Flash底座的关系:一句话说清
Omni-Flash站在Qwen3.8-Flash-Next肩上。据2026年8月26日IT之家、界面等报道,Flash底座是基于下一代Qwen4架构的多模态MoE技术预览:主模型125B参数加51B N-gram Embedding,每token仅激活6B,原生262,144上下文并可用YaRN扩到1M,训练成本约为Qwen3.7-Plus的九分之一,6B激活下14个基准中8个最优,权重已在Hugging Face与ModelScope开源并同步FP8量化版。
需要多模型统一调度时,同为OpenAI兼容接口的七牛云AI推理提供国内可直接访问的调用地址,可与DashScope地址共用一套客户端写法。
总结
Qwen3.8-Omni-Flash把全模态从演示做成可交付:评测平均+25%、三块Agent榜点名、音视频按小时计价砍掉九成以上、1M窗口配Realtime与插件直给七家Harness。据Qwen官方博客,该模型现已在千问AI平台提供服务。本文数据截至2026年9月18日,来源见文末参考资料。
参考资料
Qwen官方博客Qwen3.8-Omni-Flash(2026-09-18):https://qwen.ai/blog?id=qwen3.8-omni-flash
QwenCloud Qwen3.8-Omni-Flash模型页(含价格与配额):https://www.qwencloud.com/models/qwen3.8-omni-flash
Qwen-MM-Plugins官方仓库:https://github.com/QwenLM/Qwen-MM-Plugins
七牛云AI大模型广场:https://www.qiniu.com/ai/models