刚刚!Grok 4.7发布:编码与知识工作旗舰模型解析,价格不变性能翻倍
发布日期:2026-09-22
Grok 4.7是xAI于2026年9月21日正式发布的旗舰大模型,官方定位为编码与知识工作场景的最强模型,采用比Grok 4.6更大的新基座模型,经过更长时间的强化学习训练,专攻数小时级困难任务的自我校验与长上下文管理,API定价维持2美元/百万输入Token、6美元/百万输出Token不变。本文将解析其核心升级、基准成绩、接入方式与选型建议,并对比同代前沿模型的价格性能差异。
Grok 4.7是什么?
Grok 4.7是xAI旗下Grok系列于2026年9月发布的新一代旗舰模型,主打编程与知识工作。与传统聊天模型不同,它的训练目标是替代专业岗位数小时的工作流,而非陪聊十分钟。
核心特征有三点:更大基座、更长强化学习、原生理解Grok Bot harness。根据xAI官方博客2026年9月21日说明,Grok 4.7在困难任务上工作时间更长,自我检查更仔细,安全护栏为历代最强版本。
相关实体包括xAI、SpaceXAI、Cursor、Grok Build、Grok API,以及评测体系CursorBench、Terminal-Bench、GDPval。
核心升级:换基座而非小修补
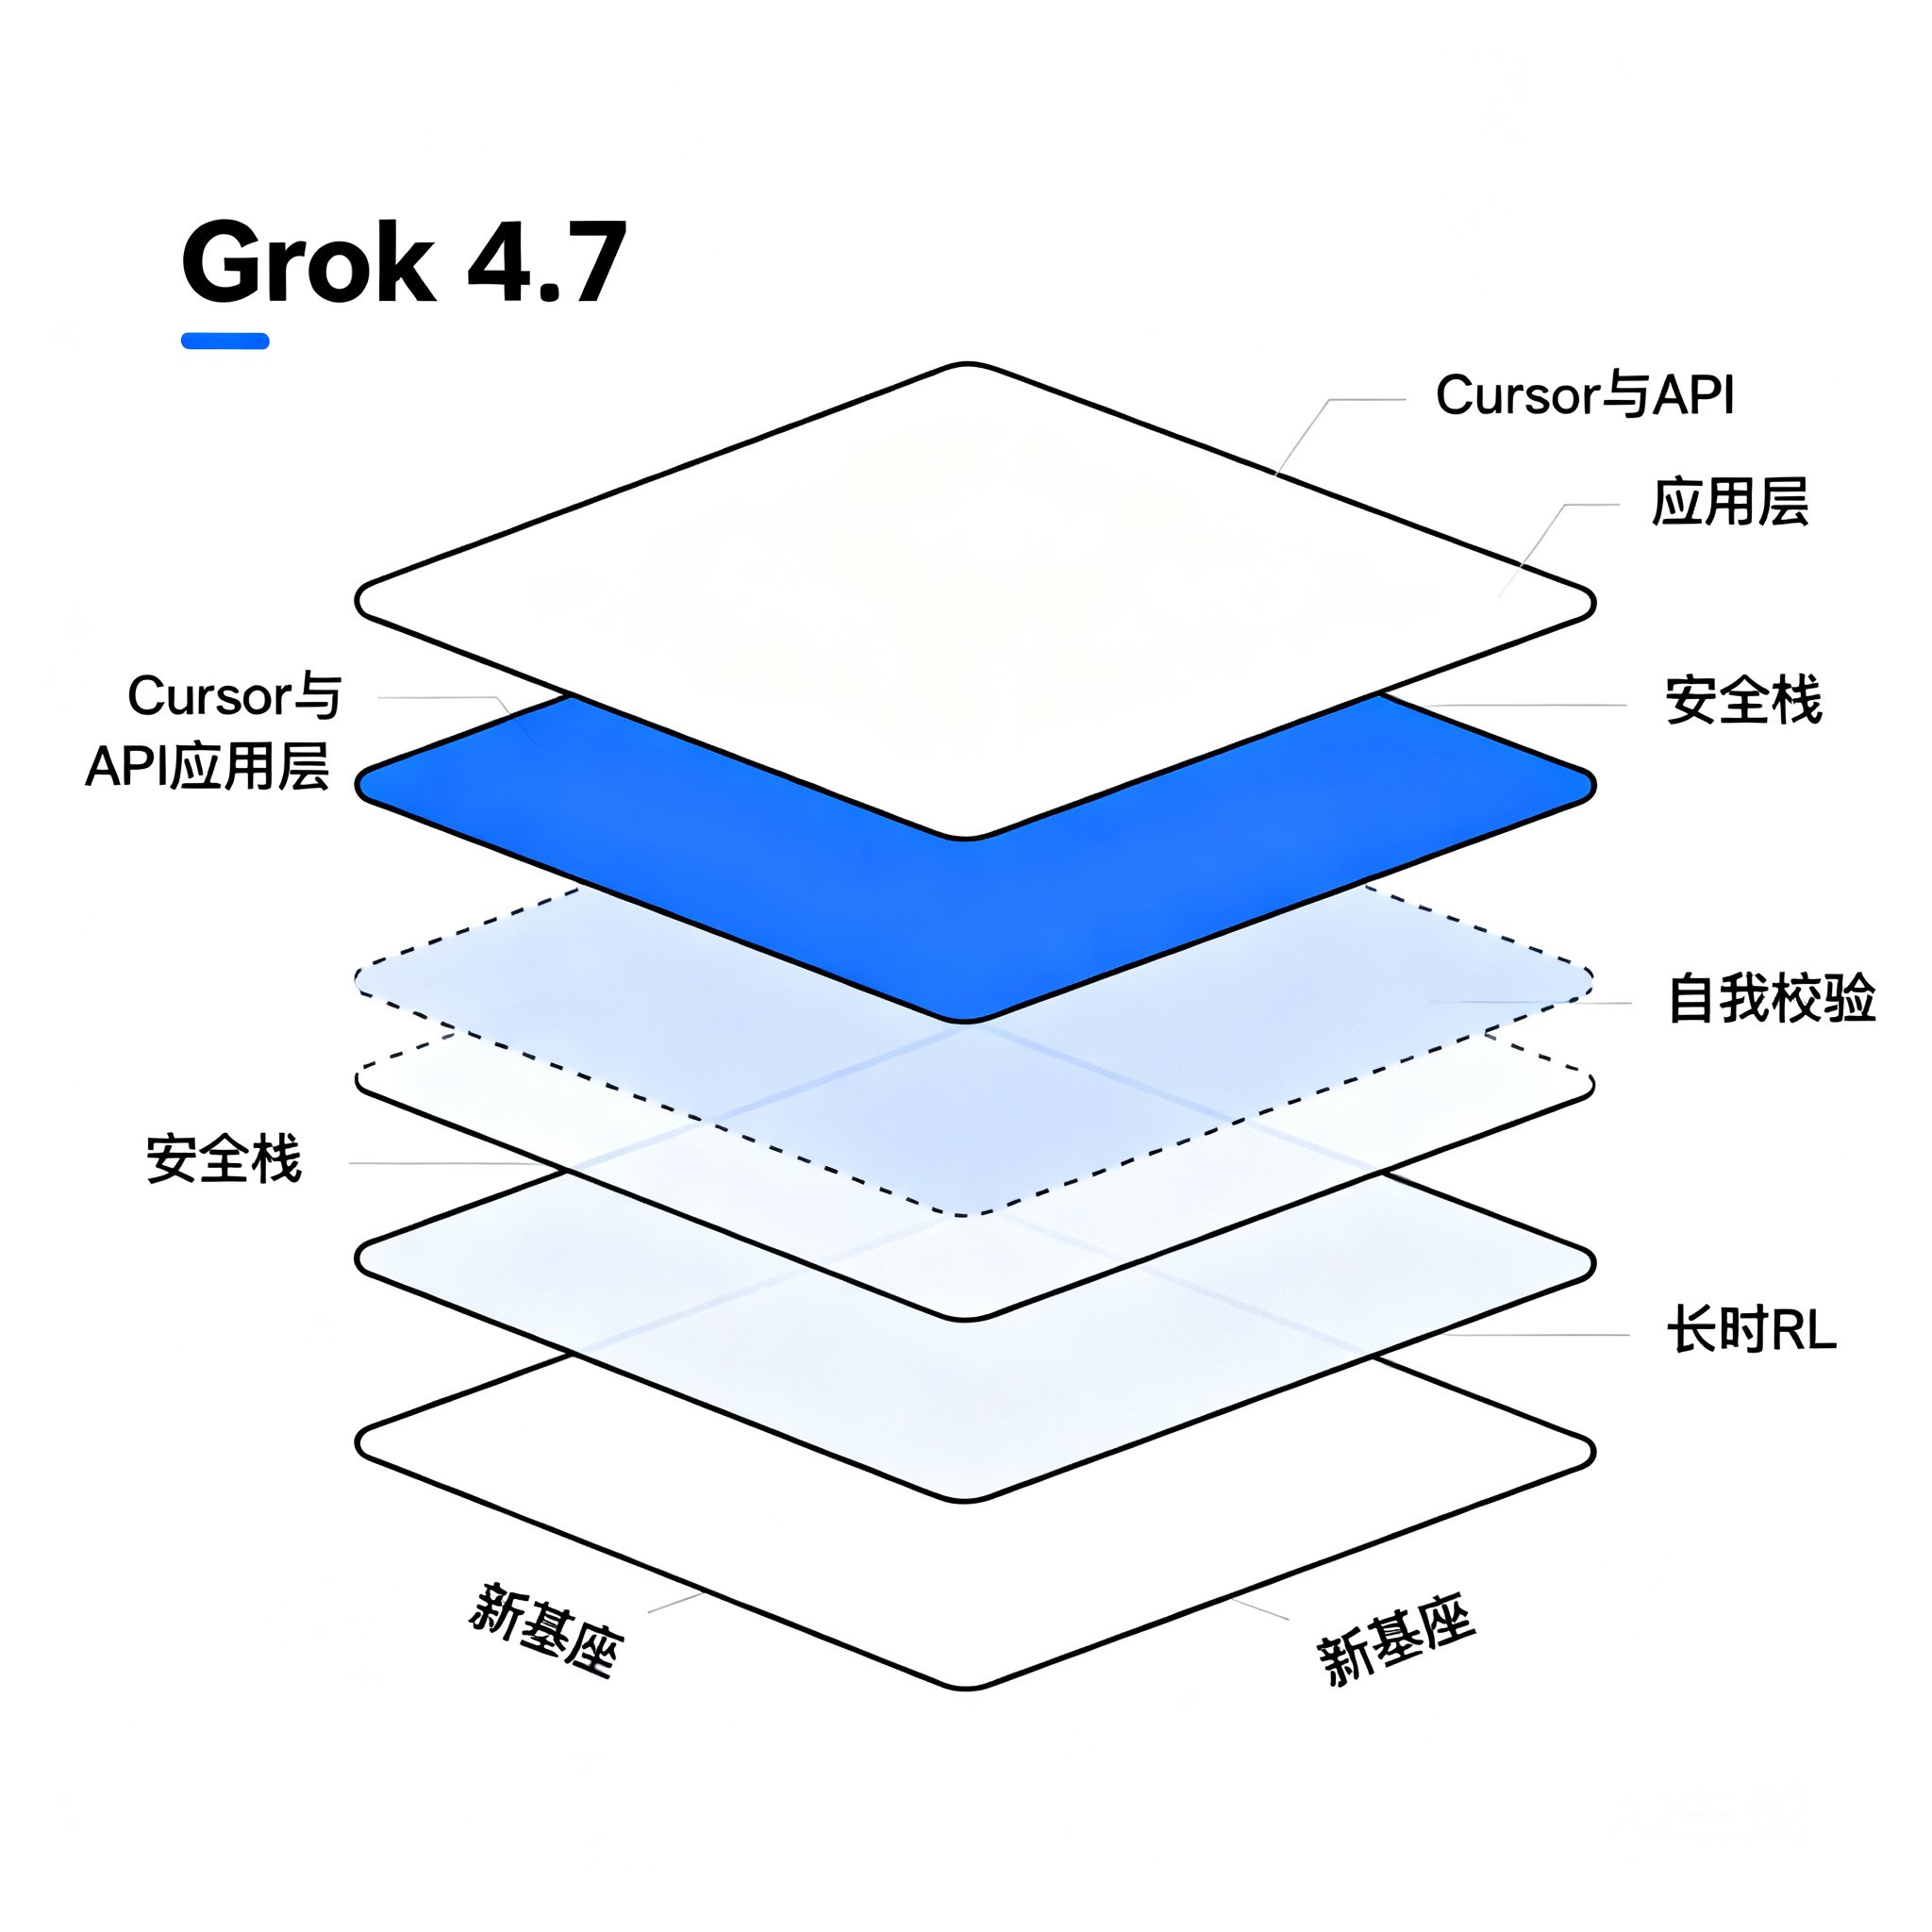
Grok 4.7版本号只跳了0.1,但实际是一次换基座升级,这是理解本次发布的关键。
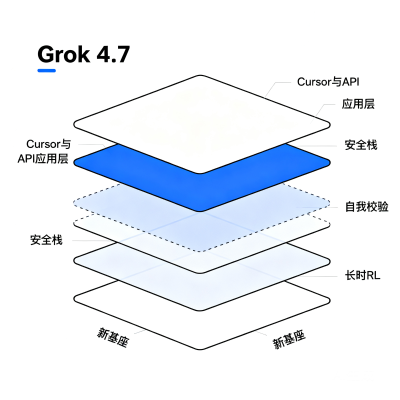
新基座模型:比Grok 4.6更大的基础模型重新出发,而非在4.6上继续后训练。
更难的RL配比:强化学习阶段加权数小时级难题,权重向长链条工程任务倾斜。
自我校验增强:模型被显式训练验证自己的工作,管理更长上下文。
Harness原生理解:原生理解Grok Bot harness,对话与通用知识任务更顺滑。
根据中文媒体2026年9月报道,Grok 4.7参数规模达2.1万亿,较Grok 4.6的1.5万亿增长约40%[数据待核实:该数字来自百度百科与百家号2026年9月词条,xAI官方博客未披露参数量]。
基准成绩:长任务提升最大
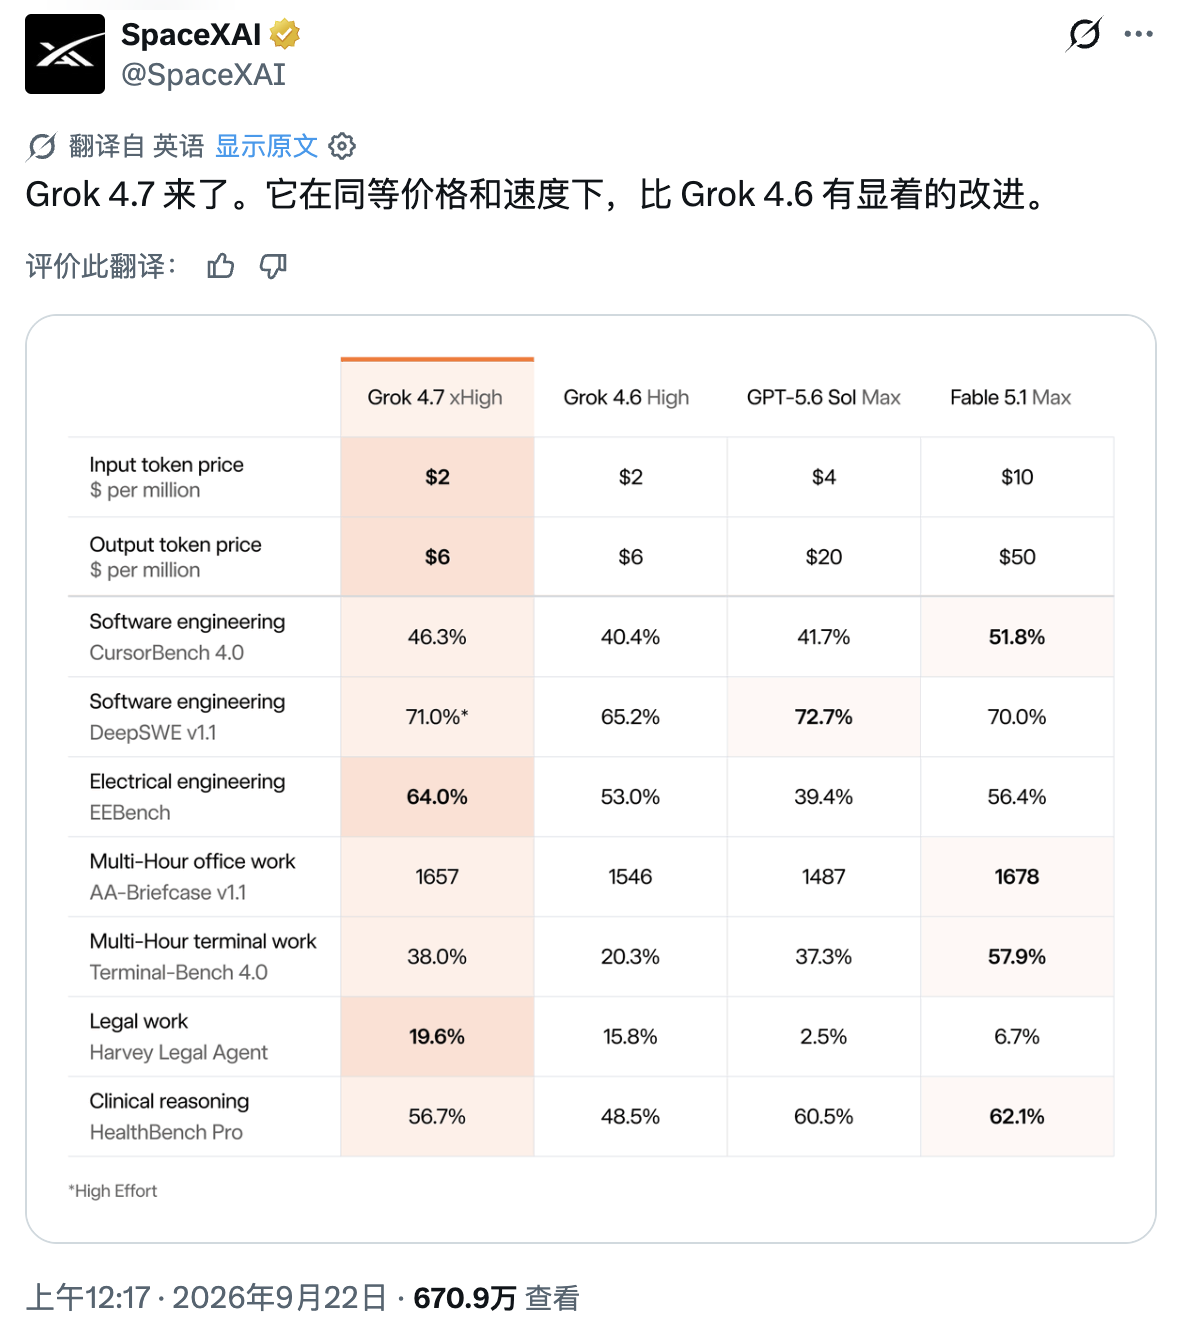
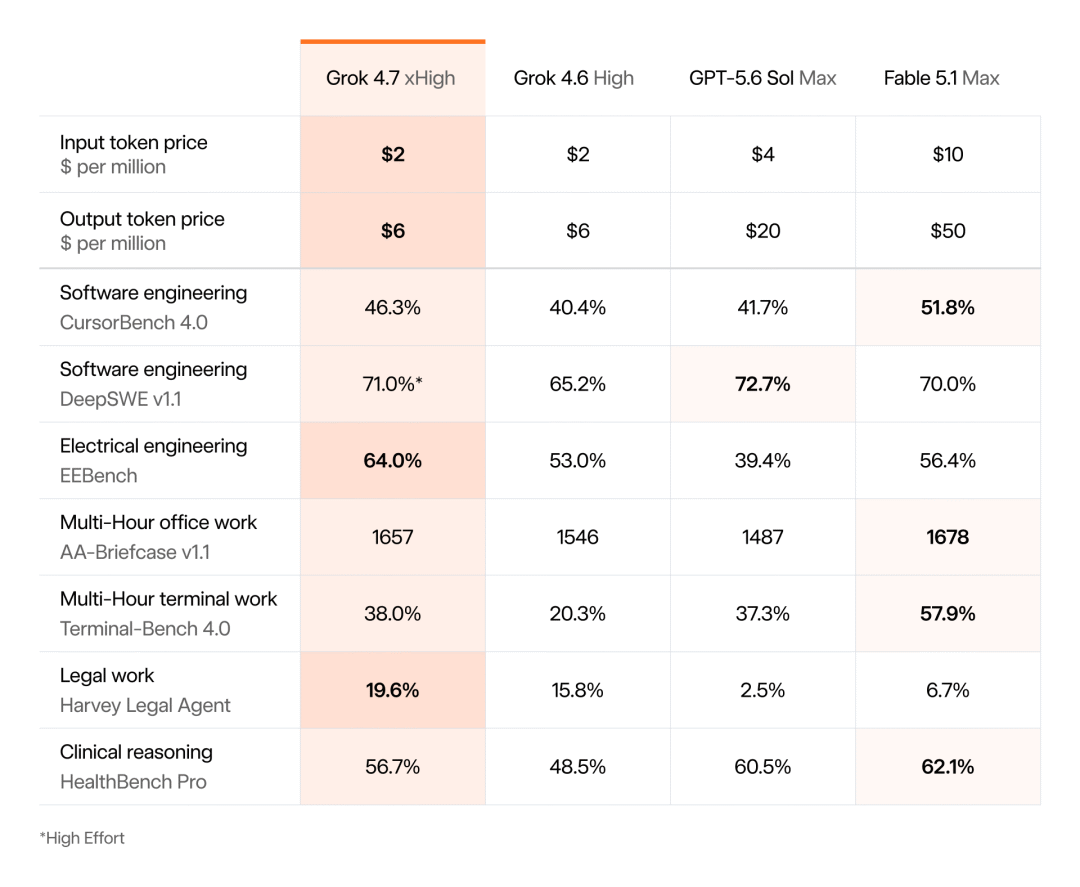
Grok 4.7官方公布了7项以上基准对比,涨幅最大的两项都是长链条工程任务。
*DeepSWE为high effort档成绩。数据来源:xAI官方博客,2026年9月。
在价格性能图上,Grok 4.7在CursorBench 4.0上处于前沿的价格性能线:以约一半成本达到接近顶级模型的分数。
知识工作侧,GDPval Elo得分1695,超过Grok 4.6的1605,仅次于Fable 5.1 Max的1735。官方称文档与演示文稿生成能力显著提升,覆盖律师、护士、金融分析师等职业任务。
安全与护栏:历代最强
Grok 4.7采用了全新的安全栈设计,这是官方强调的第二条主线。
LatchBio生物安全基准62.4%,在双用途领域兼顾有用性与拒答准确性。
HackerBench v0.3上仅放行3.3%的高风险双用途提示,同时很少误拦合法安全工作。
已向部分网络安全合作伙伴开放红队能力的受邀访问,用于防御研究。
据xAI表示,该版本在拒答与越狱抵抗测试中为内部历史最强。
价格与可用性:同价同速
Grok 4.7定价与Grok 4.6完全一致,是本次发布最具竞争力的部分。
输入2美元/百万Token,输出6美元/百万Token。
另提供fast变体:输出速度翻倍,价格翻倍。
上线入口:Cursor、Grok Build、Grok API、第三方coding harness与模型路由平台。
对比来看,Fable 5.1 Max输入10美元、输出50美元,GPT-5.6 Sol输入4美元、输出20美元。Grok 4.7约为竞品的1/2至1/5。
开发者可以通过标准OpenAI兼容接口接入,例如七牛云推理服务兼容该接口格式,无需修改现有代码即可切换模型做对比测试。
接入示例:
curl -fsSL https://x.ai/cli/install.sh | bashfrom openai import OpenAI
client = OpenAI(
base_url="https://api.x.ai/v1",
api_key="YOUR_XAI_KEY"
)
resp = client.chat.completions.create(
model="grok-4.7",
messages=[{"role": "user", "content": "用Python实现一个带重试的终端任务Agent"}]
)
print(resp.choices[0].message.content)路径与Key均为占位符,实际以xAI官方文档为准。
Grok 4.7适合什么场景?
长时编码任务:CursorBench与Terminal-Bench涨幅最大,适合多步骤重构、仓库级改动。
知识工作文档:AA Briefcase与GDPval证明其多小时办公任务能力,适合法律、财务、临床推理初稿。
成本敏感团队:同价升级,适合把4.6直接替换为4.7,无需改预算。
不适合:对绝对最高分有执念的场景,Fable 5.1 Max在CursorBench仍领先约5个百分点。
独立评测Artificial Analysis智能指数v4.3.2也提示,Grok系列在综合指数上仍有追赶空间,选型时建议以自身任务实测为准。
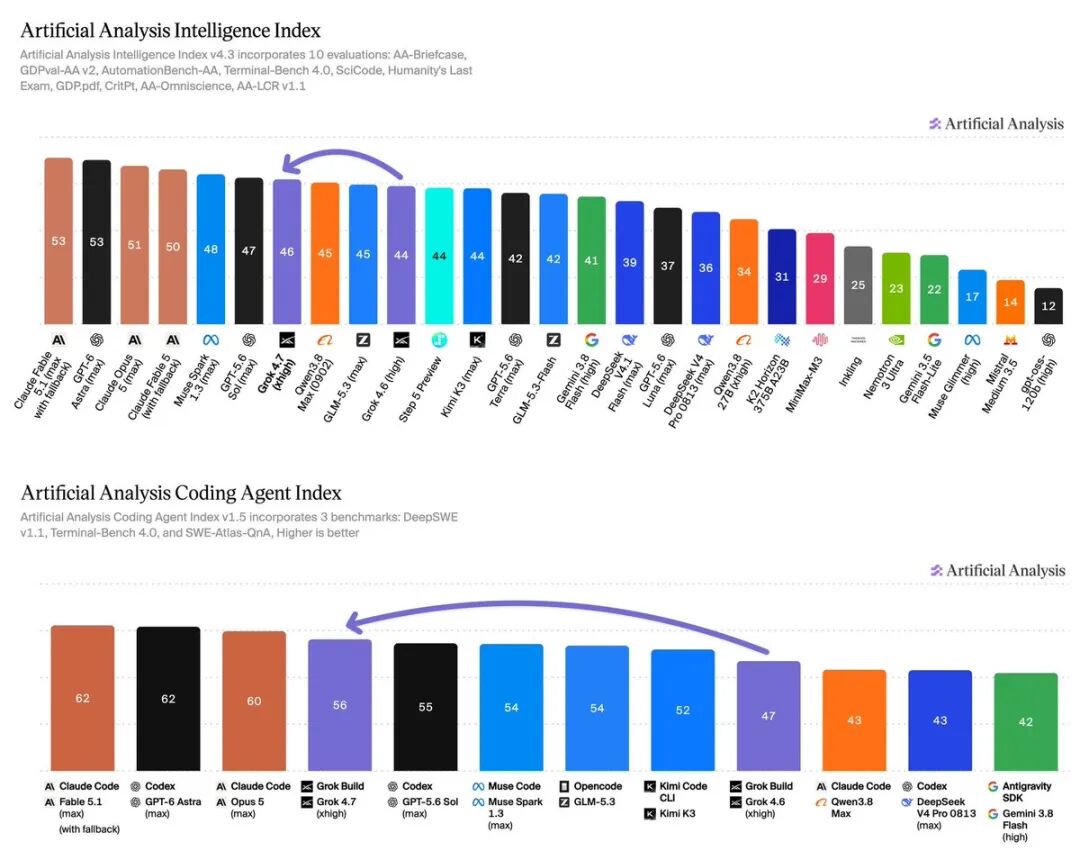
常见问题
Q:Grok 4.7和Grok 4.6最大区别是什么? Grok 4.7换了更大的基座模型并延长了困难任务强化学习,Terminal-Bench从20.3%升至38.0%,AA Briefcase从1546升至1657,价格与速度与4.6相同。
Q:Grok 4.7多少钱?怎么接入? 官方定价输入2美元/百万Token、输出6美元/百万Token,可通过Cursor、Grok Build、Grok API及兼容路由接入,fast变体为双倍速度双倍价格。
Q:Grok 4.7适合替代Claude或GPT做编程吗? 在长时编码上已接近第一梯队,且价格仅为竞品1/2至1/5,适合成本敏感的仓库级任务。追求极限分数的团队建议同时实测Fable与GPT-5.6后再决定。
Q:2.1万亿参数属实吗? 该数字来自中文百科与自媒体2026年9月词条,xAI官方未公布参数量,引用时建议标注来源并以官方模型卡为准。
Q:国内开发者如何低成本对比测试? 可用国内可直接访问的多模型API平台做同题对比,一次接入切换多个模型,避免逐个注册海外Key。
总结
Grok 4.7是一次同价升级:更大基座、更长RL、更强自我校验,在终端任务与办公任务上提升最为显著,定价维持2美元/6美元。据xAI官方博客与模型卡,2026年9月数据,其价格性能比已处前沿区间。本文内容基于2026年9月数据,模型版本与价格可能调整,建议以官方文档为准。
参考资料:
xAI官方博客 Introducing Grok 4.7:https://x.ai/news/grok-4-7
七牛云AI大模型广场:https://www.qiniu.com/ai/models