Opus 5.5发布:性能对标Fable 5.1,成本直降40%的旗舰模型解析
发布日期:2026-09-23
Claude Opus 5.5是Anthropic于2026年9月22日正式发布的Claude 5.5家族首款模型,官方定位为新一代旗舰:在多数工作负载上达到Claude Fable 5.1的水平,典型任务成本较Opus 5降低约40%。它在智能体编码、知识工作和计算机使用三项能力上全面超越Opus 5,API定价为输入4美元/百万Token、输出20美元/百万Token。本文将解析其核心升级、基准成绩、价格策略与选型建议。
Opus 5.5是什么?
Claude Opus 5.5是Anthropic Claude产品线中Opus档的新一代模型,仍是三档中能力最强、价格最高的一档,Sonnet面向均衡场景。5.5系列的首发意味着Opus、Sonnet、Haiku将陆续换代。
与前代不同,Opus 5.5的优化目标是效率而非单纯堆分:用更少算力、更少Token完成同等质量任务。根据Anthropic官方博客2026年9月22日说明,默认档即可比Opus 5最高档更强,输出速度提升30%以上。
相关实体包括Anthropic、Claude Code、AWS、Google Cloud、Microsoft Azure,以及评测体系Terminal-Bench、FrontierCode、GDPval。
核心升级:三项能力一次对齐
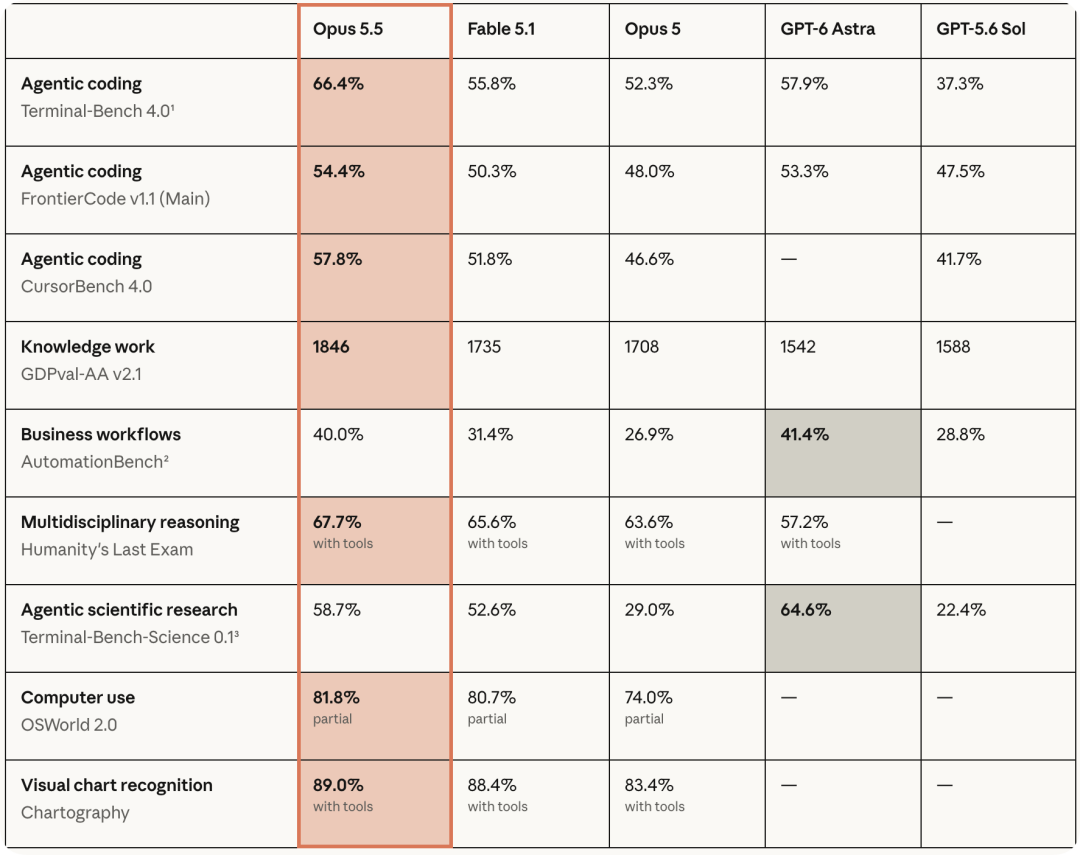
Opus 5.5在智能体编码、知识工作、计算机使用三项同时超过Opus 5和Fable 5.1,这是官方强调的一次对齐。
智能体编码领先:Terminal-Bench 4.0达66.4%,超过Fable 5.1的55.8%和GPT-6 Astra的57.9%。
知识工作断层:GDPval-AA v2.1达1846 Elo,超过Fable的1735和Opus 5的1708。
计算机使用:OSWorld 2.0达81.8%,Chartography达89.0%,均为同期最高。
沟通方式优化:针对Opus 5输出冗长难追踪的反馈,5.5把最重要的信息放前面,写作更清晰。
早期测试者案例最具说服力:一位测试者一天内完成68万行代码迁移,另一位用不到3小时审计修复20万行代码库,而Opus 5用了20小时且多耗2.5倍Token。
基准成绩:编码与业务双线强
Anthropic公布了9项完整基准,Opus 5.5在7项上领先。
数据来源:Anthropic官方博客,2026年9月,均为max effort档,Terminal-Bench-Science等误差±2.6-5分。
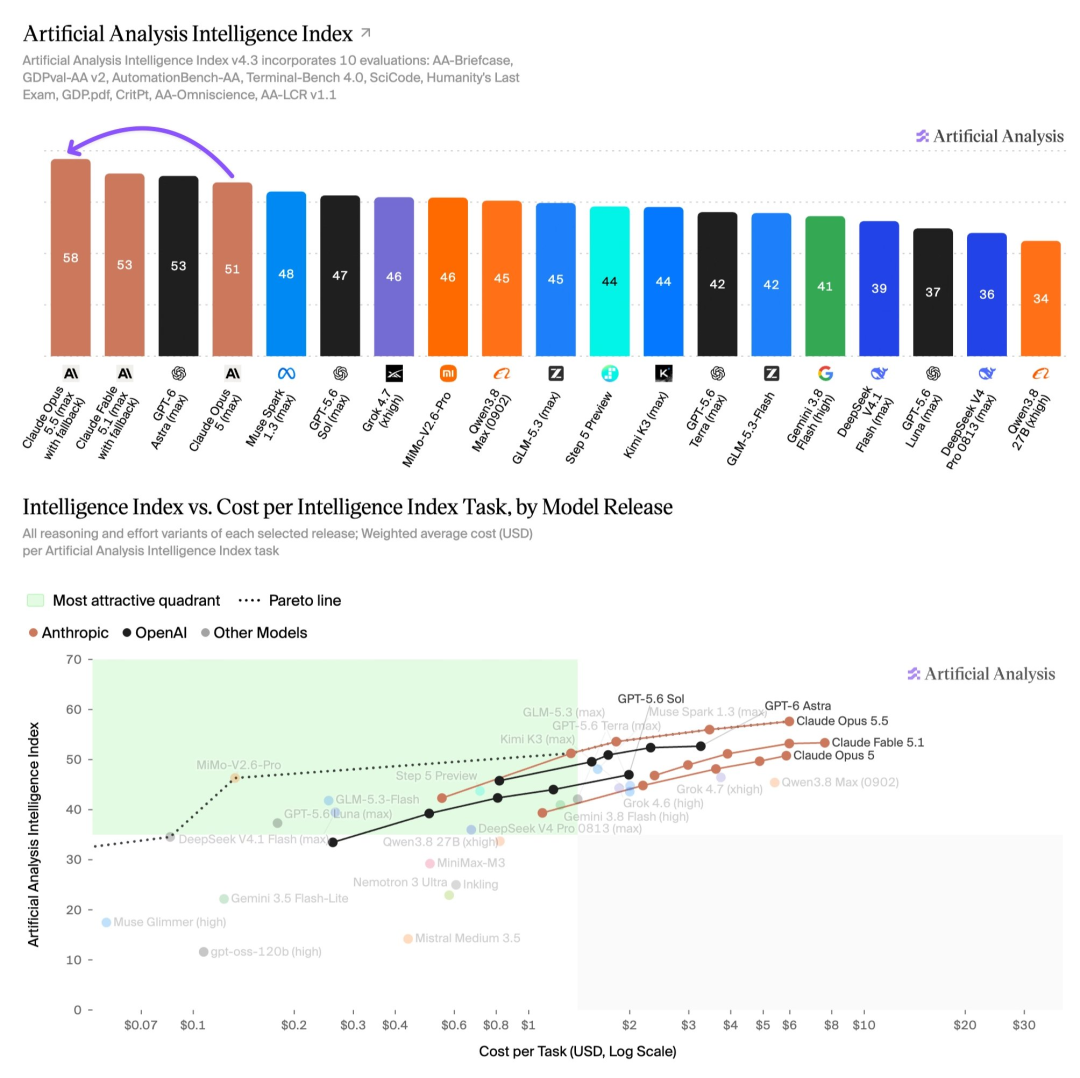
在成本曲线上,Opus 5.5默认档打败GPT-6 Astra最高档仅需约20%成本,在CursorBench上超GPT-5.6 Sol 11分仅需约1/3成本。HAProxy C转Rust实测中,Opus 5.5用9.5小时完成,Fable用12小时,成本低51%。
价格策略:降价20%,任务省40%
Opus 5.5价格是本次发布最直接的信息,Token降价叠加Token省量,双重省钱。
输入4美元/百万Token,较Opus 5的5美元降20%。
输出20美元/百万Token,较25美元降20%。
缓存读取0.2美元/百万Token,较0.5美元降60%,这正是Agent编码的主要成本项。
Fast模式2.5倍速,输入8美元、输出40美元。
Pro、Max、Team及企业版5小时用量上限同步上调,并附赠一次限速重置。
Anthropic称典型工作负载总成本降40%,实测中合并财务模型任务耗时63分钟对93分钟,成本省50%。
开发者可通过标准兼容接口在多云平台调用,例如七牛云推理服务兼容主流调用格式,国内可直接访问,便于做多模型同题对比。
调用示例:
from anthropic import Anthropic
client = Anthropic(api_key="YOUR_KEY")
msg = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "审计这个仓库的加载耗时并给出39/40页面的修复方案"}]
)
print(msg.content)
模型名与Key为占位符,以Anthropic官方文档为准。
安全与护栏:历代最强对齐
Opus 5.5是Anthropic内部自动化行为审计史上得分最高的模型,测试覆盖近2000个场景。
越狱与边界突破尝试比较Opus 5降低约85%,且均为低严重自报。
Gray Swan提示注入测试中与Fable并列最低成功率。
沿用Fable级网络与生物 safeguards,大部分攻防任务透明回退到Opus 4.8。
上线preserved thinking防蒸馏、零数据留存选项与欧盟AI法案水印。
系统卡还记录了一种自发性提示注入现象,即模型自己产出恶意指令,Anthropic认为部分源自防注入训练本身,需持续跟踪。
Opus 5.5适合什么场景?
仓库级迁移审计:长 sprawling任务优势最大,适合68万行级迁移。
金融法律研究:16/18份报告一次达标,无虚构数字,引用召回最佳。
成本敏感Agent:缓存读取降60%,适合高频调用的Coding Agent。
不适合:需关闭思考模式的场景,5.5已强制开启思考;强生物/网络攻防需申请验证项目。
已上线Claude、AWS、GCP、Azure,Sonnet 5.5与Haiku 5.5将在数周内跟进。
常见问题
Q:Opus 5.5和Opus 5最大区别是什么? 性能达Fable 5.1水平,Terminal-Bench从52.3%升至66.4%,GDPval从1708升至1846,典型成本降40%,沟通更简洁。
Q:Opus 5.5多少钱?怎么接入? 输入4美元、输出20美元/百万Token,缓存读0.2美元,已上线Claude及AWS、GCP、Azure,模型ID为claude-opus-5-5。
Q:Opus 5.5适合替代GPT-6 Astra做编程吗? FrontierCode默认档54.4%超Astra最高53.3%且仅约20%成本,Terminal匹配Astra约40%成本,适合成本敏感团队,建议以自身仓库实测为准。
Q:一天迁移68万行可信吗? 来自Anthropic官方披露的早期测试者案例,属个案上限,GitHub、Spotify、Optiver等均报告步骤减半、Token减半,可作选型参考而非承诺。
Q:国内如何低成本对比测试? 可用国内可直接访问的多模型平台做同题对比,一次接入切换多个模型,避免逐个注册。
总结
Opus 5.5是一次加量降价:对标Fable的性能,Opus 5七折的成本,在终端编码与知识工作上全面领先。据Anthropic官方博客与系统卡,2026年9月数据,其效率优势比分数优势更显著。本文内容基于2026年9月数据,价格与可用区可能调整,建议以官方定价页为准。
参考资料:
Anthropic官方博客 Claude Opus 5.5:https://www.anthropic.com/news/claude-opus-5-5
Anthropic Opus 5.5系统卡:https://anthropic.com/claude-opus-5-5-system-card
多模型API对比测试:https://www.qiniu.com/ai/models