MiMo V2.6 部署完整指南:Pro-RL 模型下载、SGLang/vLLM 多卡推理与排错
发布日期:2026-09-23 资料核验:2026-09-23
截至 2026 年 9 月 23 日,Xiaomi MiMo 官方 Hugging Face 模型卡已公开 MiMo-V2.6-Pro-RL 权重与部署命令:这是一个总参数约 1.02T、每个 Token 激活 42B 参数、支持文本/图片/视频/音频和 100 万 Token 上下文的稀疏 MoE 模型。它的官方高性能路径是 SGLang 多节点或 vLLM 多卡服务,不能把模型卡里的 vllm serve 命令误解为普通单卡部署方案。本文从权重下载、显存与并行度判断,到 SGLang、vLLM 启动、OpenAI 兼容接口、工具调用和常见故障,给出一套可复现的部署流程。
先判断:这是不是适合单机单卡的模型
MiMo-V2.6-Pro-RL 的官方模型卡将它定义为 MiMo-V2.6 系列的旗舰 checkpoint,架构为稀疏 MoE,总参数 1.02T、激活参数 42B,最大上下文为 1M Token。
模型卡元数据还显示,该仓库使用 Transformers 架构映射和 FP8 量化配置,并包含大量分片权重。仅按总参数规模估算会低估部署复杂度,因为运行时还要为激活参数、KV Cache、视觉/音频编码器、通信缓冲区和框架预留空间。
因此,部署前应先接受三个结论:
普通 24GB 或 48GB 单卡不在官方 Pro-RL 部署路径内。 官方没有给出单卡启动命令,也没有承诺把完整 Pro checkpoint 压缩到消费级显卡即可运行。
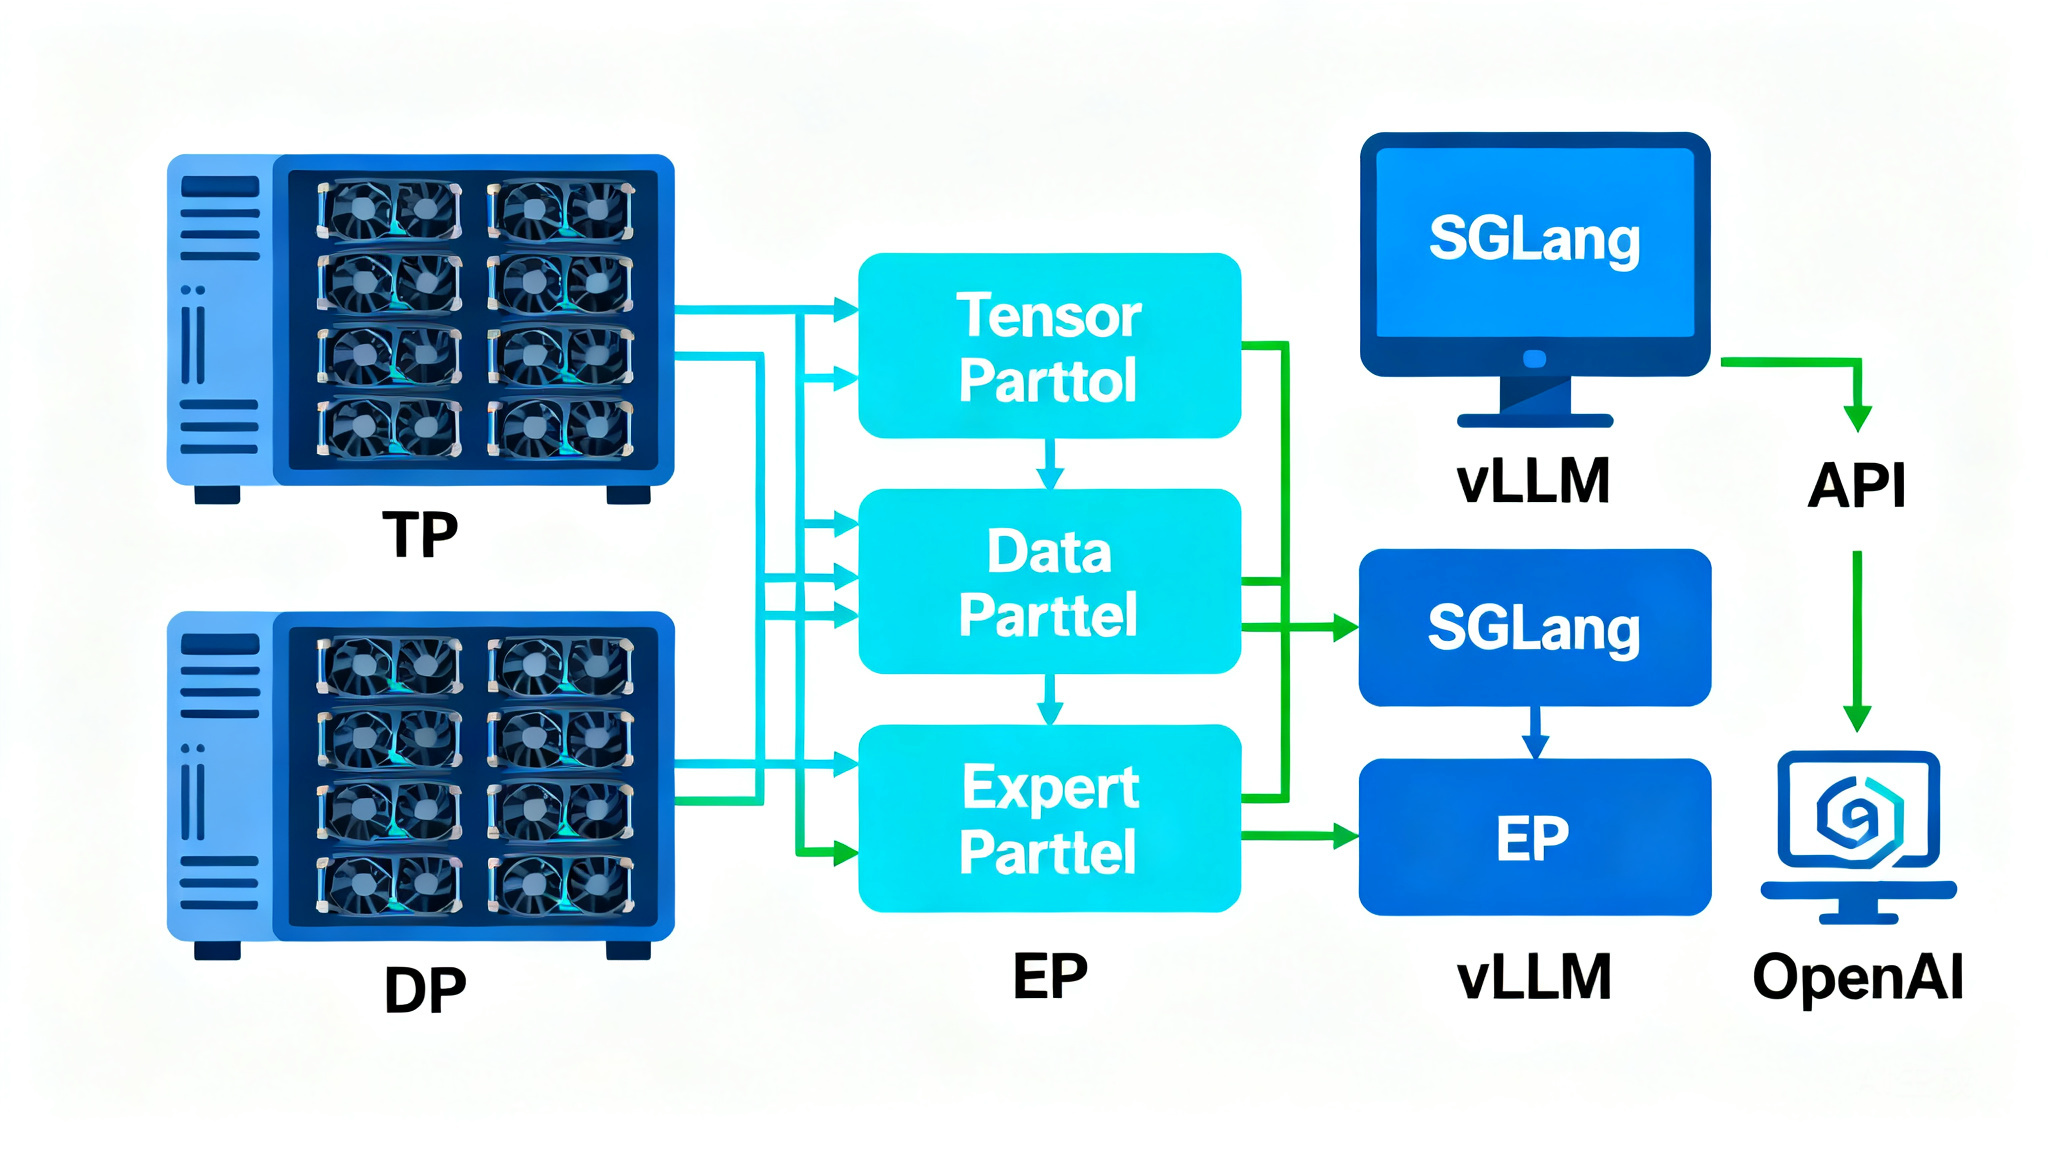
官方示例是多卡并行。 SGLang 示例使用
--tp 16、--dp 2、--nnodes 2;vLLM 示例使用--tensor-parallel-size 8,两者代表不同的并行和硬件假设。Pro-RL 与 Flash-RL 不是同一个权重。 如果目标是降低部署门槛,应另行评估官方发布的
MiMo-V2.6-Flash-RL,不要把 Flash 的资源需求套到 Pro 上。
1. 环境准备与权重下载
官方模型卡列出的基础工具是 Transformers、SGLang 和 vLLM;部署框架版本、CUDA、驱动和通信库必须以目标集群的兼容矩阵为准。
1.1 检查 GPU、驱动和磁盘
先记录 GPU 数量、显存、驱动和 CUDA:
nvidia-smi
python - <<'PY'
import torch

print("torch:", torch.__version__)
print("cuda:", torch.version.cuda)
print("gpu_count:", torch.cuda.device_count())
for i in range(torch.cuda.device_count()):
    p = torch.cuda.get_device_properties(i)
    print(i, p.name, round(p.total_memory / 1024**3, 1), "GiB")
PY
权重仓库包含大量 safetensors 分片、视觉和音频组件,以及技术报告文件。下载前应预留明显高于单纯模型参数换算值的本地空间,并把 Hugging Face 缓存目录放到高速本地盘或共享文件系统。
1.2 使用 Hugging Face CLI 下载
推荐先登录 Hugging Face,再下载到固定目录;不要把访问令牌写进脚本或文章。
python -m pip install -U "huggingface_hub[cli]"
huggingface-cli login
export HF_HOME=/data/huggingface

huggingface-cli download XiaomiMiMo/MiMo-V2.6-Pro-RL \
  --local-dir /data/models/MiMo-V2.6-Pro-RL
模型卡同时提供 ModelScope 下载入口。如果集群无法稳定访问 Hugging Face,可以使用官方模型卡列出的 ModelScope 镜像,但要保持目录内容和配置文件完整,不要只下载少量权重分片。
下载完成后至少检查这些文件是否存在:
test -f /data/models/MiMo-V2.6-Pro-RL/config.json
test -f /data/models/MiMo-V2.6-Pro-RL/tokenizer.json
test -f /data/models/MiMo-V2.6-Pro-RL/model.safetensors.index.json
test -f /data/models/MiMo-V2.6-Pro-RL/modeling_mimo_v2.py
test -f /data/models/MiMo-V2.6-Pro-RL/preprocessor_config.json
config.json 和 modeling_mimo_v2.py 用于识别 MiMo 自定义架构;启动时需要显式打开 --trust-remote-code,这意味着你应先审阅仓库代码并固定提交版本,再把它放进生产环境。
2. SGLang 部署:按官方多节点命令启动
MiMo-V2.6-Pro-RL 模型卡给出的高性能 SGLang 路径包含张量并行、数据并行、专家并行、DeepEP 通信和 EAGLE speculative decoding。
2.1 官方命令结构
下面的命令保留官方参数,但把 IP、节点序号和端口改成占位符。它假设两台节点通过分布式初始化地址互通,不能直接在单机复制执行。
sglang serve \
  --trust-remote-code \
  --model-path XiaomiMiMo/MiMo-V2.6-Pro-RL \
  --tp 16 \
  --dp 2 \
  --enable-dp-attention \
  --mm-enable-dp-encoder \
  --ep 16 \
  --moe-a2a-backend deepep \
  --moe-dense-tp-size 1 \
  --mem-fraction-static 0.7 \
  --max-running-requests 128 \
  --chunked-prefill-size 32768 \
  --page-size 64 \
  --swa-full-tokens-ratio 0.3 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --enable-multi-layer-eagle \
  --reasoning-parser mimo \
  --tool-call-parser mimo \
  --host 0.0.0.0 \
  --port 30000 \
  --nnodes 2 \
  --node-rank <node-rank> \
  --dist-init-addr <node0-ip>:20000
在节点 0 和节点 1 上分别替换 <node-rank> 为 0 和 1,并让两台机器使用同一模型路径、相同软件环境和可互通的 --dist-init-addr。如果你的 SGLang 版本不认识某个参数,应先对照官方 MiMo cookbook 和当前安装版本的 sglang serve --help,不要静默删除参数后直接上线。
2.2 SGLang 参数怎么调整
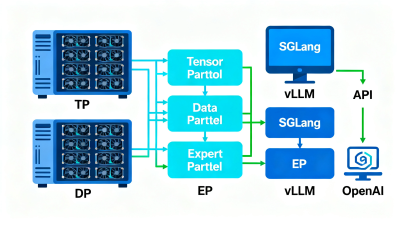
--tp控制张量并行;它必须和单节点 GPU 数、互联带宽以及框架支持方式匹配。--dp与--enable-dp-attention用于把请求负载分摊到数据并行副本。--ep、--moe-a2a-backend deepep面向 MoE 专家通信,依赖通信库和 GPU 拓扑。--mem-fraction-static 0.7是官方示例的静态显存比例,不是所有集群都适合的固定值。--speculative-*开启 EAGLE 推测解码;先完成无 speculative 的基线,再比较吞吐与稳定性。--reasoning-parser mimo和--tool-call-parser mimo让服务端按 MiMo 格式解析推理与工具调用。
如果启动阶段 OOM,优先降低并发、缩短 --max-model-len 或减少预填充批量,而不是盲目提高显存比例。1M 上下文是模型能力上限,不代表每次服务都应把上下文配置到最大。
3. vLLM 部署:先做单节点多卡基线
官方模型卡同时给出 vLLM 启动方式,适合先在一台多卡节点上建立可用基线,再扩展到更复杂的服务拓扑。
vllm serve XiaomiMiMo/MiMo-V2.6-Pro-RL \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --gpu-memory-utilization 0.95 \
  --max-model-len auto \
  --reasoning-parser mimo \
  --tool-call-parser mimo \
  --enable-auto-tool-choice \
  --generation-config vllm
模型卡给出的采样参数是 temperature=1.0、top_p=0.95。这些是推理建议,不是硬编码要求;评测、代码生成和创意任务应分别建立自己的参数基线。
3.1 用容器固定环境
模型卡列出过 vLLM 的 MiMo 预构建镜像示例。实际使用时必须根据当前 CUDA、驱动和 vLLM 版本重新核对镜像标签,不要把历史标签当成永久兼容承诺:
docker pull vllm/vllm-openai:mimov25-cu129

docker run --gpus all --ipc=host --network=host \
  -v /data/models:/models \
  vllm/vllm-openai:mimov25-cu129 \
  vllm serve /models/MiMo-V2.6-Pro-RL \
    --tensor-parallel-size 8 \
    --trust-remote-code \
    --gpu-memory-utilization 0.95 \
    --max-model-len auto \
    --reasoning-parser mimo \
    --tool-call-parser mimo \
    --enable-auto-tool-choice \
    --generation-config vllm
如果镜像内的 vLLM 不包含当前 MiMo-V2.6 支持,优先寻找 vLLM 官方 recipe 或 Xiaomi MiMo 模型卡的更新,而不是只改模型目录名。启动日志应确认模型架构被识别为 MiMoV2ForCausalLM,并确认 reasoning/tool-call parser 已加载。
4. 启动后做最小 API 验证
vLLM 和 SGLang 都可以提供 OpenAI 风格接口;先做短输入、低并发的 smoke test,再逐步打开多模态和长上下文。
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "XiaomiMiMo/MiMo-V2.6-Pro-RL",
    "messages": [
      {"role": "user", "content": "用三句话说明 MoE 的优点。"}
    ],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 256
  }'
验证时依次检查:HTTP 状态码、响应中的 model、choices[0].message.content、是否出现异常的空 thinking block,以及服务端日志是否报告显存溢出、专家通信或 tokenizer 错误。
4.1 Python 客户端
OpenAI 兼容接口可以用标准 Python 客户端访问;这里的 base_url 指向你的本地服务,不是把模型权重上传到第三方平台。
pip install -U openaifrom openai import OpenAI
client = OpenAI(
base_url="http://127.0.0.1:8000/v1",
api_key="EMPTY",
)
response = client.chat.completions.create(
model="XiaomiMiMo/MiMo-V2.6-Pro-RL",
messages=[
{"role": "user", "content": "写一个 Python 函数,返回斐波那契数列前十项。"}
],
temperature=1.0,
top_p=0.95,
max_tokens=512,
)
print(response.choices[0].message.content)5. 多模态、工具调用与上下文边界
MiMo-V2.6-Pro-RL 的模型卡声明支持文本、图片、视频和音频,但“模型支持模态”不等于每个部署后端和每个 API 入口都自动支持全部输入。
上线多模态前要验证三层:
处理器层: 模型目录中存在
preprocessor_config.json、视觉/音频相关配置和 tokenizer 模板。服务层: SGLang/vLLM 当前版本已实现 MiMo-V2.6 的多模态处理器,而不是只识别文本生成架构。
协议层: OpenAI 兼容入口接受的图片、视频或音频字段格式与客户端发送格式一致。
工具调用同样应先做小样本验证。模型卡的 SGLang 示例显式设置 --tool-call-parser mimo,vLLM 示例设置 --tool-call-parser mimo --enable-auto-tool-choice;如果工具名、参数 JSON 或停止条件解析异常,先关闭自动工具循环,保存原始响应,再定位是模板、解析器还是服务框架问题。
6. 常见故障排查
显存不足或启动后立刻退出
先确认并行度、模型路径和上下文配置,再处理显存。Pro-RL 的总参数量很大,单纯把 --gpu-memory-utilization 从 0.90 调到 0.99 不能替代足够的 GPU 数量。
找不到自定义模型类
确认模型目录包含 configuration_mimo_v2.py 和 modeling_mimo_v2.py,并在 SGLang/vLLM 命令中保留 --trust-remote-code。如果生产环境禁止远程代码执行,应先做代码审计和版本固定,再通过内部镜像加载。
多节点卡在初始化或 NCCL 错误
检查节点间端口、主机名解析、NCCL 网卡选择、GPU 数量和 CUDA/驱动版本是否一致。--dist-init-addr 必须指向节点 0 可达地址;两台机器不能使用不同的模型分片或不同 tokenizer 文件。
输出为空、乱码或只有思考内容
先用短文本和 max_tokens=256 复现,确认 tokenizer、chat template 和 reasoning parser。模型卡自带 chat template,应用不要自行拼接特殊 token;解析响应时也不要假设第一段内容一定是最终文本。
工具调用 JSON 不完整
检查 --tool-call-parser mimo 是否生效、服务框架版本是否支持当前模板,并把工具 schema 缩减为一个最小函数。先保存原始响应,再判断是模型生成、停止词还是解析器截断。
7. 一套稳妥的上线顺序
MiMo-V2.6-Pro-RL 的部署应按“可启动、可验证、再扩容”的顺序推进:
固定 Hugging Face 提交版本和模型目录校验记录。
在单节点多卡环境用 vLLM 建立短文本基线。
逐步打开 reasoning parser、tool-call parser 和自动工具选择。
用 1K、8K、32K 和更长上下文分别测显存、延迟和吞吐。
再切换 SGLang 多节点,比较专家并行和 speculative decoding 的收益。
多模态输入单独做图片、视频、音频回归,不与文本基线混在一次结论里。
上线前记录服务版本、CUDA、驱动、GPU 拓扑、模型 commit、采样参数和失败样本。
结论
MiMo-V2.6-Pro-RL 是一个面向长上下文、多模态和 Agent 任务的超大规模稀疏 MoE 模型,官方公开的可执行路径是 SGLang 多节点和 vLLM 多卡服务。部署的关键不是复制一条命令,而是根据并行度、显存、通信拓扑、模型自定义代码和多模态处理器逐层验证;普通单卡用户不应把这份 Pro-RL 权重当成轻量本地模型。
本文数据截至 2026 年 9 月 23 日,主要依据 Xiaomi MiMo 官方 Hugging Face 模型卡及其链接的 SGLang/vLLM 部署资料整理。框架参数、镜像标签和模型仓库内容可能继续更新,生产部署前应重新核对官方页面。
参考资料
Xiaomi MiMo:MiMo-V2.6-Pro-RL 模型卡:https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL
Hugging Face:MiMo-V2.6-Pro-RL API 元数据:https://huggingface.co/api/models/XiaomiMiMo/MiMo-V2.6-Pro-RL
Xiaomi MiMo 官方发布页:https://mimo.xiaomi.com/mimo-v2-6
SGLang 官方 MiMo cookbook:https://docs.sglang.io/cookbook/autoregressive/Xiaomi/MiMo-V2.5
vLLM 官方 MiMo recipe:https://recipes.vllm.ai/XiaomiMiMo/MiMo-V2.5
Transformers 官方 MiMo 文档:https://huggingface.co/docs/transformers/main/en/model_doc/mimo_v2