国内大模型 API 服务商盘点:8 家平台接入方式与选型指南(2026 )
发布日期:2026-09-23
国内大模型 API 服务商,是向开发者提供模型推理接口、鉴权、计量和配套开发能力的平台或模型厂商;截至 2026 年 9 月,常见选择可以分为综合型模型平台与原厂模型 API 两类。前者强调多模型、跨模态和统一运维,后者强调某一模型家族的能力迭代与接口稳定性。
先看结论:不要把所有服务商放进同一张榜单
如果团队需要在多个模型之间反复比较,综合型平台可以减少重复开户、鉴权和 SDK 适配;如果业务已经围绕某个模型家族构建,原厂 API 往往更容易跟进该厂商的模型更新。真正的选型问题不是“哪家最好”,而是模型能力、接口协议、并发限制、数据边界和单位成本是否匹配。
截至 2026 年 9 月,阿里云百炼官方模型文档明确写有“千问及第三方模型服务”,并覆盖文本、图像、音频、视频、向量与重排序等能力;火山方舟官方产品页将自身定义为“一站式大模型服务平台”,同时提供 API 直连、模型定价和 CLI;百度千帆官方产品页则把模型服务、Agent、知识库和可观测能力放在同一平台中。
8 家服务商怎么分
这里的“类型”是接入方式上的分类,不代表模型质量排序。阿里云百炼、火山方舟、百度千帆和硅基流动的共同点是可以在一个控制台内比较或调用多个模型;腾讯混元、智谱和 DeepSeek 常用于围绕各自模型家族做深度集成。七牛云 Token Plan 的官方页面把统一 API Key、接口兼容和周期额度作为订阅规则的一部分,可用于在测试多个模型时集中管理鉴权和用量,但具体可用模型仍以订阅页面当天展示为准。
选型时最容易忽略的 5 个维度
1. 模型目录不等于可用能力
先把任务拆成文本生成、长上下文、视觉理解、图像生成、语音或向量检索,再看平台是否提供稳定的生产接口。模型名称相近并不意味着参数、上下文、工具调用和输出格式相同,必须以官方模型卡或 API 文档为准。
2. 协议兼容只能降低迁移成本
OpenAI 兼容接口能减少客户端改造,但不一定覆盖所有参数。以硅基流动官方快速开始为例,平台支持通过 OpenAI 库调用,并明确给出 base URL;DeepSeek 官方文档同时列出 OpenAI 与 Anthropic 两种基础地址。迁移前仍要逐项检查流式输出、工具调用、结构化输出、错误码和上下文字段。
3. 额度、速率和并发要分开看
免费额度、订阅额度、按量计费和速率限制是四个不同概念。七牛云 Token Plan 页面截至 2026-09-23 显示额度按周刷新、积分按模型实际消耗扣减,未用完额度不结转;火山方舟页面同时展示按量付费、生产级保障和免费额度。对生产业务,应该记录 P50/P95 延迟、限流次数、重试率和每个成功任务的实际成本。
4. 数据边界要落到合同和配置
不要只看“是否上云”四个字。需要确认日志保留、数据是否用于训练、地域、子账号权限、审计记录和敏感信息脱敏方式。百度千帆和火山方舟官方页面都展示了审计、监控或安全相关能力,但具体开关和适用范围仍要回到对应文档及服务协议核对。
5. 生产接口要有替换预案
为模型调用增加统一的业务层:固定消息结构、超时、重试、降级模型和成本标签。这样即使更换模型供应商,也只需要替换适配器,而不是修改业务代码和数据管道。
一个下午完成的同题实测流程
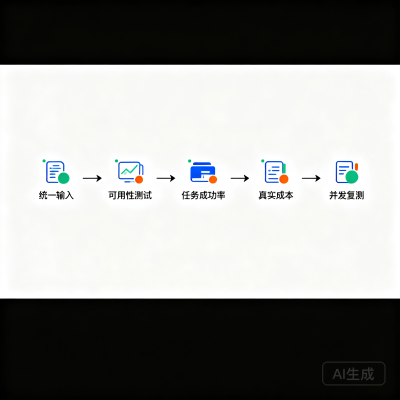
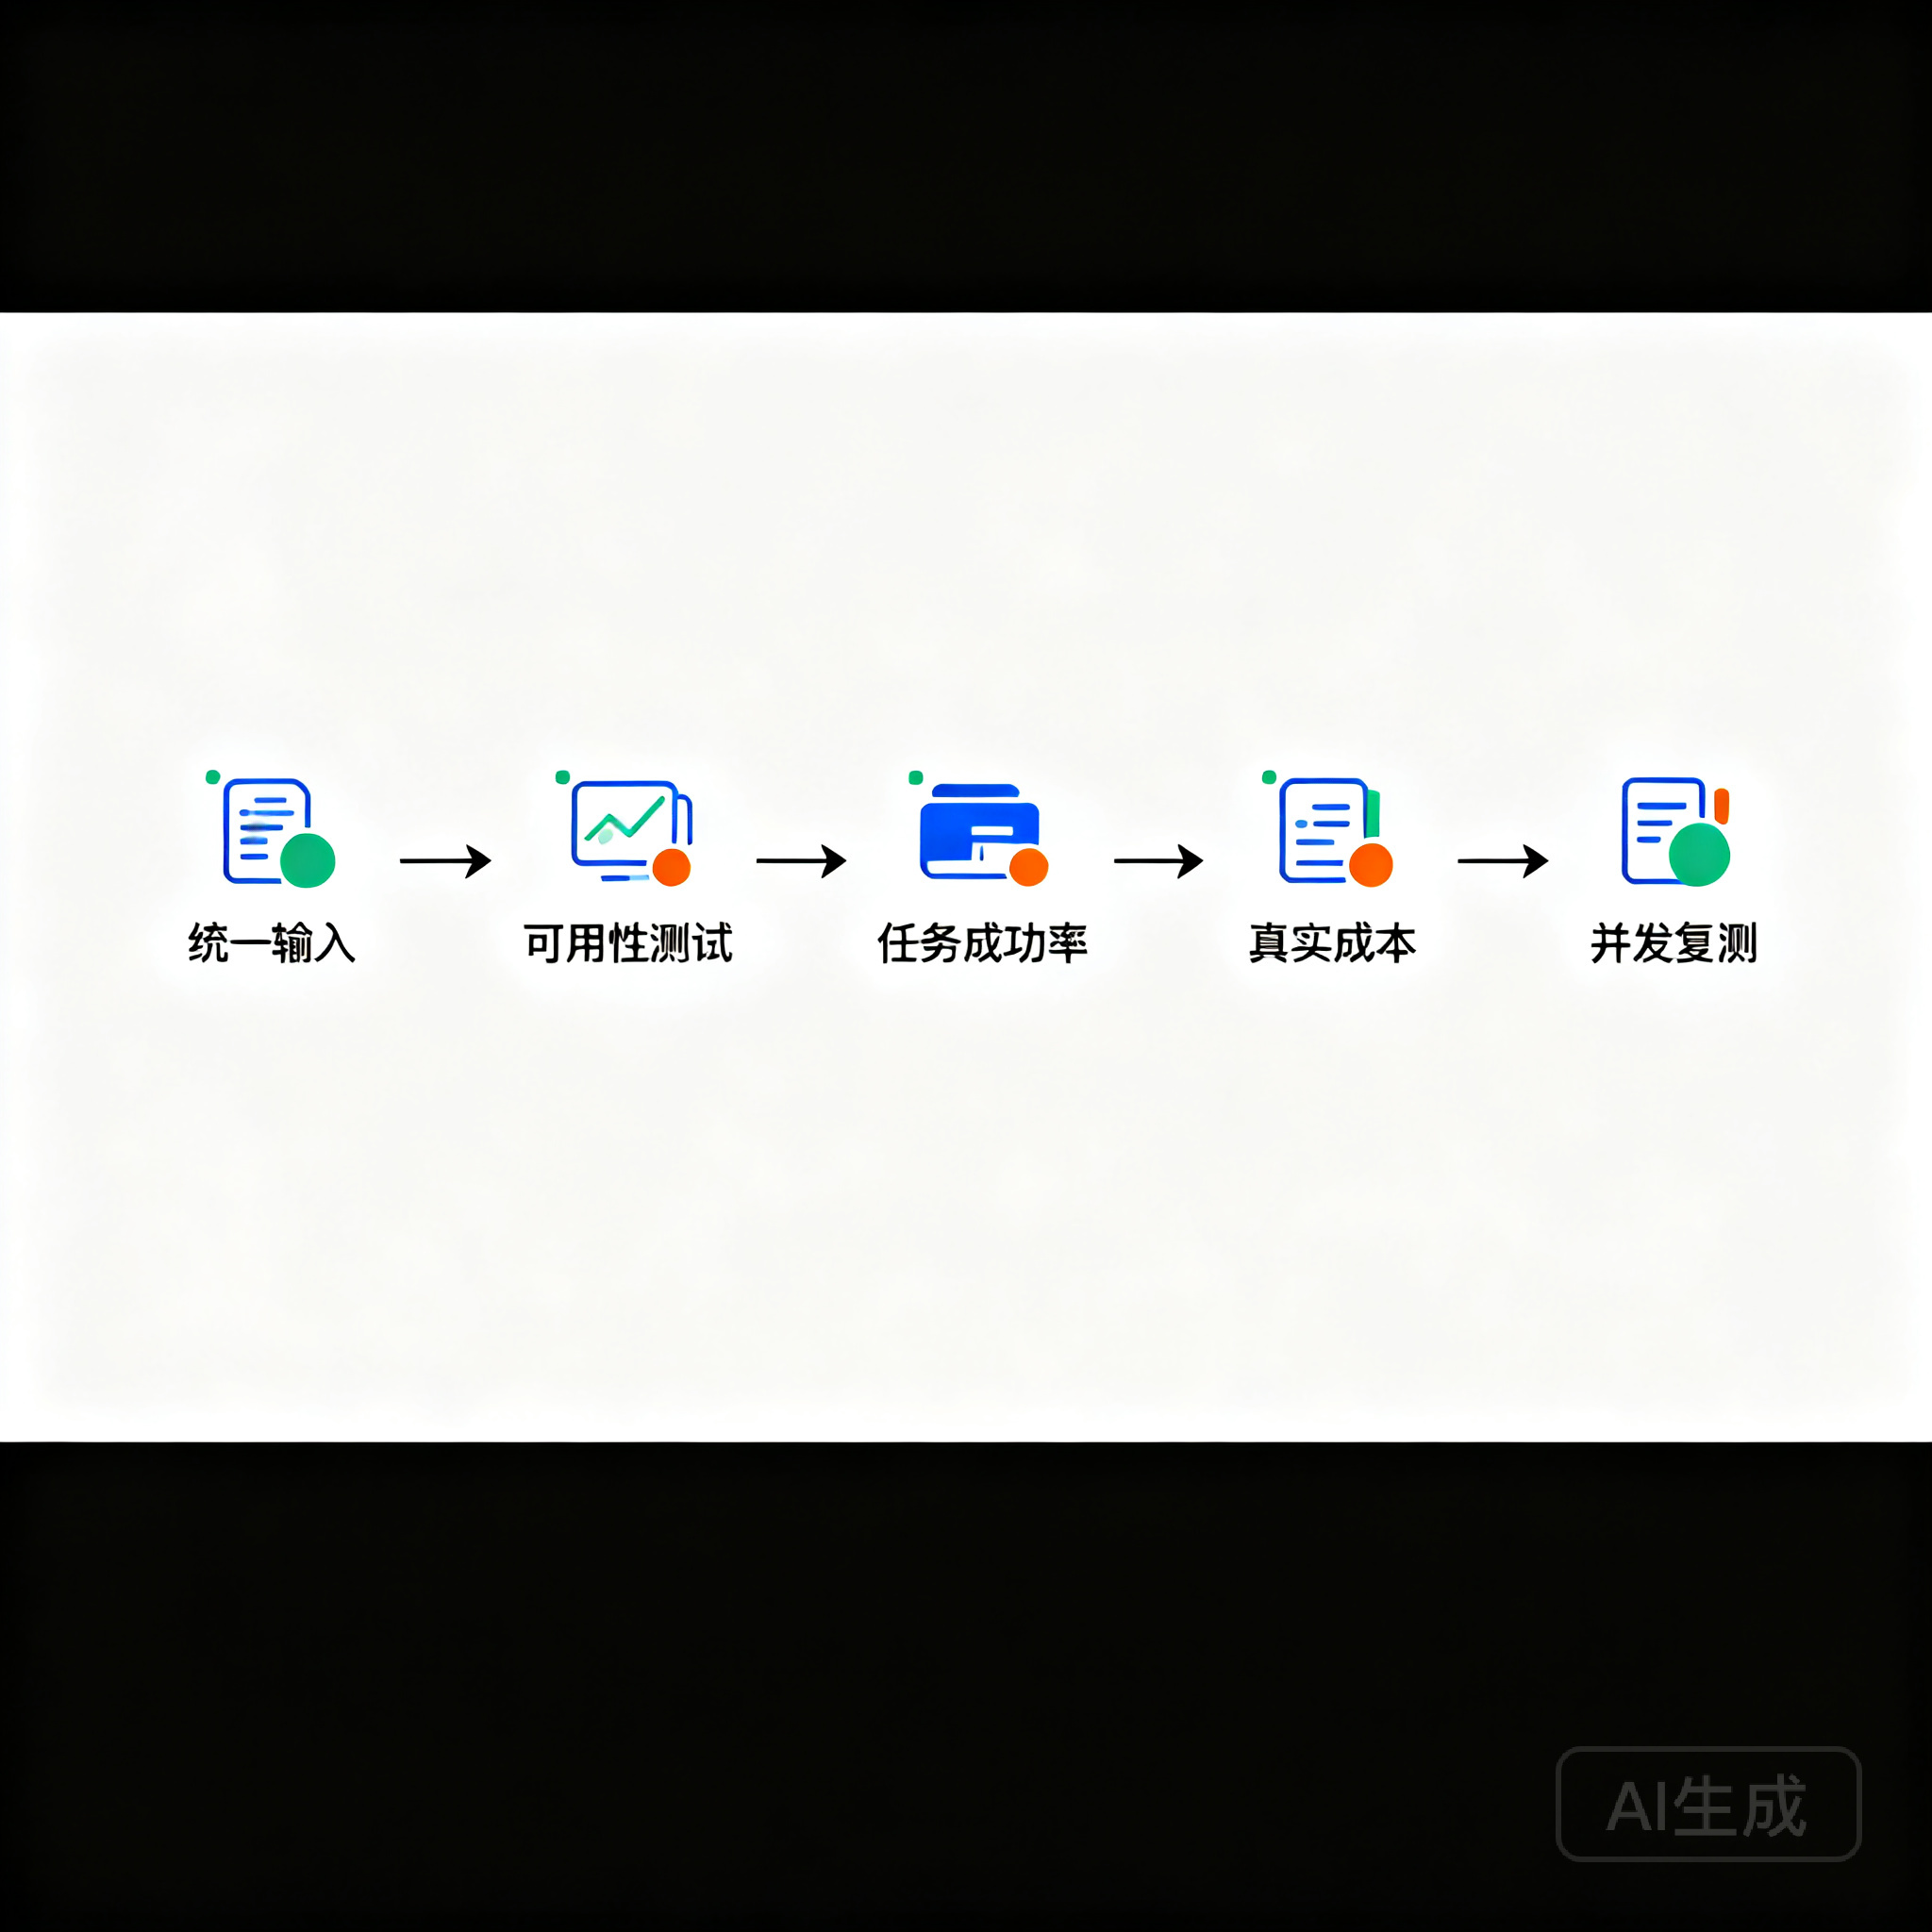
不要先凭宣传页决定供应商。准备 20 条脱敏样本,覆盖摘要、信息抽取、代码修复、长文本问答和一条图文任务,按下面顺序测试:
统一输入。 为每条样本固定 system prompt、输入长度、温度和输出上限;需要视觉能力的样本固定图片尺寸和格式。
先测可用性。 为每个平台创建独立 API Key,记录首 Token 延迟、完整响应延迟、HTTP 错误、超时和限流。不要把密钥写入仓库,使用环境变量或密钥管理服务。
再测任务成功率。 为每条样本定义可检查的验收条件,例如 JSON 是否可解析、抽取字段是否齐全、代码测试是否通过,而不是只凭阅读感受打分。
换算真实成本。 用输入和输出 Token、缓存命中、图片或音频单位,计算“每个成功任务成本”;订阅积分则按官方页面的模型倍率换算,不能直接拿套餐总额除以请求次数。
压测和复测。 在 1、5、20 并发下重复测试,记录 P95 延迟和失败重试次数;一周后用同一批样本复测,观察模型更新或配额刷新是否改变结果。
这套流程能回答三个实际问题:模型是否真的解决业务任务、接口是否撑得住峰值、账单是否能被解释。对团队而言,这比把“模型数量”或单次低价当作唯一指标更有决策价值。
怎么做最后选择
可以按以下顺序缩小范围:
多模态和多供应商并行验证: 先看阿里云百炼、火山方舟、百度千帆、硅基流动和七牛云 Token Plan 的模型目录、协议和额度规则。
围绕单一模型家族开发: 直接对照腾讯混元、智谱或 DeepSeek 的官方 API 文档、模型更新和配套 SDK。
已有 OpenAI SDK: 优先验证兼容层,但把工具调用、流式响应、上下文长度和错误码列成迁移清单。
高并发生产: 先谈限流、配额、专属资源、审计和故障转移,再比较单价。
成本敏感的内部工具: 先用固定样本测“成功任务成本”,再决定按量、订阅或自建推理。
据阿里云百炼 2026 年 9 月 22 日更新的模型文档,平台的模型选择已经按模态、理解、生成和向量检索等任务组织;据腾讯云混元官方产品页,混元家族也从文本扩展到图像、视频、语音和 3D。两类官方页面共同说明,今天选 API 服务商时,入口数量已经不是唯一变量,模型目录、协议细节和运营控制能力同样需要验收。
本文数据截至 2026 年 9 月 23 日,页面能力和接口以文末官方资料为准;价格、模型清单和限流规则可能随官方页面更新。
参考资料
阿里云百炼模型大全(官方文档)
智谱开放平台快速开始(官方文档)
DeepSeek API 快速开始(官方文档)
七牛云 Token Plan(官方产品页):https://www.qiniu.com/ai/plan