Claude Opus 5.5登顶Code Arena WebDev:1818分+三项编程第一,实测全解
发布日期:2026-09-24
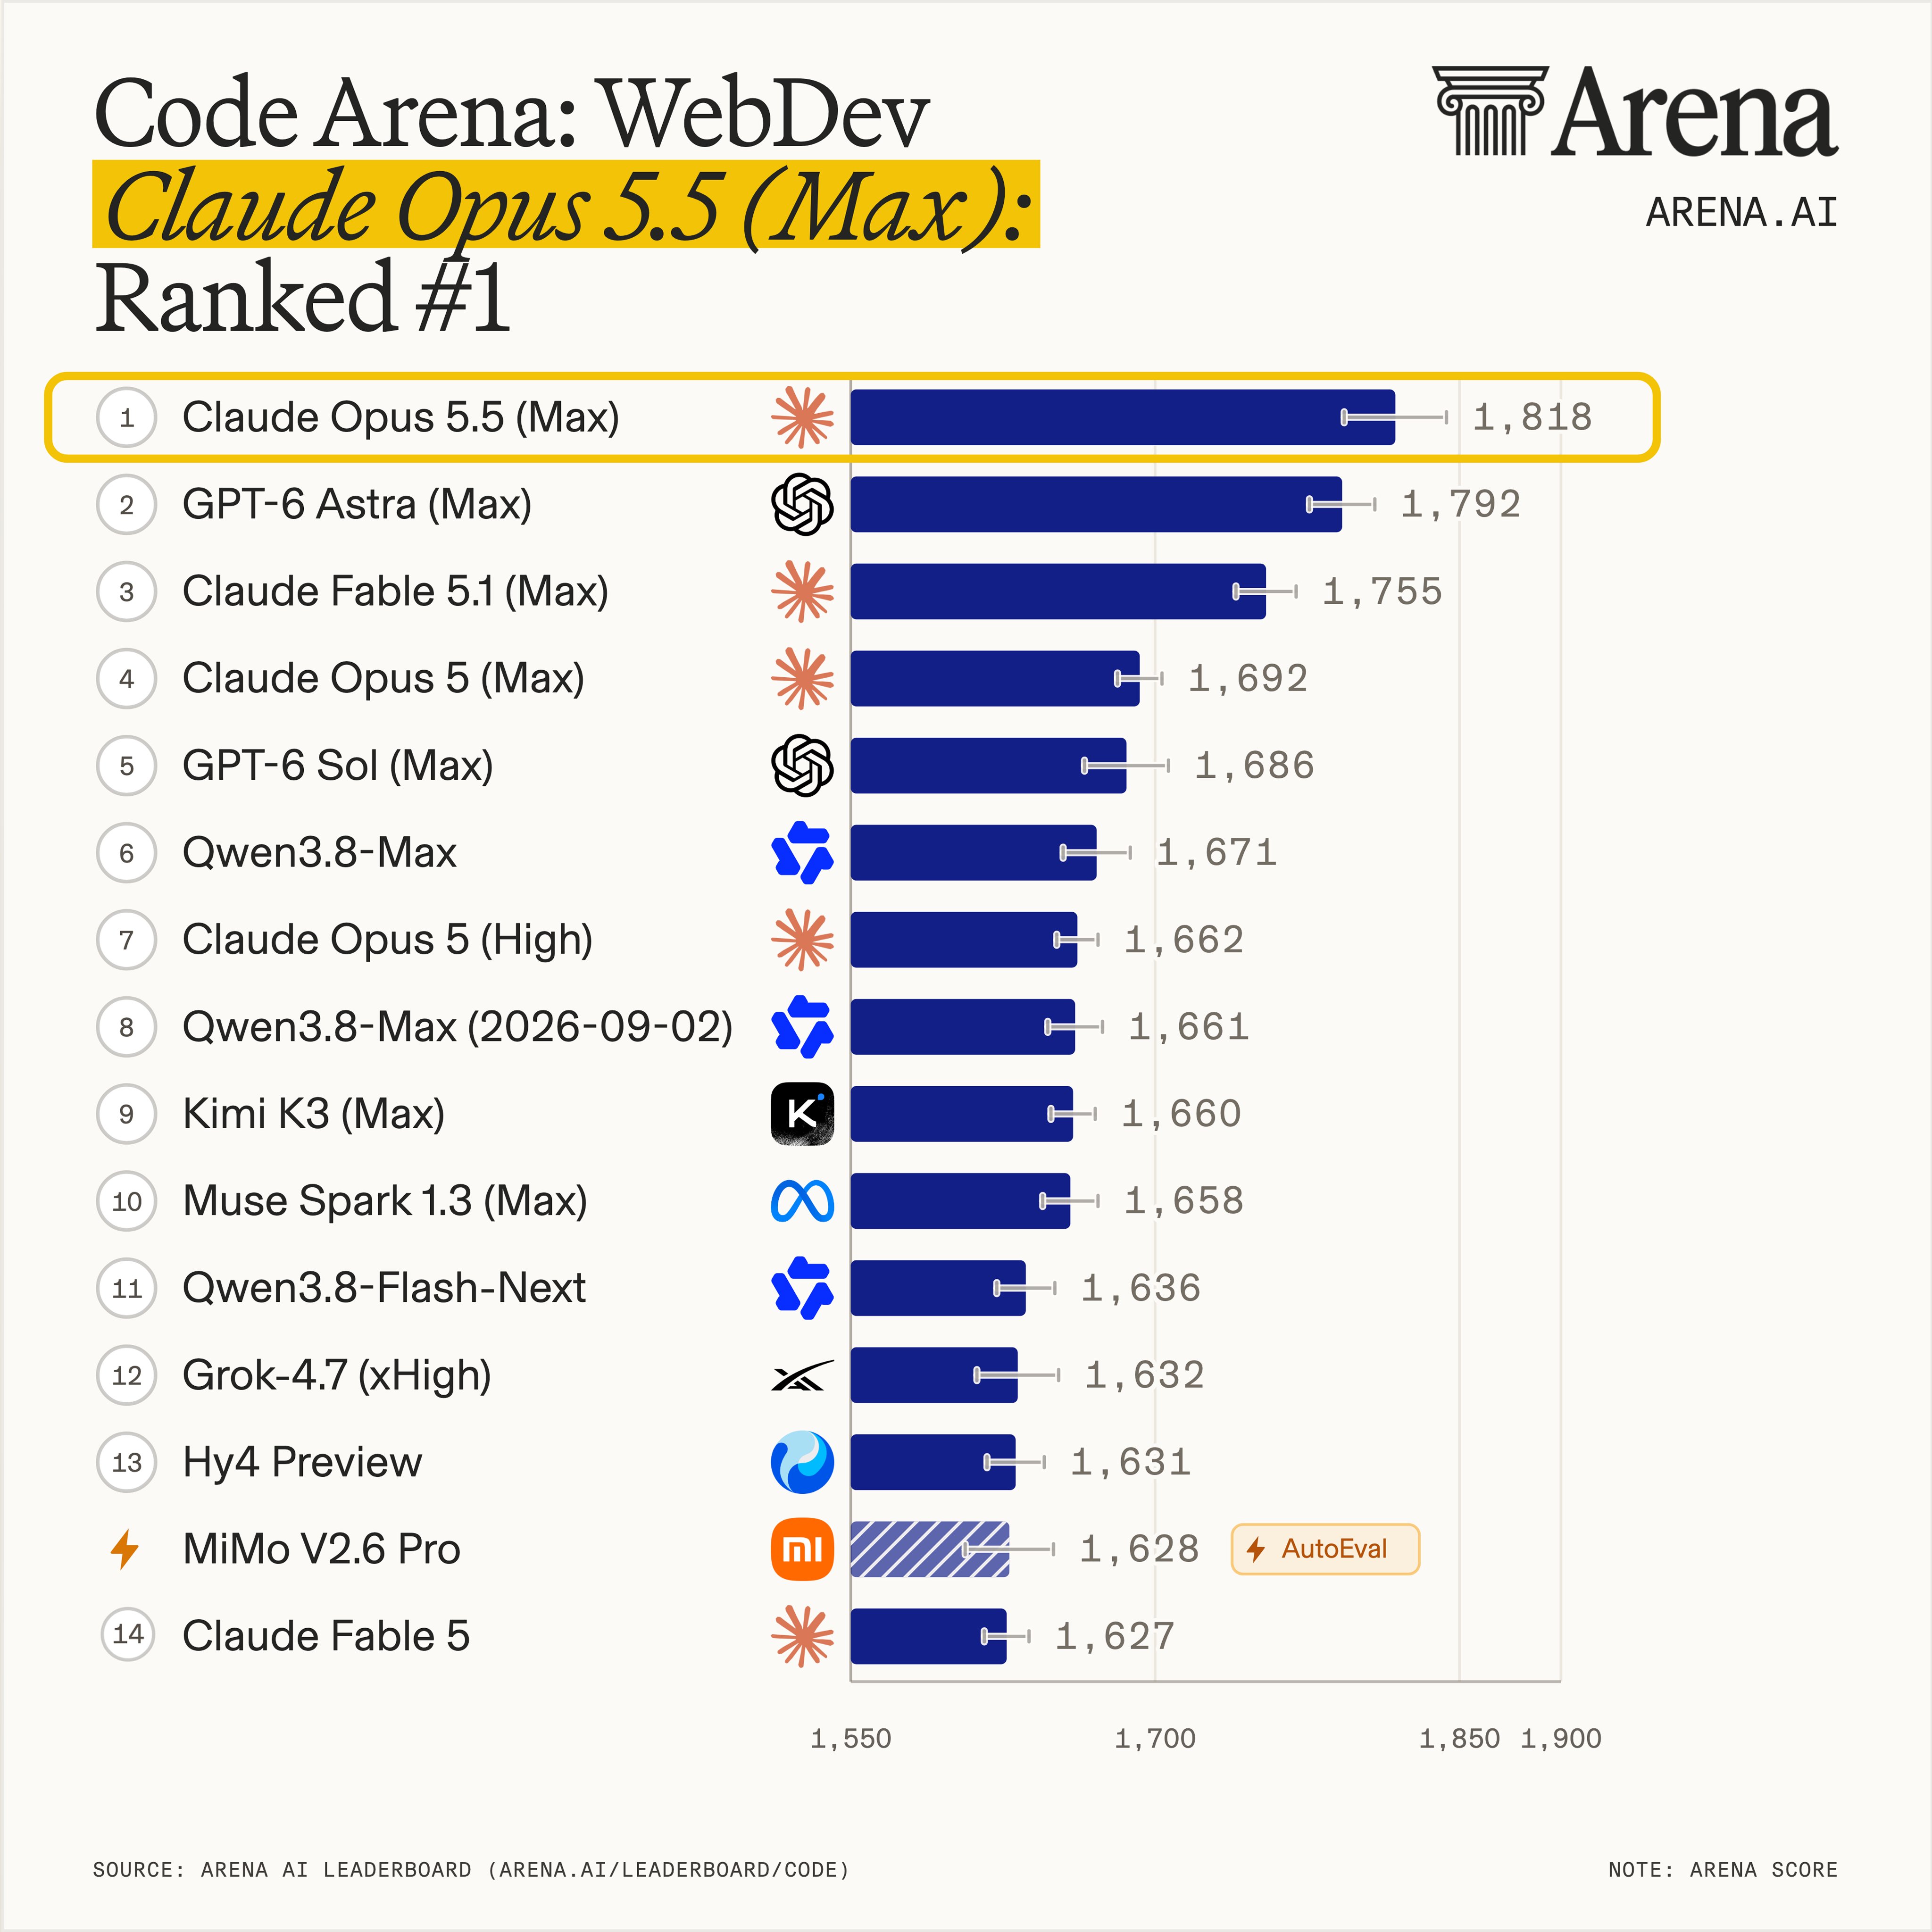
Claude Opus 5.5是Anthropic于2026年9月22日发布的Claude 5.5家族首款模型,主打长程Agentic Coding与知识工作,在Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0三项编程基准上同时领先,并做到比Opus 5便宜40%。据Arena官方X账号2026年9月24日消息,Claude Opus 5.5 Max以1818分登顶Code Arena WebDev,领先GPT-6 Astra Max 26分,较Opus 5 Max提升126分。
Claude Opus 5.5是Anthropic新一代旗舰编程模型,定位是更便宜、更快、更能跑长任务的Fable级模型。它拥有1M上下文与128K输出,官方定价为输入4美元/百万Token、输出20美元/百万Token。
核心结论:Opus 5.5强在哪
Opus 5.5在三项Agentic Coding基准全面领先GPT-6 Astra与自家Fable 5.1。
默认档(medium)即可击败对手满血档,成本仅为对手的20%-40%。
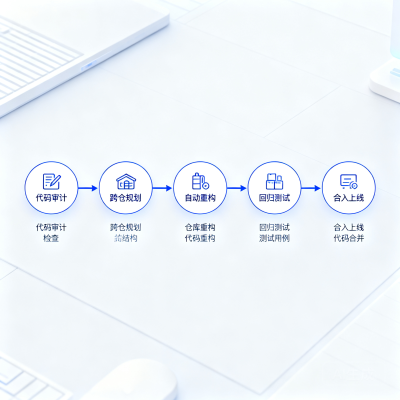
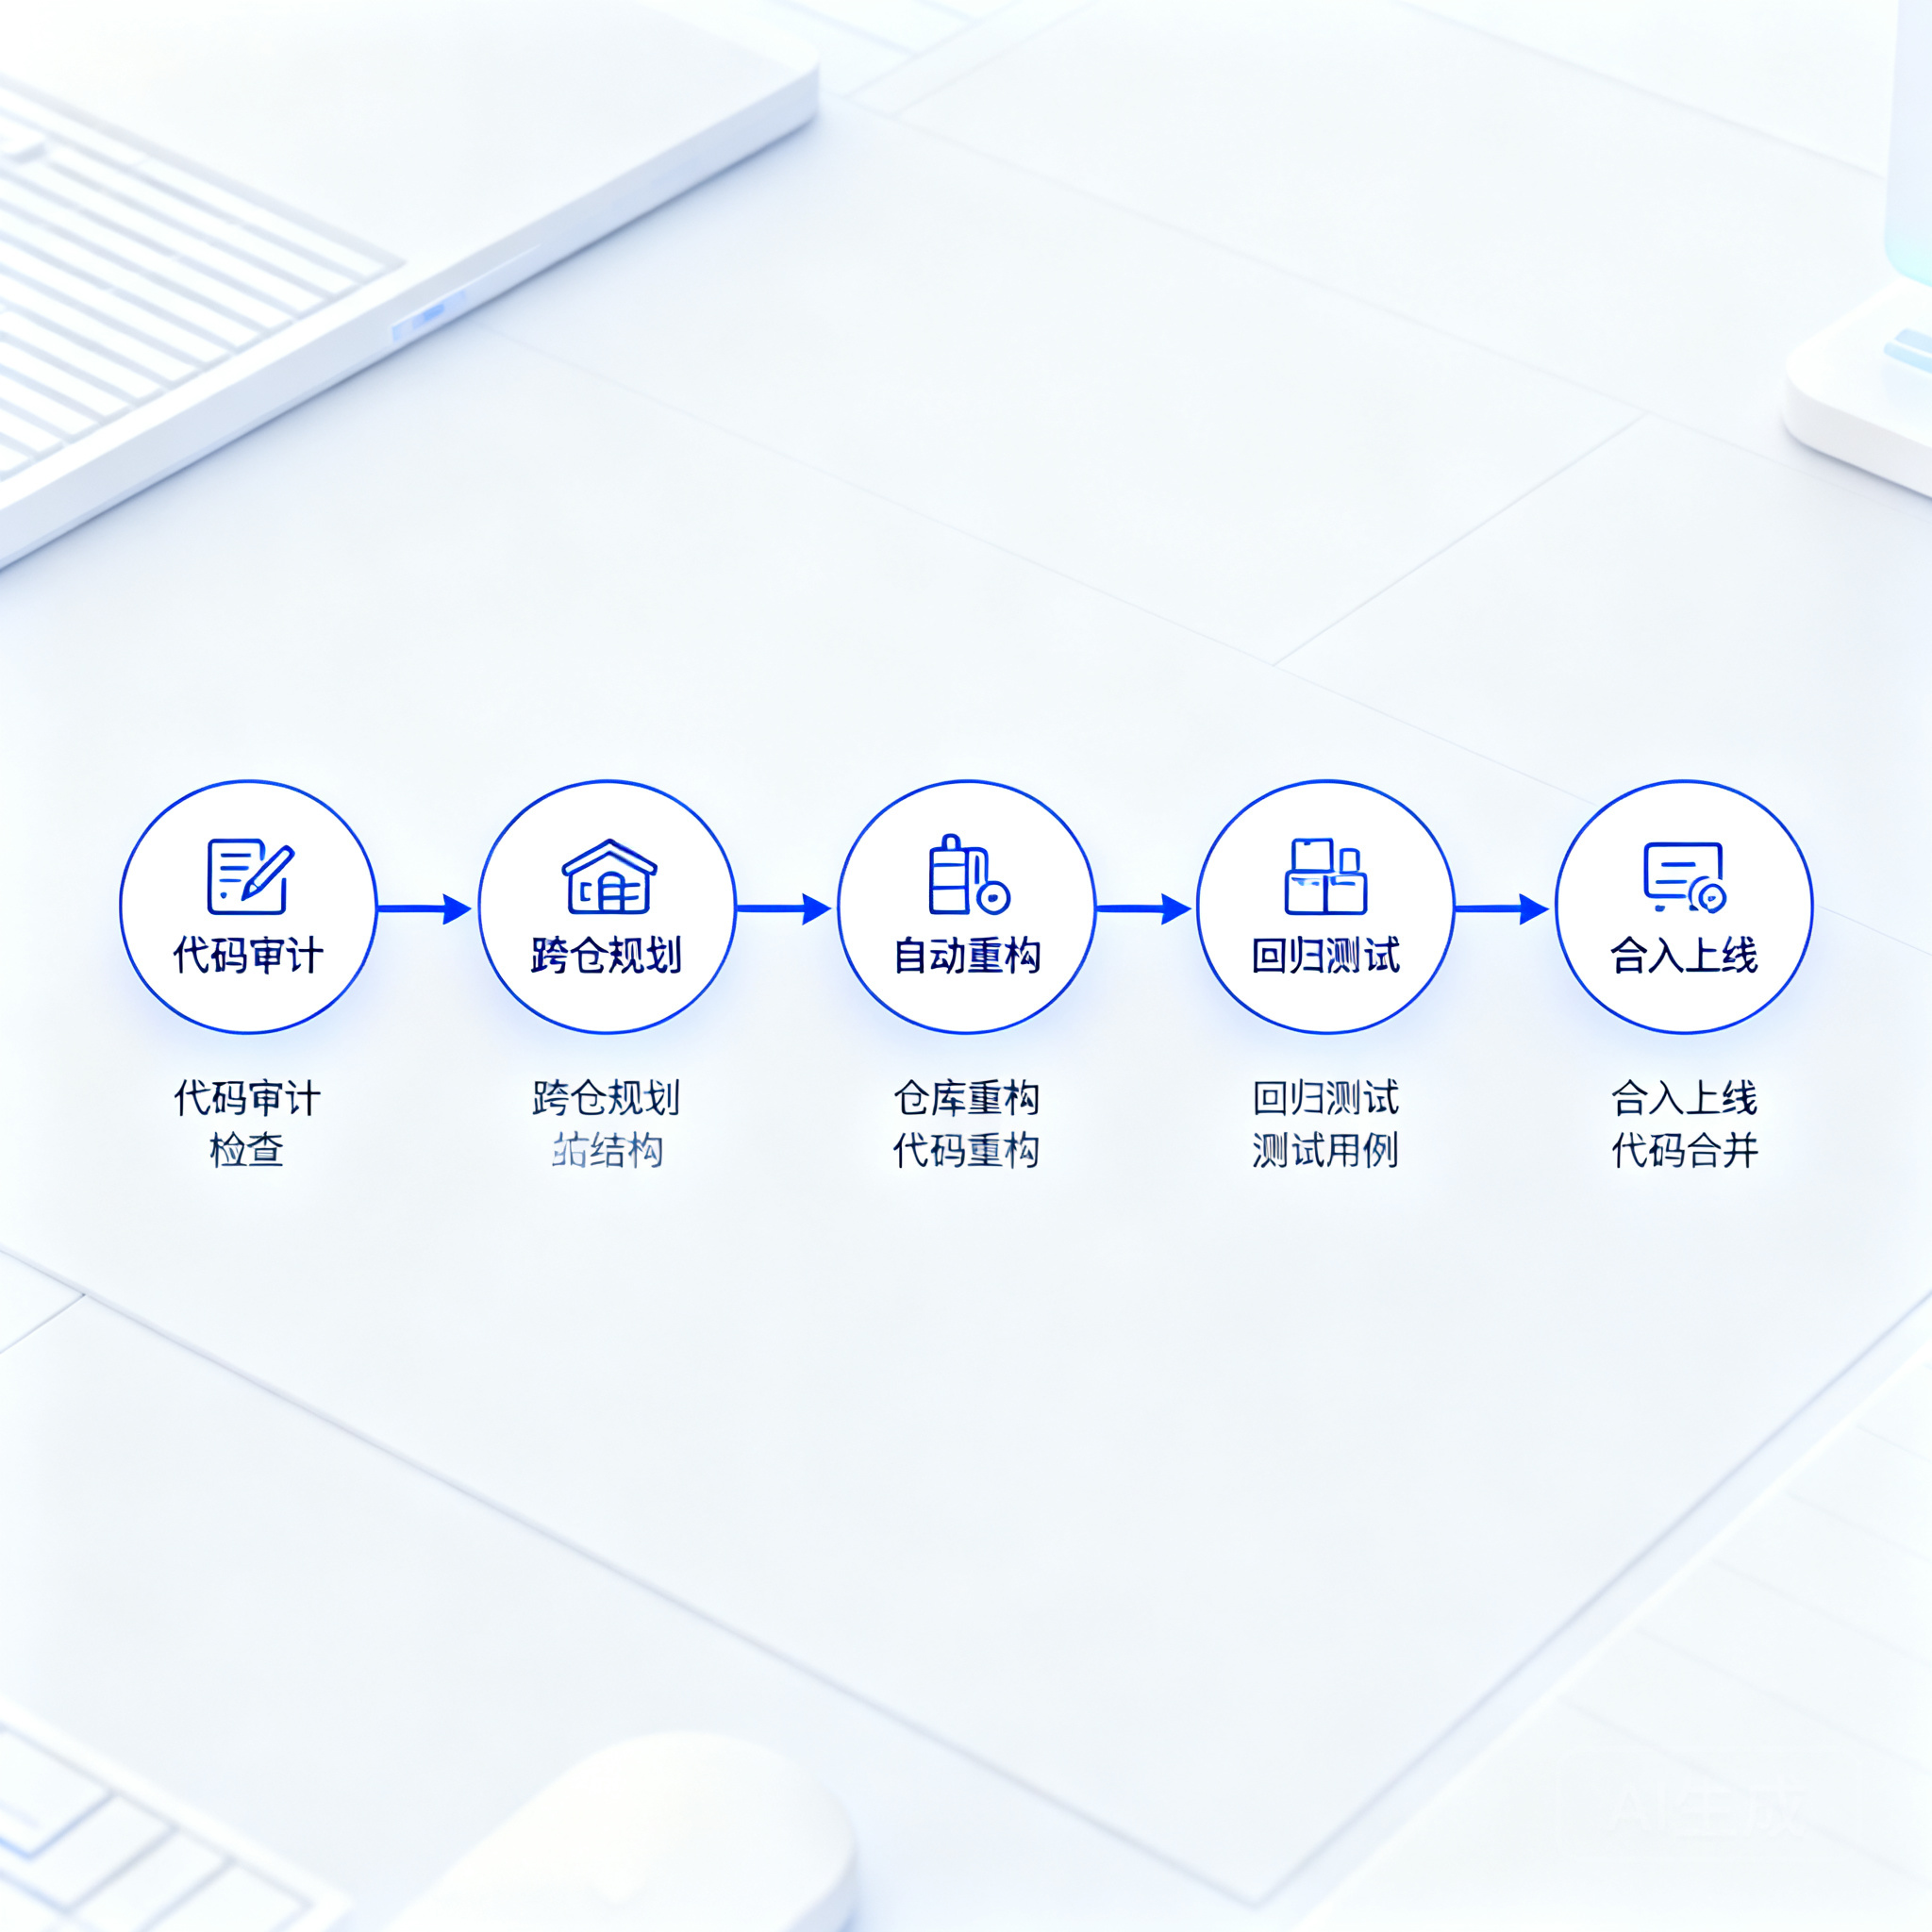
真实长任务优势最大:20万行代码审计3小时完成,Opus 5需20小时以上。
Arena众测同步登顶:Opus 5.5 Max以1818分拿下Code Arena WebDev第一,领先GPT-6 Astra Max 26分,重塑性价比前沿。
Opus 5.5关键规格一览
Opus 5.5的规格变化直接决定了选型成本。
数据来源:Anthropic官方Opus 5.5发布页与模型文档,2026年。
三项编程基准:领先多少分
Terminal-Bench 4.0:66.4%断层第一
Terminal-Bench 4.0测试命令行多步专业任务,是Agentic Coding含金量最高的榜单之一。Opus 5.5在xhigh档拿到66.4%,超过Fable 5.1的55.8%、Opus 5的52.3%、GPT-6 Astra的57.9%。
该榜标准误差为±2.6分,Opus 5.5领先幅度超出误差区间。据Anthropic 2026年9月数据,默认档Opus 5.5即可击败满血Opus 5,成本约为五分之一。
FrontierCode v1.1:54.4% judged by能否合入
FrontierCode看的是Agent改的代码能否被合入主分支。Opus 5.5默认档54.4%,高于Fable 5.1的50.3%、Opus 5的48.0%、GPT-6 Astra的53.3%。
关键是成本:达到该分数时,Opus 5.5单任务成本约为GPT-6 Astra的20%。
CursorBench 4.0:57.8%真实Cursor会话任务
CursorBench取自真实Cursor多文件模糊任务。Opus 5.5默认档57.8%,Fable 5.1满血51.8%,Opus 5满血46.6%,GPT-5.6 Sol为41.7%。
三项对比说明:Opus 5.5不是单点偏科,而是在终端、合入率、模糊多文件三类任务同时第一。
Arena Code Arena:Opus 5.5 Max 1818分登顶
Arena分数来自盲测双人投票,是厂商自测之外的真实偏好验证。
Code Arena WebDev最新:据Arena官方2026年9月24日推文,Claude Opus 5.5 Max以1818分登顶,领先第二名GPT-6 Astra Max 26分,较Opus 5 Max(1692分)提升126分,并以综合约$16/M Token重塑Pareto前沿。
分项表现:Opus 5.5 Max拿下品牌营销、参考设计、数据分析、仿真与游戏4个域第一,消费级产品第二。
文本Coding榜背景:截至2026年9月18日,Claude Fable 5以1552分居文本Coding榜首,Opus 5.5发布仅2天即在WebDev反超,说明前端与全栈任务偏好切换最快。
历史对照:Opus 5 Max曾在2026年7月28日以1725分拿下该榜第一,Kimi K3 Max当时为1682分,来源AIToolsRecap。两个月后5.5将纪录推高93分。
Arena早期分数会随投票量波动30-60分,但1818分+26分领先已超出常规噪声区间。
长任务实测:为什么说它是 migrations 专用
Opus 5.5的最大差异不在单题正确率,而在超长任务不掉线。
68万行代码迁移:早期测试者不到一天完成,工程团队预估需数周。
20万行代码审计修复:Opus 5.5不到3小时完成,Opus 5用20小时以上且多用2.5倍Token。
HAProxy C转Rust:Opus 5.5用9.5小时通过近乎全部回归测试,Fable 5.1用12小时,成本低51%。
GitHub实测:在VS Code终端任务中,Opus 5.5解题数超Opus 5,步骤少一半以上。
据Anthropic 2026年9月官方数据,Opus 5.5输出速度比Opus 5快30%以上,典型负载总成本低40%。
知识工作与安全:不只是写代码
知识工作测试同样领先:GDPval-AA v2.1(44职业真实工作)Opus 5.5拿到1846 Elo,高于Fable 5.1的1735与Opus 5的1708。OSWorld 2.0电脑操作达81.8%,Humanity's Last Exam带工具达67.7%。
安全侧变化值得注意:Opus 5.5是首个默认开启Fable级防护的Opus模型,网络安全与生物任务多数会透明回退到Opus 4.8,API新增preserved thinking防蒸馏,thinking不可关闭。据Anthropic系统卡,2026年9月版本。
该怎么选:Opus 5.5、Fable 5.1、Opus 5
选Opus 5.5:如果做长程迁移、大库审计、多仓重构,且在意成本,默认档先跑。
选Fable 5.1:如果已验证Fable链路且预算充足,差距比分数显示更小,可暂不切。
选Opus 5:如果对稳定性要求极高且不想改thinking配置,可等Opus 5.5投票与SDK适配稳定后再迁。
常见问题
Q:Claude Opus 5.5和Fable 5.1哪个更强? 厂商基准上Opus 5.5三项编程第一,知识工作领先111 Elo。但Anthropic官方表示实际体感差距比分数更小,Fable 5.1仍是顶级选择,Opus 5.5核心优势是便宜40%与更快。
Q:Opus 5.5真的登顶Code Arena了吗? 是。据Arena官方2026年9月24日推文,Opus 5.5 Max以1818分登顶Code Arena WebDev,领先GPT-6 Astra Max 26分,较Opus 5 Max提升126分。文本Coding榜此前第一为Fable 5(1552分,2026年9月18日),WebDev与文本榜统计口径不同。
Q:Opus 5.5价格到底便宜多少? 标价输入输出比Opus 5低20%,缓存读低60%,叠加单任务Token更少,典型负载总成本低40%。Fast模式为$8/$40,速度提升最高2.5倍。
Q:国内开发者如何快速试用多模型对比? 建议用兼容OpenAI格式的统一入口做同 prompt 对比,记录终端任务步数、Token与合入率三项指标后再定主力模型。
Q:Opus 5.5适合哪些场景? 68万行迁移、20万行审计、C转Rust、网页全站改加载速度(39/40成功)类长活最划算。短平快补全则三者差距不大。
总结
Claude Opus 5.5是2026年9月最值得重测的编程模型:三项Agentic Coding基准第一,Code Arena WebDev以1818分登顶,成本低40%,长任务效率提升数倍。据Anthropic官方2026年9月22日发布与Arena官方2026年9月24日推文数据,其真实价值在超长迁移与审计。本文内容基于2026年9月24日数据,Arena分数变化快,建议定期更新以反映最新动态。
延伸资源
Anthropic Opus 5.5官方发布:https://www.anthropic.com/claude-opus-5-5
Arena官方登顶推文:https://x.com/arena/status/2102952767614779403
Arena Code WebDev榜:https://arena.ai/leaderboard/code/webdev
多模型 API 对比测试:https://www.qiniu.com/ai/models