Sonnet 5.5 vs Opus 5.5:同一半价格,什么时候该选哪个
发布日期:2026-09-29
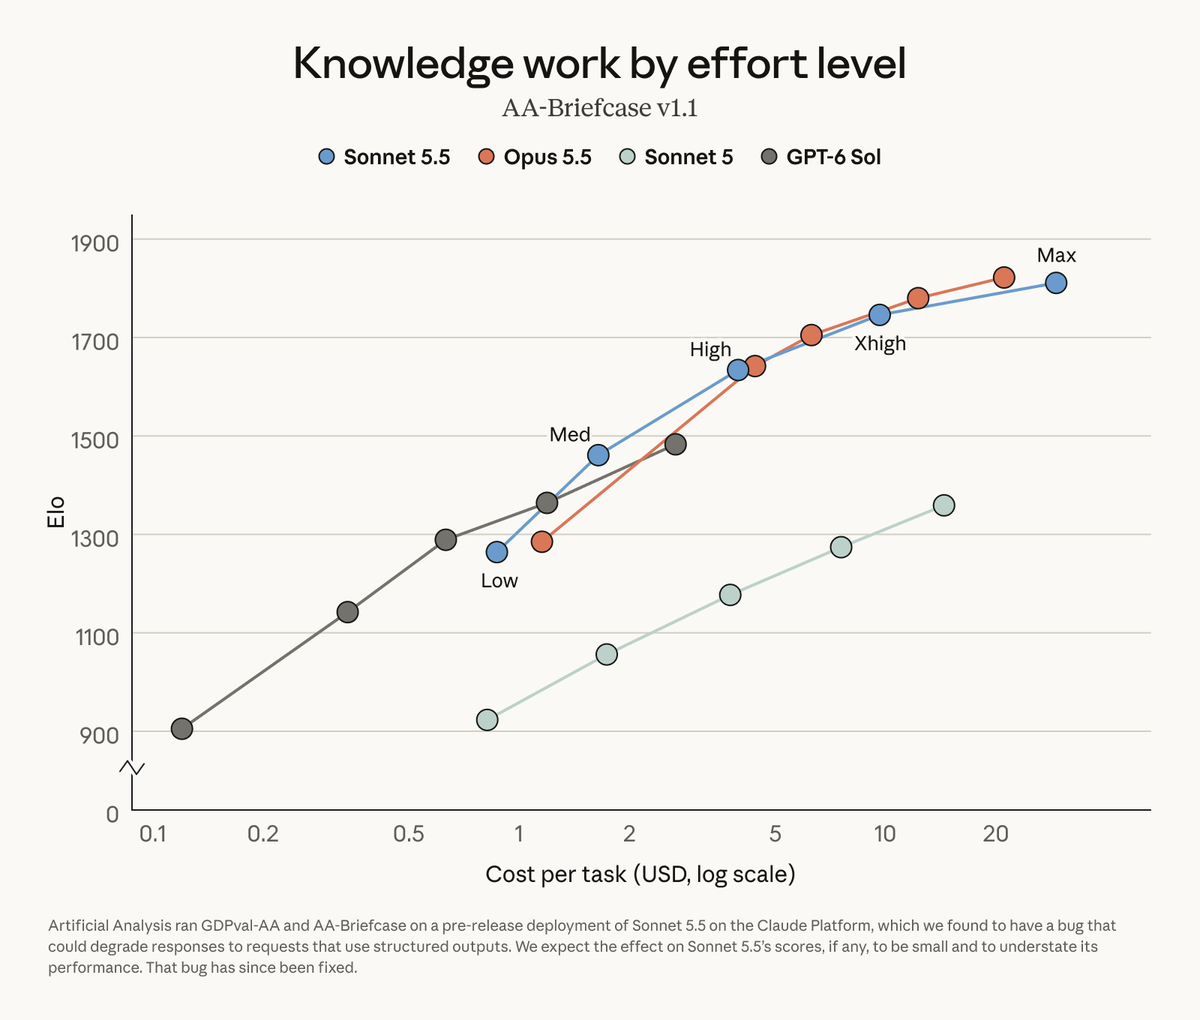
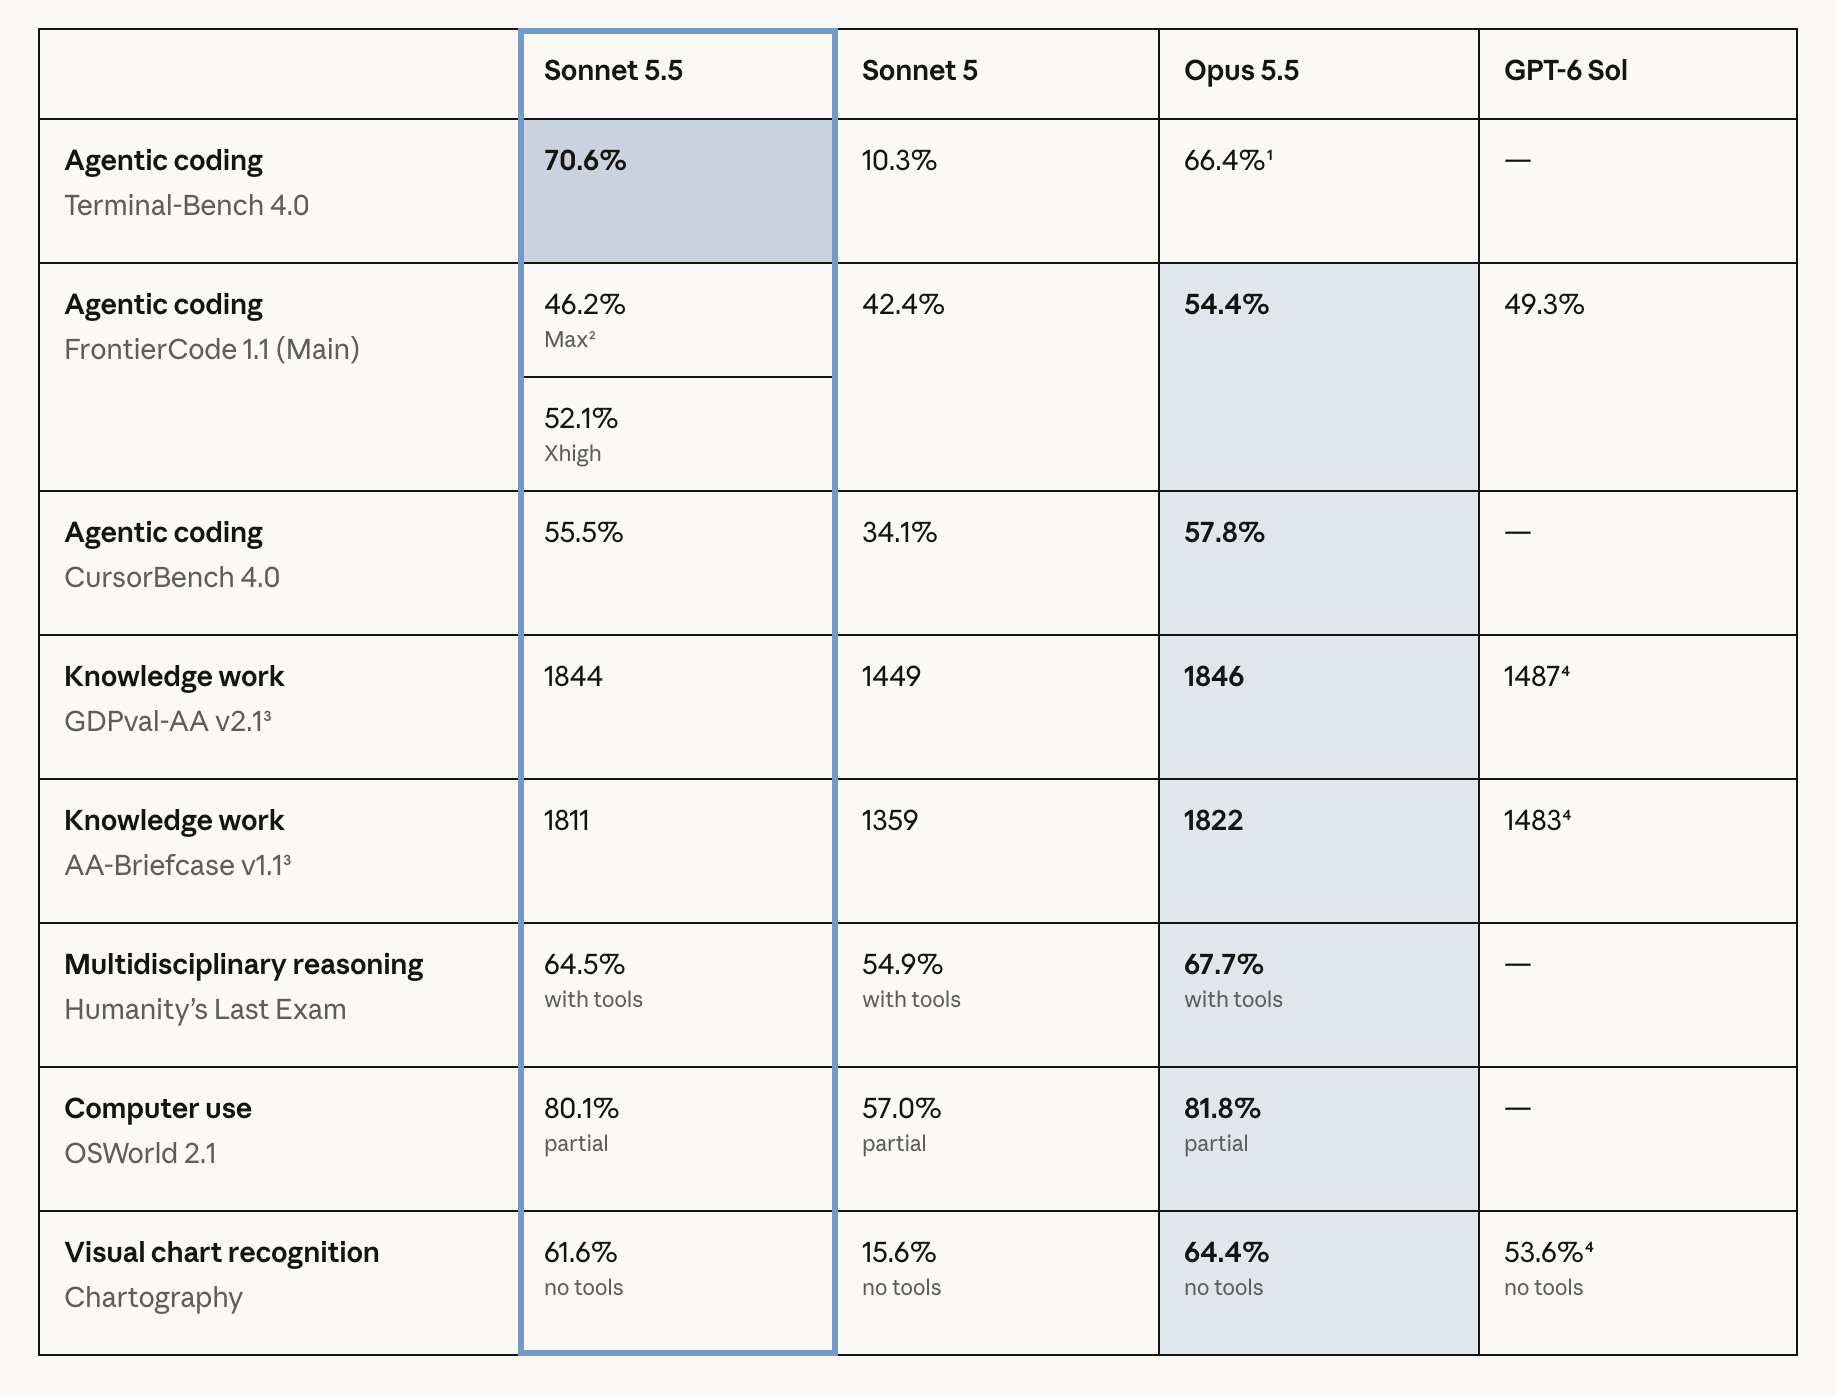
Claude Sonnet 5.5 由 Anthropic 于 2026 年 9 月 28 日发布,是继 9 月 22 日 Claude Opus 5.5 之后 Claude 5.5 系列的第二款模型,官方把两者定位为搭档关系而非替代关系:Opus 5.5 负责需要持续判断的复杂长周期任务,Sonnet 5.5 专注边界清楚的日常工作,价格仅为 Opus 5.5 的一半,却在 Terminal-Bench 4.0 等基准上开到高思考档位后反超了 Opus 5.5 的最高分。本文把两款模型的价格、速度、跑分和适用场景拆开对照,给出一个不看厂商话术、只看任务特征的选型判断法。
价格差多少:Sonnet 5.5 是 Opus 5.5 的一半
两款模型的官方定价(每百万 token):
单价上 Sonnet 5.5 是 Opus 5.5 的一半,但 Anthropic 官方开发者博客明确说明,这个价差不是靠调低单价换来的:"the per-token price is unchanged",Sonnet 5.5 真正的省钱逻辑是完成同一任务所需的 token 数量更少——也就是说,即便逐 token 计费,Sonnet 5.5 实际账单也会因为对话轮次更短、走弯路更少而进一步压低。
Terminal-Bench 4.0 上,Sonnet 5.5 反超了 Opus 5.5
这是本轮发布最反直觉的一组数据:Sonnet 5.5 开到 Max 思考档位时,在 Terminal-Bench 4.0 上拿到 70.6% 的成绩,反超了 Opus 5.5 在同一测试上 66.4% 的最高分。这是 Sonnet 系列历史上第一次在公开基准上反超同代 Opus。
不过 Anthropic 官方开发者博客对这类高分场景给出了明确边界:Sonnet 5.5 能追平甚至反超,只发生在"任务有清晰规格、且有办法核验结果"(a clear spec and a way to check the result)的场景——Terminal-Bench 一类可自动验证成败的任务恰好符合这个条件。对于开放式、需要持续判断、缺乏明确验证标准的长周期任务,官方原话是"for the hardest long-horizon work, an Opus model is the better choice"。
官方给出的场景划分表
Anthropic 开发者博客把两款模型的分工写得很具体,直接给出了任务类型对照:
这个划分和价格结构是对应的:把"边界清楚"的任务交给更便宜、更快的 Sonnet 5.5,把"开放式、高判断力"的任务留给 Opus 5.5,是两款模型价格差一倍设计背后的逻辑。
"思考力度"分档:两款模型档位一样,但含金量不同
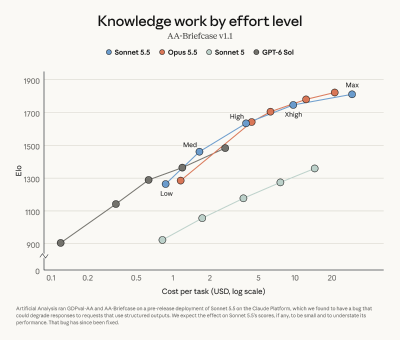
Sonnet 5.5 和 Opus 5.5 都支持从 Low 到 Max 的五档"思考力度"(thinking effort)调节,档位越高、思考越久、单次成本越高。但 Anthropic 官方明确提示了一个容易被忽略的细节:Sonnet 5.5 的档位刻度经过重新校准,同名档位(比如 Medium)在 Sonnet 5.5 下产生的思考量,并不等同于 Sonnet 5 时代的同名档位。
如果在 Sonnet 5.5 上把档位调到 Xhigh 甚至 Max 仍不满意,官方给出的建议就是直接换成 Opus 5.5,而不是继续在 Sonnet 5.5 内部往上加档——这也从侧面印证了两者不是同一模型的"强弱版本",而是分别有自己的能力上限。
不同产品线的默认档位也不一样:Claude Code 和 Claude 网页应用默认使用 Medium 档位,Claude 开发者平台(API)默认使用 High 档位;在 Claude Code 里,从 v2.1.284 版本起,sonnet 别名已指向 Sonnet 5.5,但 Claude Code 的默认模型仍然是 Opus 5.5,需要手动执行 /model sonnet 才能切换过去。
该怎么选:三个判断维度
不看厂商宣传的跑分,用三个问题快速判断该用哪个:
任务有没有清晰的验证标准? 有(比如"跑通这段测试"“按这份需求文档改代码”)→ Sonnet 5.5 通常够用;没有明确对错标准的开放式任务 → 优先 Opus 5.5。
任务链条有多长? 单次或短链路的日常修复、文档整理 → Sonnet 5.5;需要跨多轮持续保持判断一致性的长周期 Agent 任务 → Opus 5.5。
调到 Sonnet 5.5 最高档位还不满意吗? 如果是,直接换 Opus 5.5,而不是继续加大 Sonnet 5.5 的思考力度——官方已经说明两者不是同一档位体系的延伸。
对大批量、日常性的请求,Sonnet 5.5 搭配较低思考档位是成本最低的组合;只有在触及"最难的问题"时,才需要为 Opus 5.5 的判断力买单。
常见问题
Q:Sonnet 5.5 反超 Opus 5.5,是不是说明以后不用买 Opus 了?
不是。反超只出现在 Terminal-Bench 4.0 这类有明确验证标准的基准测试里,官方明确说明面对"最难的长周期问题",Opus 系列仍是更优选择。把 Terminal-Bench 的分数直接等同于"整体更强"是对基准测试适用范围的误读。
Q:两款模型能不能混着用?
可以,而且这正是官方推荐的分工方式:日常任务默认走 Sonnet 5.5,遇到需要持续判断的复杂任务再切换到 Opus 5.5,而不是整个项目二选一。多模型混用需要统一管理调用方式时,类似七牛云 AI 大模型广场这类支持多模型同屏对比、按需切换的平台,能减少来回切换配置的成本。
Q:Sonnet 5.5 的思考力度调到最高,效果就能等于 Opus 5.5 吗?
不能简单类推。官方文档明确 Sonnet 5.5 的档位刻度经过重新校准,且两款模型面向的任务类型本身就不同,调高档位只是让 Sonnet 5.5 在自己的能力范围内更仔细,并不会让它具备 Opus 5.5 面向长周期高判断力任务的能力。
Q:Claude Code 里默认用的是哪一个?
Claude Code 的默认模型是 Opus 5.5,即便 sonnet 别名已经指向 Sonnet 5.5(从 v2.1.284 版本起),也需要手动执行 /model sonnet 才会切换过去,两者不会自动互相替代。
结语
Sonnet 5.5 和 Opus 5.5 的关系不是"降级版"和"旗舰版",而是按任务特征分工的搭档:一个负责快、便宜、边界清楚的日常工作,一个负责慢、贵、但能扛住长周期高判断力任务。Terminal-Bench 4.0 上的反超是特定任务类型下的结果,不代表整体能力反超。本文内容以 Anthropic 官方发布信息及开发者博客 2026 年 9 月的公开信息为准,具体参数和适用场景请以官方文档实际展示为准。
参考资料
Anthropic 官方发布公告:anthropic.com/claude-sonnet-5-5
Claude 开发者博客《Building with Claude Sonnet 5.5》:claude.dev/blog/building-with-claude-sonnet-5-5
七牛云 AI 大模型广场:qiniu.com/ai/models
七牛云 Token Plan 官方页面(deepseek最低1.2折):https://www.qiniu.com/ai/plan