Codex WebFetch 403 怎么解决:先搞清楚 403 到底卡在哪一层
发布日期:2026-09-28
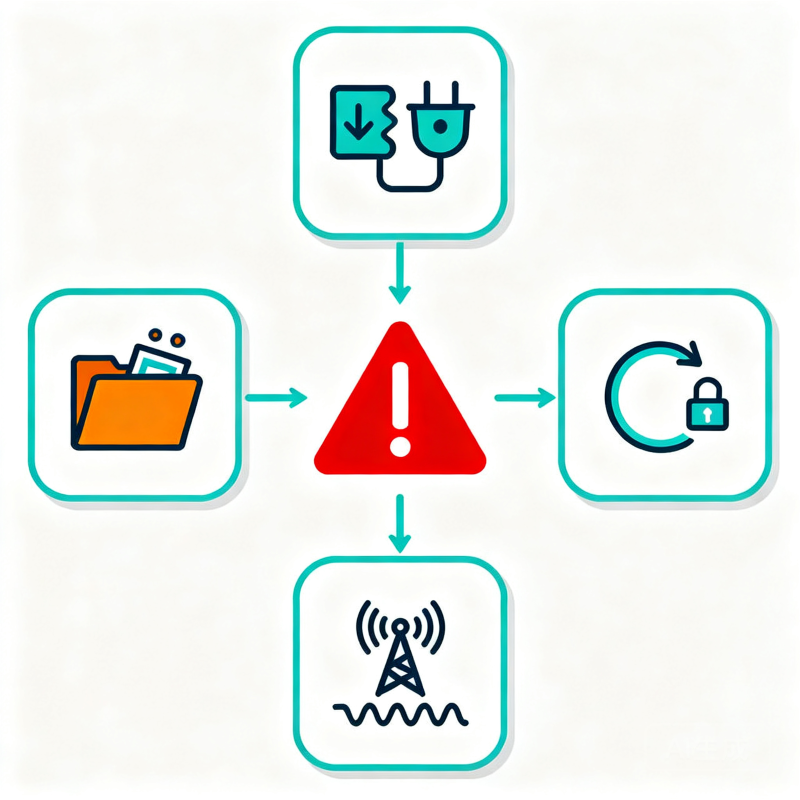
Codex 是 OpenAI 推出的编程 Agent(CLI/IDE 插件/云端环境三种形态),本身并没有一个官方文档里正式命名为"WebFetch"的独立工具,开发者口中的"Codex webfetch 403"实际指向三种不同的报错场景:登录鉴权阶段的 Token 交换失败、沙箱网络访问被拦截、以及内置 web_search 工具在不同模式下的访问限制。这三类问题的报错表现都可能是 403,但成因和解决路径完全不同,混着排查只会越改越乱。本文根据 Codex 官方文档(learn.chatgpt.com/codex)和开发者实测记录,把这三条路径拆开讲清楚,并给出针对每一种场景的排查步骤。
"Codex WebFetch"这个说法从哪来的
先说清楚一个容易搞混的地方:Codex 官方文档里没有一个字段或工具叫"web_fetch"或"WebFetch"。这个命名更像是开发者在讨论时借用了 Claude Code 里 WebFetch 工具的叫法,用来泛指"Codex 在联网抓取内容时报错"这类场景。
Codex 官方文档里实际存在的、和"联网"相关的机制是两套完全独立的东西:
web_search工具:一个托管型(hosted)搜索工具,官方文档明确写道"Web search is a hosted tool, separate from sandboxed local command networking. It does not use the permission profile's network proxy or domain allowlist"——它和下面第二套机制不共享同一套网络规则。沙箱网络访问(sandbox network access):控制 Codex 执行的命令(比如运行一段代码里的 curl 或 fetch 请求)能不能访问外网,由
sandbox_mode和sandbox_workspace_write.network_access等字段控制。
搞清楚报错发生在这两套机制中的哪一个,或者根本不在这两套机制里(比如登录鉴权失败),是解决"403"的第一步。
场景一:登录鉴权阶段的 403,和网络请求本身无关
开发者社区里最常被提到的一类 403,实际发生在 Codex 登录换取访问令牌的阶段,报错原文类似"Token exchange failed: token endpoint returned status 403 Forbidden"。有实测记录明确指出,这个 403"跟你的业务代码无关,它发生在'拿 Key 换 Token'这一步",也就是身份验证链路上,而不是某次具体的网页抓取请求失败。
这类 403 常见的排查方向:
base_url和 API Key 不匹配:如果配置了自定义的base_url,报错表现是连用 curl 直连测试也会返回 403,说明问题在通道本身,不在 Codex 客户端;环境变量残留冲突:旧的
OPENAI_API_KEY、OPENAI_BASE_URL没清理干净,可以用env | grep -iE "openai|codex|api_key|base_url"检查是否有过期值;model字段写了不存在的模型名:配置文件里模型名拼错也可能在鉴权链路上间接触发 403;IDE 插件缓存旧 Token:删除插件数据目录里 Codex 相关的缓存并重启 IDE,让登录流程重新走一遍。
修改 config.toml 后必须重启 Codex 或重启 IDE 才会重新读取配置,这一点容易被忽略,改完不重启,报错会原样复现。
场景二:沙箱网络访问被拦截,命令层面的 403/拒绝
第二类场景是 Codex 执行的命令本身要访问外网,但被沙箱策略挡住了。官方文档给出的字段结构是:
这里有个容易踩坑的细节:官方文档写明"deny 优先于 allow"(deny wins on conflicts),而且代理没开启时,域名规则根本不会被强制执行,请求走的是直连,规则形同虚设。也就是说,如果你以为配了白名单就等于开了网络访问,但没同时打开 features.network_proxy.enabled,实际效果和没配是一样的。
官方文档没有给出网络访问被拒绝时具体返回的 HTTP 状态码文案,只描述了权限层面的行为逻辑(是否询问批准、是否命中白名单)。也就是说,如果你在这一层看到了 403,更可能是目标网站或目标 API 自己返回的 403,而不是 Codex 沙箱本身生成的错误页。
对于云端环境(Codex Cloud),网络访问是另一套独立开关:默认情况下"命令只能访问受管理白名单里的必要主机名",开启"Allow public internet access"之后才能访问公网,且即便开启,官方也只放行了部分 HTTP 方法,文档原文写"Requests using other methods(POST、PUT、PATCH、DELETE 等)会被拦截"。
场景三:web_search 工具自身的访问模式限制
如果报错发生在 Codex 主动检索网页内容而不是执行命令时,问题很可能出在 web_search 这个工具的模式配置上,而不是沙箱网络层。官方文档给出三种模式:
web_search = "live":实时抓取网页;web_search = "disabled":完全关闭该工具;web_search = "indexed":仅在搜索索引命中时才允许访问外部内容。
官方文档特别说明,本地会话默认使用缓存搜索(cached mode),"使用 OpenAI 维护的索引,而不是实时抓取任意页面";只有在 Codex 以完全访问模式(danger-full-access)运行时,web_search 才默认切换为实时结果。这意味着,如果你的配置停留在默认的低权限模式,却期望它像实时爬虫一样抓取任意 URL,拿到的结果本身就受限,和"403"报错是两个不同层面的问题——报错通常发生在沙箱网络层或目标网站本身,而不是 web_search 这个托管工具内部。
排查顺序:先分层,再动手改配置
按下面的顺序判断报错落在哪一层,再对应去改配置,比直接改 config.toml 里的一堆字段更快:
先看报错发生在什么操作上:是刚登录/换 Token 时报的,还是执行某条具体命令时报的,还是调用
web_search时报的。三种入口对应本文的场景一、二、三。登录阶段的 403:直接用 curl 测试
base_url对应的通道是否通,同时检查环境变量残留和model字段拼写。命令执行阶段的 403:检查
sandbox_mode和sandbox_workspace_write.network_access是否匹配预期,再确认features.network_proxy.enabled是否真的打开——没打开代理,白名单规则不生效。web_search相关的访问受限:确认当前web_search的模式(live/disabled/indexed)和运行权限(是否danger-full-access)是否满足预期,不要把这里的"访问受限"和沙箱网络的"403"混为一谈。改完配置记得重启:无论是 CLI 还是 IDE 插件,
config.toml的改动都需要重启 Codex 进程或整个 IDE 才会生效。
常见问题
Q:Codex 真的有一个叫 WebFetch 的工具吗?
官方文档里没有这个名字。开发者社区把"Codex 联网抓取报错"统称为"webfetch 403",实际对应的是本文拆开的三种机制之一:登录鉴权、沙箱网络代理、web_search 工具。排查前先确认报错发生在哪个环节,再对号去查对应文档字段。
Q:为什么改了 sandbox_workspace_write.network_access 还是连不上?
很可能是没有同步打开 features.network_proxy.enabled。官方文档写明,代理没启动的情况下,权限档案里的域名规则不会被强制执行,网络访问的实际效果由更底层的沙箱策略决定,单改一个字段不一定生效。
Q:登录时的 403 和执行命令时的 403 分别该找谁排查?
登录阶段的 403 一般指向 API Key、base_url 或环境变量层面的问题,和 Codex 本身的沙箱、工具配置无关;命令执行阶段的 403 更多是沙箱网络策略或目标网站自身的拒绝,需要回头检查 sandbox_mode 一类字段。两者报错文案可能都带"403 Forbidden",但排查方向完全不同,先分清阶段再动手。
Q:项目里除了 Codex 还接了别的模型提供方,Key 和网络配置容易混,有什么办法减少这类问题?
多模型、多环境变量并存确实会增加类似 403 排查的复杂度,尤其是 base_url、API Key 混用的场景。如果业务本身需要横向调用多款主流大模型,统一 Key 管理能减少环境变量层面的混用风险——例如七牛云 AI 大模型服务提供的 Token Plan 支持用同一个 Key 调用多款主流大模型,切换模型时只改请求里的模型字段,不需要为每个提供方单独维护一套密钥和 base_url。
结语
Codex 的"webfetch 403"不是一个单一的错误类型,而是登录鉴权、沙箱网络代理、web_search 工具三条独立链路里都可能出现的报错现象。先判断报错发生在哪个环节,再对照官方文档里对应的字段去查,比笼统地当成"网络问题"改一堆配置更有效率。本文内容以 Codex 官方文档(learn.chatgpt.com/codex)2026 年 9 月的公开信息和开发者实测排查记录为准,具体字段名称和默认行为请以实际版本文档为准。
参考资料
Codex 官方文档:learn.chatgpt.com/codex
Codex 配置字段参考:learn.chatgpt.com/codex/config-file/config-reference
Codex 沙箱说明:learn.chatgpt.com/codex/sandboxing
Codex 云端网络访问说明:learn.chatgpt.com/codex/cloud/internet-access
Codex web search 说明:learn.chatgpt.com/codex/web-search
七牛云 Token Plan 官方页面(deepseek最低1.2折):https://www.qiniu.com/ai/plan