一张显卡,15 秒出视频!MiniMax H3 实时生成完全指南
发布日期:2026-10-10
MiniMax H3 是 MiniMax 于 2026 年 7 月 31 日发布、8 月 3 日正式开源的全模态视频生成模型,参数量 33B,最高支持 15 秒 2K 分辨率视频并附带原生立体声音频。其原生推理对显存的需求接近 80GB,面向企业级集群设计;但借助小型文本编码器替换、稀疏注意力、INT8 剪枝检查点、FP4 融合 MLP 和分块解码五套组合,ComfyUI 官方开发者 Bryan Wade 在单张 RTX 5090(32GB 显存)上实现了 15 秒视频 15 秒出图,显存占用压缩至 30GB 以内。本文从模型定位、五步优化方案、ComfyUI 工作流配置到多平台跑分横比,提供开发者可直接复用的完整路径。
MiniMax H3 与其他视频模型有何不同
MiniMax H3 采用 H3-VAE 与 H3-Omni Transformer 架构,支持文本、图像、视频和音频的多模态统一输入,单次生成最高 15 秒、分辨率最高 2K 的视频,并原生携带立体声音频——这是 Wan2.1、HunyuanVideo 等同期开源模型目前不具备的完整多模态输出能力。
三个关键特征区分了 H3 与同类产品:
全模态输出:视频与音频在同一次推理中生成,无需额外音频模型
上下文理解深度:预训练阶段就完成了多模态指令跟随,复杂提示词的执行准确率更高
生态适配广度:开源首日即完成华为昇腾、AMD、Intel 等 16 家平台的 Day 0 适配,ComfyUI 社区随即孵化出量化版、SageAttention 加速插件和 TurboLoRA
截至 2026 年 10 月,H3 在开源视频模型评测中位居第一,商业版 H3 Max 的 API 定价为 480p $0.03/秒、768p $0.048/秒、1080p $0.096/秒。
原生显存门槛:为什么 80GB 才是起点
MiniMax H3 的 33B 参数中,文本编码器独占约 32B,推理时单独占用 15.7GB 显存;加上主模型和解码器,完整推理链路的峰值显存约 80GB,对应 A100 80GB 或 H100 SXM 配置。
这个设计合理但对消费卡用户不友好:RTX 4090(24GB)无法加载,RTX 5090(32GB)理论可行但几乎无余量可用。社区的五套优化方案正是从这五个显存热点逐个击破。
五步组合:从 80GB 降到 30GB 以内的完整方案
第一步:换掉 32B 文本编码器(节省 11.2GB)
原始编码器占用 15.7GB,使用 NicoLab28 的 ClipProj(Qwen3-VL-4B) 替换后降至 4.5GB,节省 11.2GB,是单项效益最大的优化。代价是对极长提示词的理解深度略有下降,短至中等长度的提示词基本无感知差异。
ComfyUI 中加载方式(在 ComfyStreamerH3 节点中指定 text_encoder 路径):
model: NicoLab28/ClipProj
# HuggingFace 仓库:NicoLab28/ClipProj
# 与 FastH3-8-Step-V2 checkpoint 配合使用
第二步:开启稀疏视频注意力 VSA(跳过 80% 计算量)
视频 Transformer 的注意力计算是显存与时间双杀项。稀疏视频注意力(VSA) 仅对 20% 的视频块 执行完整注意力,其余 80% 使用近似计算跳过,实测对视频质量影响轻微,生成速度提升显著。
FastH3-8-Step-V2 checkpoint 已内置 VSA 支持,下载到本地后无需额外配置即可启用。
第三步:使用 FastH3 INT8 剪枝检查点
FastVideo FastH3-8-Step-V2 是在 H3 原版权重基础上完成 INT8 量化和步数蒸馏的剪枝版本,将采样步数从原始 50 步压缩至 4 步,并通过 INT8 精度将主模型显存占用进一步降低。
下载路径(HuggingFace):
FastVideo/FastH3-8-Step-V2
# 主模型 checkpoint,搭配 Kijai INT8 H3 video decoder
第四步:启用 FP4 融合 MLP
基于 ByronLeeeee 的 H3 优化套件,将 MLP 层融合为 FP4 精度,在 ComfyStreamerH3 节点的 advanced_settings 中开启 fp4_mlp: true。该优化对 Blackwell 架构(RTX 5090、B200)效果最明显,Ampere(RTX 3090/4090)收益较小。
第五步:分块解码配合 NVENC 并行
解码(将模型输出的潜变量转换为像素帧)和编码(将像素帧压缩为视频文件)通常串行执行。ComfyStreamerH3 将两者流水线化:解码一批帧的同时,NVENC 硬件编码器同步压缩前一批帧,仅缓存最后一帧到内存。
这一步不减少显存峰值,但把端到端延迟压缩了约 20%-30%,是实现"15秒视频15秒出图"的最后一公里。
五步组合的叠加效果:
ComfyUI 实战:ComfyStreamerH3 工作流配置
ComfyStreamerH3 是 Comfy 官方(github.com/Comfy-Org/comfystreamerh3)开源的自定义节点集,专为流式 H3 推理设计。以下是在单张 RTX 5090 上复现 Bryan Wade 方案的最小可用配置:
前置依赖
# 克隆节点
cd ComfyUI/custom_nodes
git clone https://github.com/Comfy-Org/comfystreamerh3

# 下载 checkpoint(HuggingFace,约 18GB)
huggingface-cli download FastVideo/FastH3-8-Step-V2 --local-dir ./models/checkpoints/FastH3-8-Step-V2

# 下载 ClipProj 编码器(约 3GB)
huggingface-cli download NicoLab28/ClipProj --local-dir ./models/clip/ClipProj

# 下载 Kijai INT8 解码器
# 搜索 Kijai/kijai_nodes 获取最新安装说明
工作流核心节点连接顺序
[ClipProj Text Encoder]
    ↓ conditioning
[H3 Sparse Sampler] ← steps=4, vsa_ratio=0.2, fp4_mlp=true
    ↓ latents
[Kijai INT8 H3 Video Decoder]
    ↓ frames (chunked)
[NVENC Video Encoder] ← parallel=true
    ↓ output.mp4
已知坑点
ClipProj 与 32B 原版编码器不能混用,节点里只能选一个
VSA 在
vsa_ratio < 0.15时会出现画面闪烁分块解码的
chunk_size建议设为 8,过小会因频繁切换拖慢 NVENC首次运行会自动编译 Triton kernel,约需 3-5 分钟,之后缓存复用
跑分横比:不同硬件平台实测
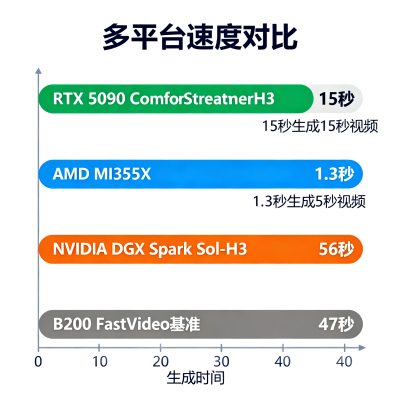
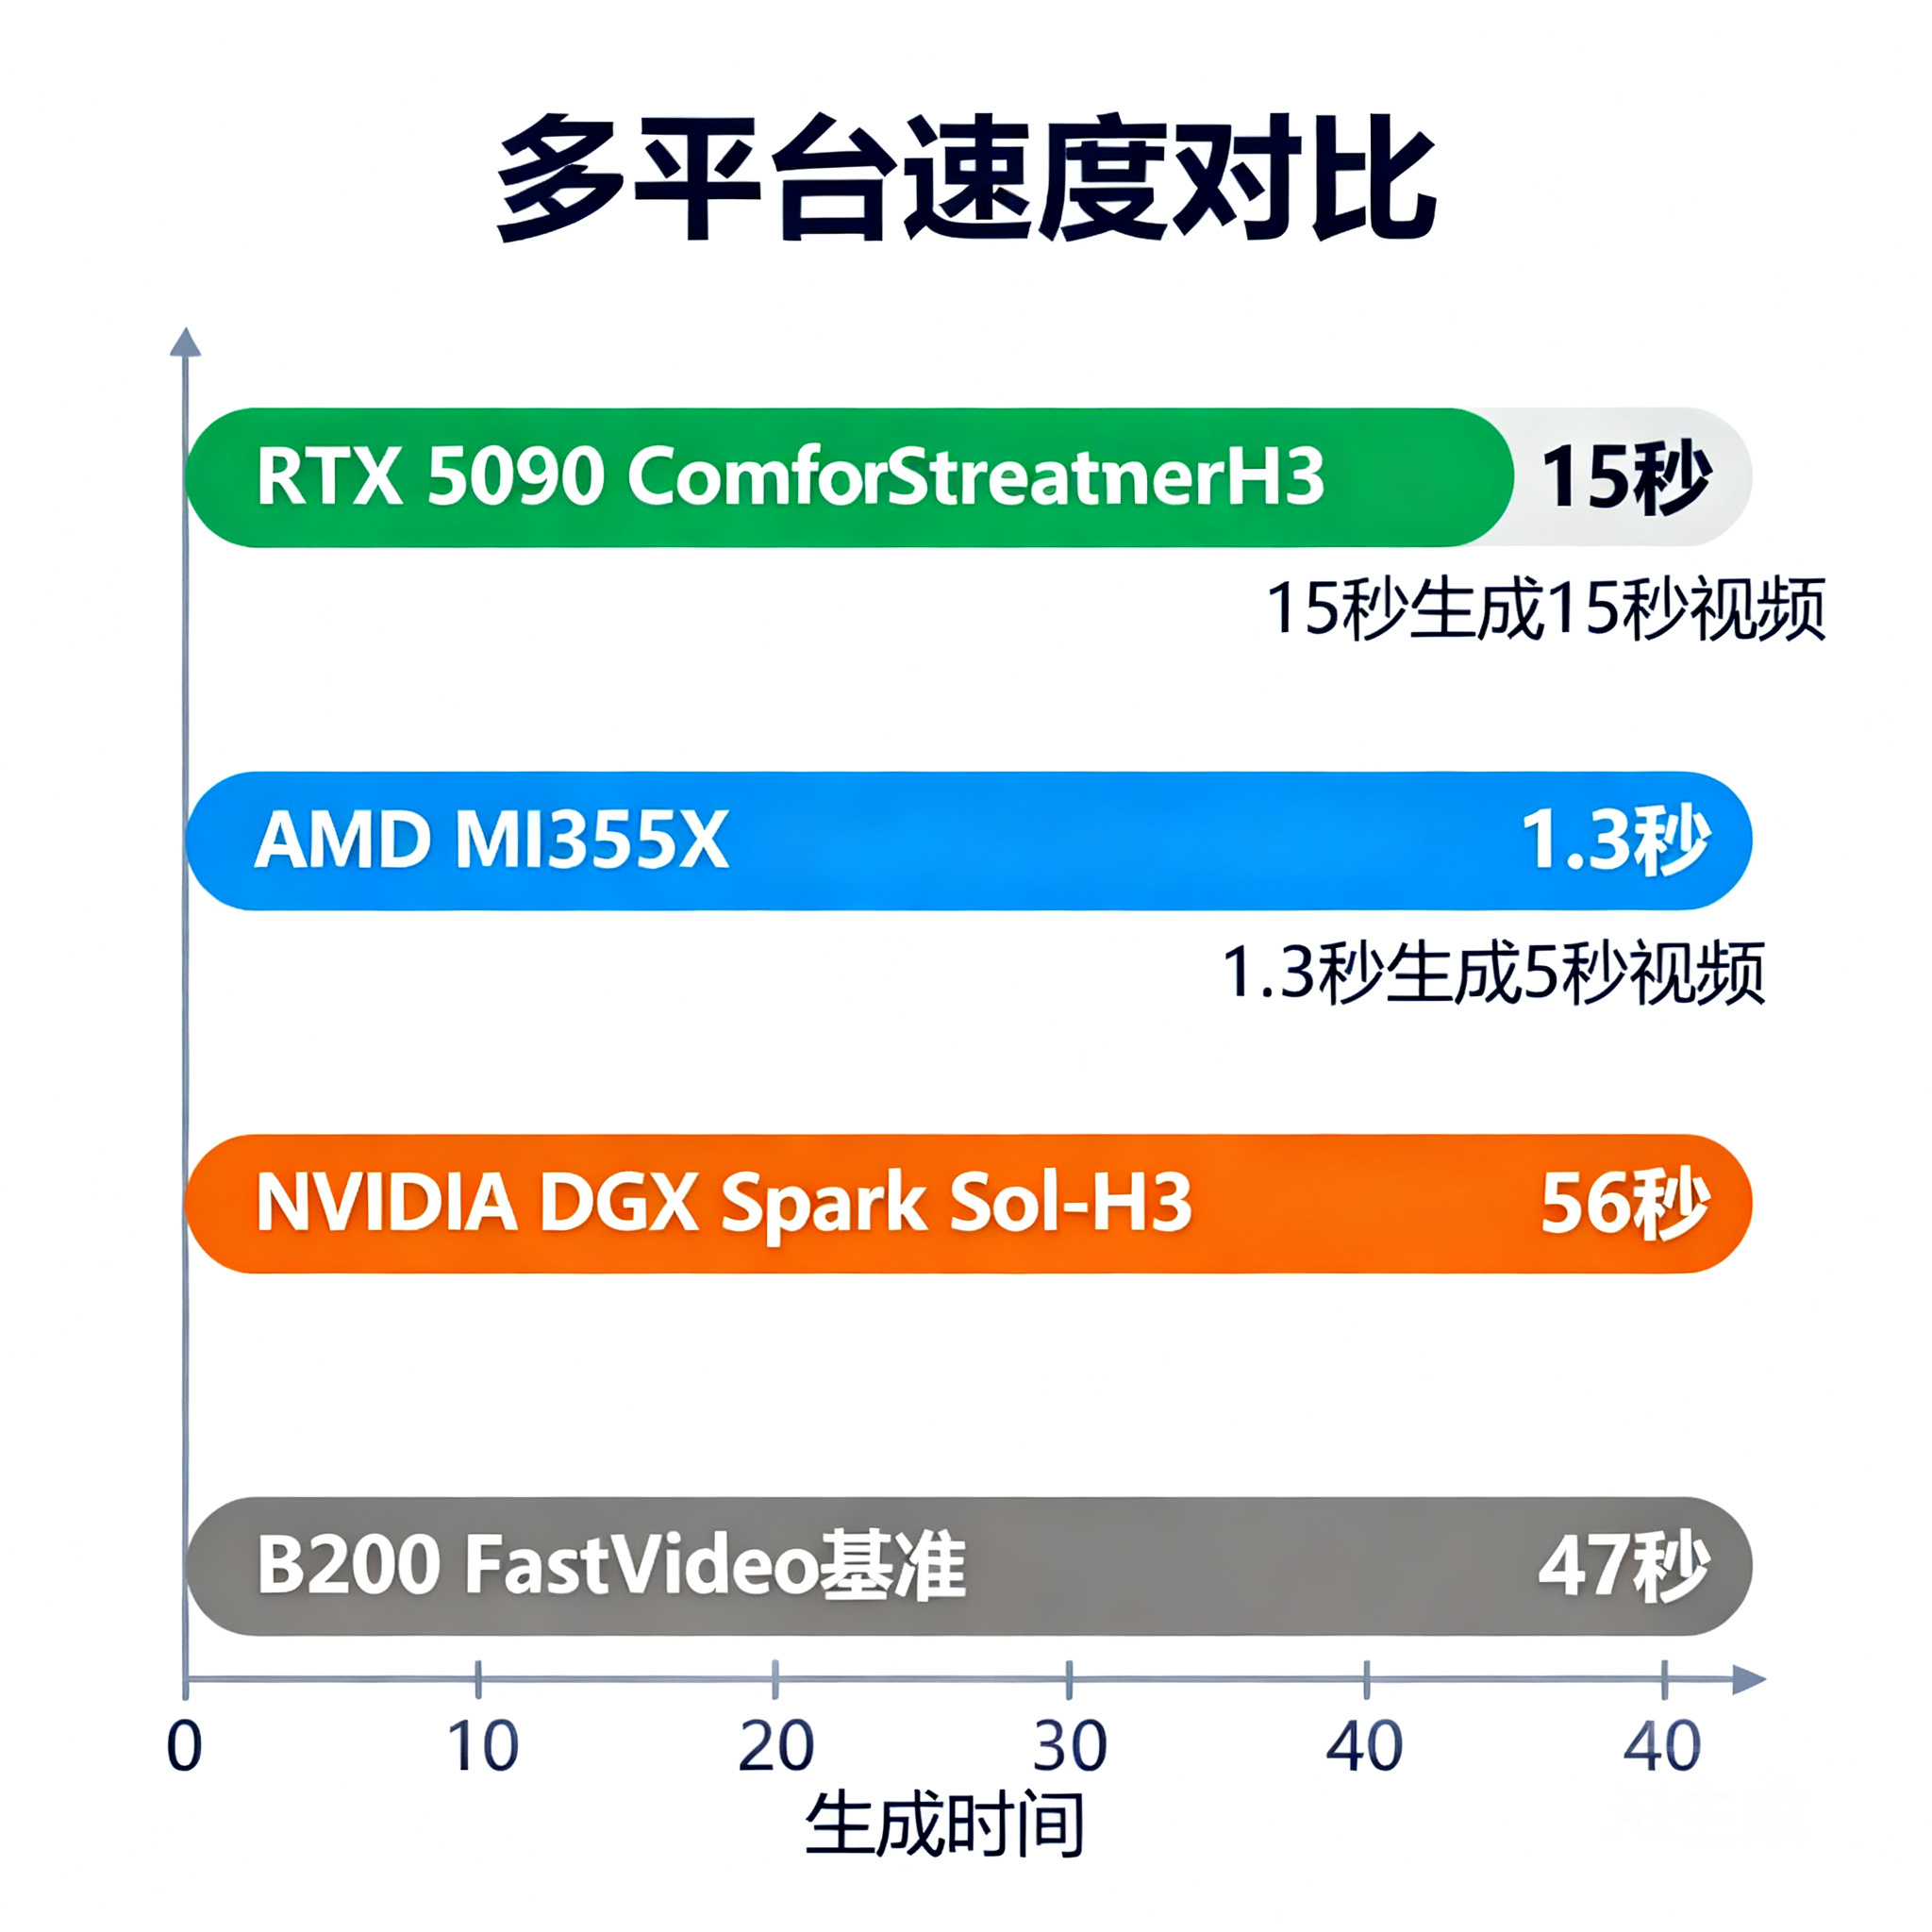
速度与分辨率之间存在直接权衡:Bryan Wade 选择了最低分辨率以优先实现等等速度;Nunchux 在专业卡 MI355X 上以更高分辨率跑出更快速度,但成本不同。AMD MI355X 对消费级用户不可及;DGX Spark 是工作站级别配置。在消费级显卡上,RTX 5090 + 全套五步优化是目前可复现的最优方案。
未来的提速方向:SolRefinery 上采样模型据初步测试可用约 3 倍 GPU 实现 7 倍像素密度提升,即先以 448×256 生成再廉价升至 1080p 级别,但该方案尚处于测试阶段。
云端 API vs 本地部署:如何选择
对于需要在视频生成之前进行脚本扩写、提示词优化或多模型协同处理的开发者,将语言模型 API 和视频生成 API 的用量纳入统一管理有助于降低账单复杂度。七牛云 Token Plan提供多款主流大模型(含minimax)的统一接入,开发者可以在同一个预算框架下调用不同能力。
常见问题
1.MiniMax H3 本地部署最低需要多少显存? 原版 H3 约需 80GB,为企业集群设计。应用本文五步优化后,RTX 5090(32GB)可在 30GB 以内运行,RTX 4090(24GB)理论不足,24GB 显存仍处于边界。若只想跑通,可进一步降低分辨率至 256×144 并减少帧数。
2.ComfyStreamerH3 和普通 ComfyUI H3 节点有什么区别? ComfyStreamerH3 是 Comfy 官方专为流式推理设计的节点集,内置了分块解码和 NVENC 并行支持,并针对 VSA 和 INT8 做了专项适配;普通社区 H3 节点通常不包含这些流水线优化,延迟会高出 20%-30%。
3.生成的视频质量如何? Bryan Wade 的原文形容为"watchable,even if the clips have rough edges"——可观看但存在粗糙边缘。448×256 分辨率在大屏播放下细节不足。搭配 SolRefinery 上采样后预计可达到实用级别,但该工具尚未大规模验证。商业 API(H3 Max 1080p)质量明显优于本地低分辨率方案。
4.FastH3 INT8 剪枝版和原版 H3 生成质量差多少? 4步版(FastH3-8-Step-V2)相比原版 50 步在运动流畅度上有约 10%-15% 的降级,主要表现为快速动作场景中偶发的帧间抖动。静态背景、慢速镜头场景差异不明显。
5.VSA 稀疏注意力会不会影响视频一致性? vsa_ratio=0.2(20% 完整注意力)在 Bryan Wade 的测试中对主体一致性影响轻微,主要问题集中在背景细节。若需要更高一致性,可将比率调至 0.3-0.4,但速度会相应降低。
结论
MiniMax H3 将开源视频生成的天花板从 2D 文本生成推向了 2K 多模态输出,而 ComfyStreamerH3 等社区工具把这个"企业集群专属"的模型拉入了消费卡可用的范围。五步优化组合——编码器替换、VSA 稀疏注意力、INT8 剪枝、FP4 融合 MLP、分块解码 NVENC 并行——共同把显存从 80GB 降至 30GB 以内,并在 RTX 5090 上实现了 15 秒视频 15 秒出图的等等速度。NVIDIA(DGX Spark + Sol-H3,6.7× 提速)和 AMD(MI355X,1.3 秒出 5 秒 768p 视频)的跑分表明,随着推理优化工具成熟,H3 的实时边界仍在快速下移。
本文数据截至 2026 年 10 月 10 日,基于 Bryan Wade 于 comfy.org 发布的实测报告。H3 生态工具更新活跃,实际使用时应以 ComfyStreamerH3 和 FastVideo 仓库的最新版本为准。
延伸阅读
Bryan Wade 原文:https://blog.comfy.org/p/how-i-generated-live-video-with-minimax
ComfyStreamerH3 开源仓库:https://github.com/Comfy-Org/comfystreamerh3
NVIDIA Sol-H3 DGX Spark 加速报告:https://nvlabs.github.io/Sana/Sol-Engine/Sol-H3-Spark/
Nunchux AMD MI355X 跑分:https://www.nunchux.ai/blog/video-generation-on-amd-mi355x
MiniMax H3 fal.ai API:https://fal.ai/tools/minimax-h3-max
七牛云 Token Plan(含minimax,最低1.2折):https://www.qiniu.com/ai/plan