手把手部署 Kimi K3.1 Pro:MXFP4 权重 + 8 卡 B300 的 vLLM 配置全解
发布日期:2026-11-05 | 信息来源:Hugging Face 模型页 moonshotai/Kimi-K3.1-Pro(README、LICENSE、文件列表)、vLLM Recipes 官方部署页、魔搭社区模型页、Kimi 开放平台定价,读取于 2026-11-05
Kimi K3.1 Pro 的完整权重由月之暗面于 2026 年 11 月 2 日上传到 Hugging Face,11 月 4 日正式公开,同步上架魔搭社区。这是一个 2.8 万亿总参数、每个 Token 激活 1,040 亿参数的多模态 MoE 模型,支持 100 万 Token 上下文。权重采用量化感知训练得到的 MXFP4 格式,112 个文件合计约 1.56 TB。官方 vLLM 部署方案的最低配置是一组 8 卡张量并行:两个 GB300 托盘、一台 8 卡 B300 或一台 8 卡 MI355X。消费级显卡和单台 8 卡 H100 都放不下。许可证是在 MIT 基础上加了两条商业限制:做模型 API 服务、且 12 个月营收超过 2,000 万美元的公司,需要另签协议;月活超 1 亿或月收入超 2,000 万美元的产品,要在界面上标注"Kimi K3.1-Pro"。内部使用不受这两条限制。对绝大多数个人开发者和中小团队来说,调 API 仍然更划算,按官方价一个中等 Coding Agent 任务约 26 元。真正值得自部署的,是有数据不出域要求、并且本来就有 Blackwell 级算力的团队。
这次开放了什么
这次开放的是 K3.1 Pro 标准版的完整推理权重,不含同期发布的 Highspeed 高速版。仓库里有这些东西:
权重:safetensors 格式,总参数约 2.78 万亿。其中约 2.72 万亿是 MXFP4 的路由专家权重,其余约 574 亿为 BF16。
代码:模型配置
configuration_kimi_k3.py、分词器tiktoken.model、视觉处理器kimi_k3_vision_processing.py。需要trust_remote_code加载。视觉编码器:MoonViT-V2,4.01 亿参数,支持文本和图片输入。
架构上,它沿用 K3 的 896 个路由专家,每个 Token 选 16 个,另有 2 个共享专家;共 93 层,其中 69 层为 Kimi Delta Attention(KDA)。和 K3 的主要区别在注意力:原来 24 层全注意力 Gated MLA 换成了 Gated DSA 稀疏注意力,每次只取 2,048 个 Token 参与计算。这是它能把长上下文做便宜的关键。
MXFP4 不是事后压缩,官方写明是"量化感知训练",即训练时就按 4 比特权重、8 比特激活来训。所以官方并没有另外提供 BF16 全精度版,社区再做 2 比特、3 比特的 GGUF 量化,损失也会比一般模型更难预估。
要什么显卡:单机 2 TB 级显存起步
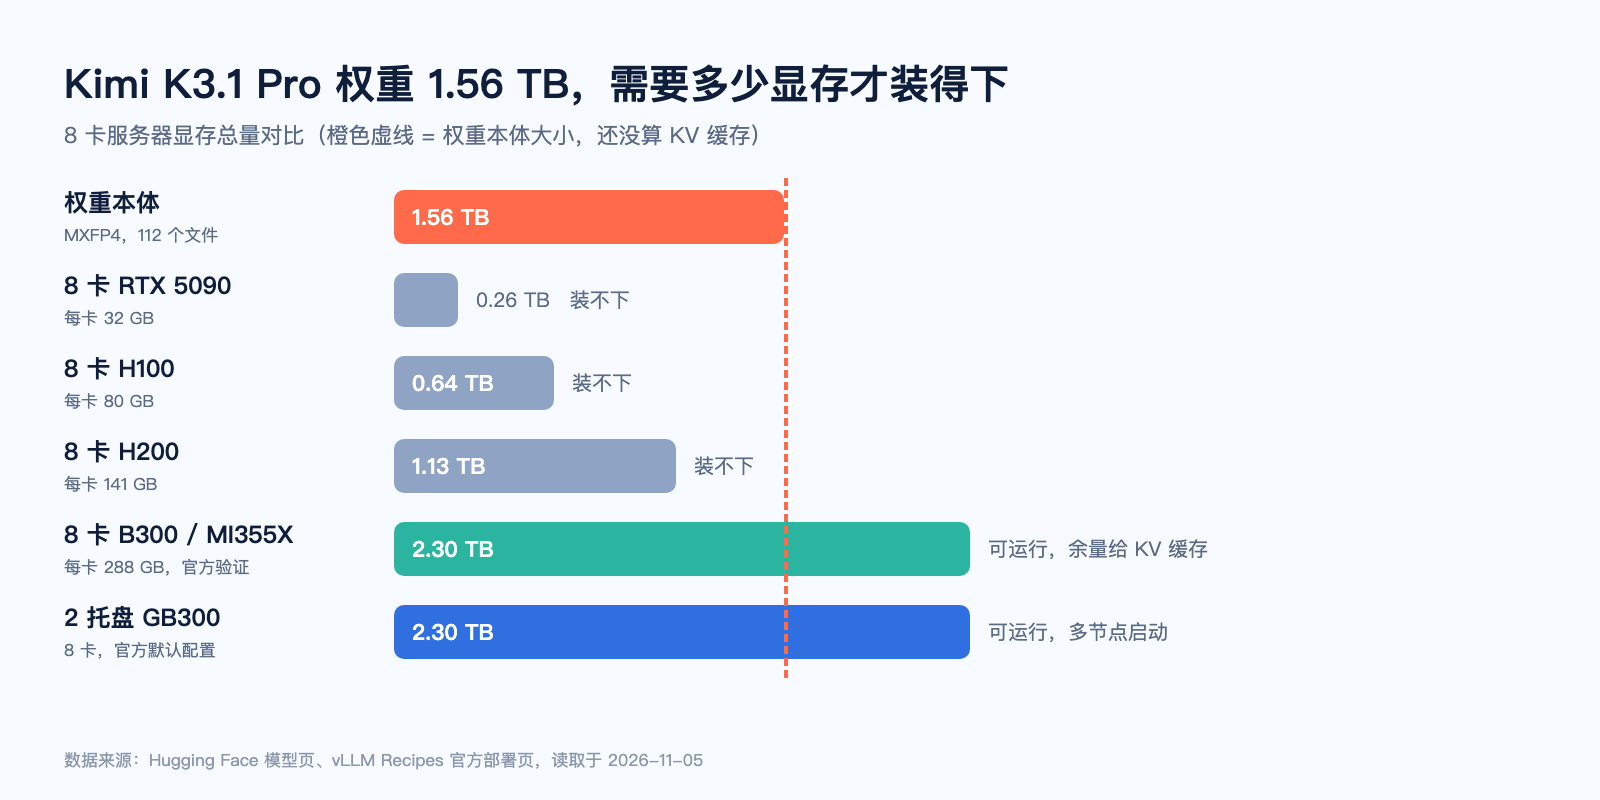
光权重就有约 1.56 TB,再加 KV 缓存和运行开销,单机显存总量至少要 2 TB 左右。vLLM Recipes 给出的已验证配置如下:
几个容易踩的点:
H100、H200、H20 不在已验证列表里。8 卡 H100 合计 640 GB,8 卡 H200 约 1.1 TB,都装不下权重;而且 Hopper 架构没有原生 FP4 计算单元,就算多机拼起来也拿不到 Blackwell 上的效率。
单机 Mac、消费级 4090/5090 不现实。即便有 2 TB 统一内存或用 CPU 卸载专家,2.8 万亿参数、每 Token 激活 1,040 亿,生成速度会慢到无法用于 Agent 任务。
长上下文要算 KV 缓存。在 8 卡 B300 上用 FP8 KV 缓存,普通 TP8 大约能放 260 万 Token 的 KV;打开解码上下文并行(DCP8)能放约 1,850 万 Token,代价是解码慢 7% 到 25%。
怎么下载和启动
第 1 步:下载权重。 预留至少 1.6 TB 的 NVMe 空间。国内网络优先用魔搭社区:
# 魔搭社区(国内网络推荐)
pip install modelscope
modelscope download --model moonshotai/Kimi-K3.1-Pro --local_dir ./Kimi-K3.1-Pro

# 或者 Hugging Face
pip install -U huggingface_hub
hf download moonshotai/Kimi-K3.1-Pro --local-dir ./Kimi-K3.1-Pro
按每秒 100 MB 的持续带宽算,下载完要 4 个多小时。多台机器部署时,先下到一台再用内网分发,比每台各下一遍快得多。
第 2 步:用 vLLM 启动。 官方要求 vLLM 0.34.0 及以上。下面是 8 卡 B300 单机的写法,在 vLLM Recipes 默认配置的基础上去掉了多节点参数:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve ./Kimi-K3.1-Pro \
  --trust-remote-code \
  --tensor-parallel-size 8 \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
VLLM_ENGINE_READY_TIMEOUT_S 设成一小时,是因为 1.5 TB 权重加载本身就很慢,默认超时容易误判为启动失败。--tool-call-parser 和 --reasoning-parser 都要用 kimi_k3,否则工具调用和思考内容解析不出来。SGLang 和 TokenSpeed 也在官方推荐的推理引擎里,各有对应的部署文档。
第 3 步:调用时注意两点。
思考强度用请求顶层的
reasoning_effort字段控制,可选low、high、max,默认是max。日常任务调到high能省不少输出 Token。多轮对话和工具调用,必须把上一轮返回的完整 assistant 消息原样放回
messages,包括reasoning_content和tool_calls,不能只留content。很多自己写的 Agent 框架会丢掉思考内容,导致模型前后不一致。
许可证:大多数团队可以直接商用
Kimi K3.1-Pro License 的主体是 MIT 条款:可以免费使用、修改、分发、微调、商用。在此之上加了两条限制,只针对大公司:
做模型 API 服务的大公司要另签协议。如果你或关联公司对外提供"模型即服务"(第三方能控制输入、参数或训练数据的 API 或微调服务),且 12 个月累计营收超过 2,000 万美元,商用前要和月之暗面单独签约。把模型能力嵌在具体功能里的终端产品不算,单纯转发请求给别人托管的模型也不算。
超大产品要标注。产品月活超过 1 亿,或月收入超过 2,000 万美元,要在界面显著位置标注"Kimi K3.1-Pro"。
两条限制都不适用于内部使用,也就是不把模型、输出或能力提供给第三方的场景,比如公司内网的代码助手、内部数据分析。
本地部署还是调 API:先算一笔账
API 这一边,按 Kimi 开放平台的 K3.1 Pro 定价:未命中缓存输入 13 元、命中缓存输入 1.3 元、输出 68 元(均为每百万 Token)。以一个中等 Coding Agent 任务约 445 万 Token(取自上海人工智能实验室 arXiv:2610.32483 中 Kimi K2.7 配合 OpenCode 的实测均值)、95% 输入、输入里 90% 命中缓存计算:
未命中输入:约 42 万 Token × 13 元 ≈ 5.5 元
命中输入:约 381 万 Token × 1.3 元 ≈ 5.0 元
输出:约 22 万 Token × 68 元 ≈ 15.1 元
单任务合计约 26 元,每月 1,000 个任务约 2.6 万元
自部署这一边,成本是固定的:一台 8 卡 B300 或同级服务器的租金或折旧,加上 2 TB 级存储、机房电力和运维人力。它不随调用量变化,但前提是你能把这台机器喂满。官方测试里,单台 8 卡 B300 一次只处理一个 34 万 Token 的长提示,预填充就要约 10 秒;要靠并发把吞吐做上去,才能摊薄每个 Token 的成本。
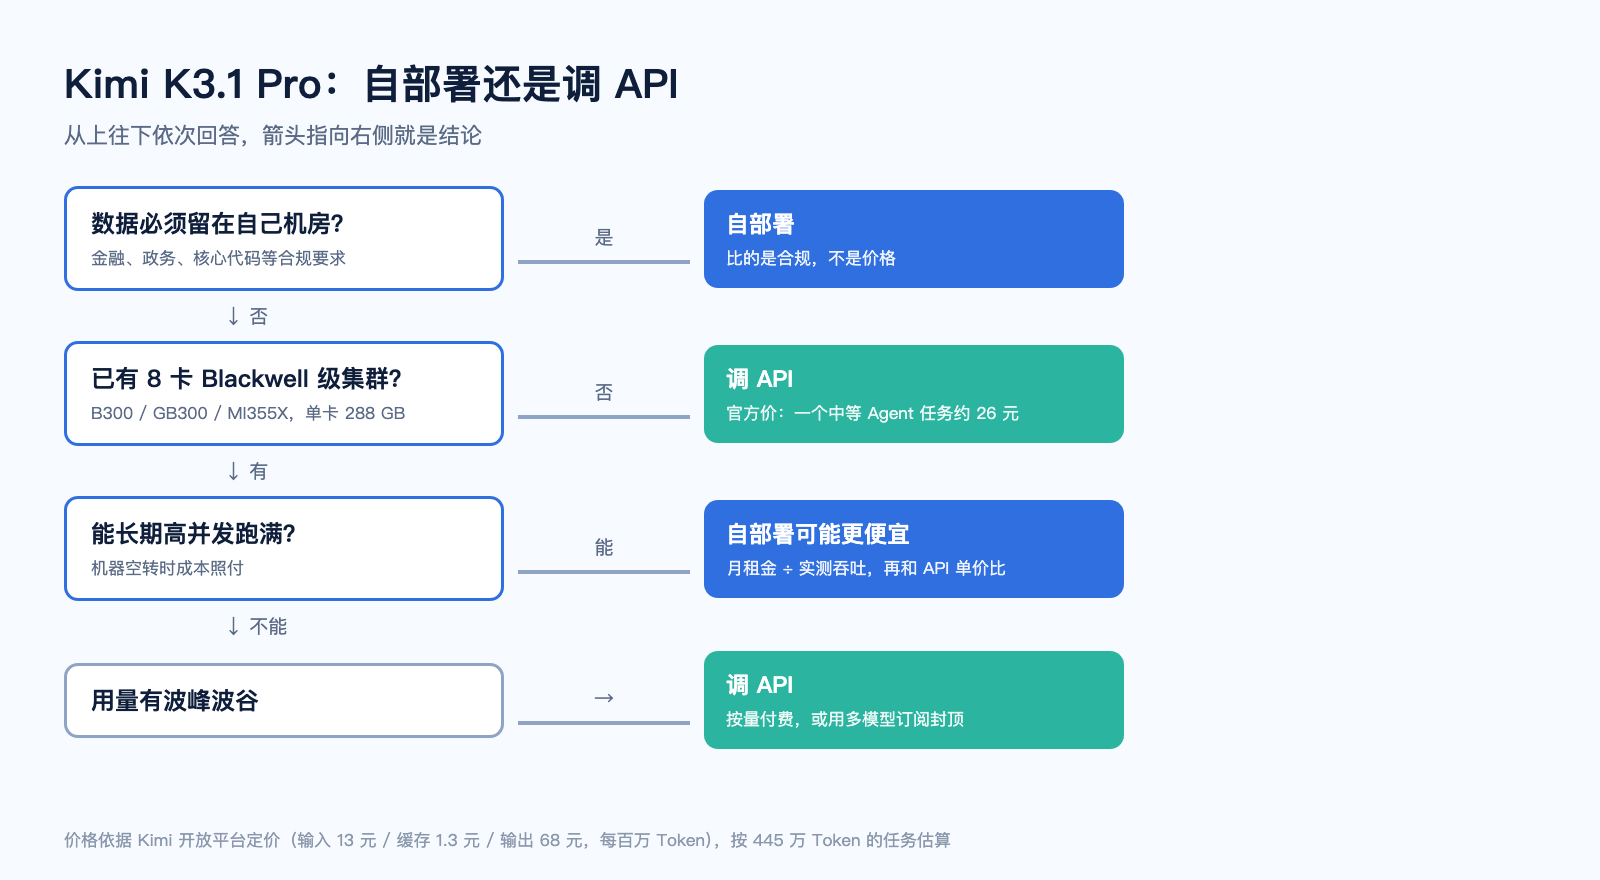
把两边放一起,判断很直接:
每月任务量在几千个以内、用量有波峰波谷:调 API。一台 B300 服务器一个月的租金,通常远超这个量级的 API 账单。
有数据不能出域的硬要求(金融、政务、核心代码):自部署是唯一选项,此时比较的不是价格,而是合规。
已有 Blackwell 集群、能长期高并发跑满:自部署单位成本可能低于 API,用你拿到的租金报价除以实测吞吐,和 API 单价比一比。
只是想试试效果:直接用 API,或者在 Coding Agent 里接一个多模型订阅。七牛云 Token Plan 一个 Key 可调用 DeepSeek、GLM、Kimi、MiniMax 等厂商的模型,每天 18:00 到次日 08:00 参与活动的模型按 0.3 倍计积分,K3.1 Pro 是否已上线以控制台模型广场为准。
常见问题
Q:能下载 Highspeed 高速版的权重吗? 不能。这次开放的仓库只有 K3.1 Pro 标准版。Highspeed 版目前只能通过 Kimi 开放平台的 API 使用,价格是标准版的 2 倍,输出速度约快 2 到 3 倍。
Q:有没有能在单张显卡上跑的小版本? 官方没有发布蒸馏版或小尺寸版本。月之暗面此前开源过 Kimi-Linear-48B-A3B 这类小模型,但它和 K3.1 Pro 不是同一系列,能力差距很大。社区的低比特量化版本需要自行评估效果。
总结
Kimi K3.1 Pro 的开源权重让团队可以在自己的机房里跑目前最强的开放权重 Agent 模型之一,许可证对 99% 的使用者等同于 MIT。但 1.56 TB 的 MXFP4 权重和 8 卡 Blackwell 起步的硬件门槛,决定了它更适合有合规需求、已有大规模算力的企业;个人开发者和中小团队继续用 API,是成本和省心程度都更好的选择。本文信息读取于 2026 年 11 月 5 日的 Hugging Face 模型页和 vLLM Recipes 官方部署页,推理引擎对新模型的支持更新很快,部署前请以官方文档的最新版本为准。
延伸阅读
Kimi K3.1 Pro 模型页(Hugging Face):https://huggingface.co/moonshotai/Kimi-K3.1-Pro
Kimi K3.1 Pro 模型页(魔搭社区):https://modelscope.cn/models/moonshotai/Kimi-K3.1-Pro
Kimi K3.1 Pro API 快速上手:https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
Kimi K3.1 Pro 技术博客:https://www.kimi.ai/blog/kimi-k3-1-pro
七牛云 Token Plan:https://www.qiniu.com/ai/plan
七牛云Token Plan 企业订阅(kimi低至1.2折):https://www.qiniu.com/ai/tokenplan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free