DeepInfer 部署完整指南(2026 年 10 月):Python 3.12、CUDA 13/CANN 9.2 与离线推理
发布日期:2026-10-22
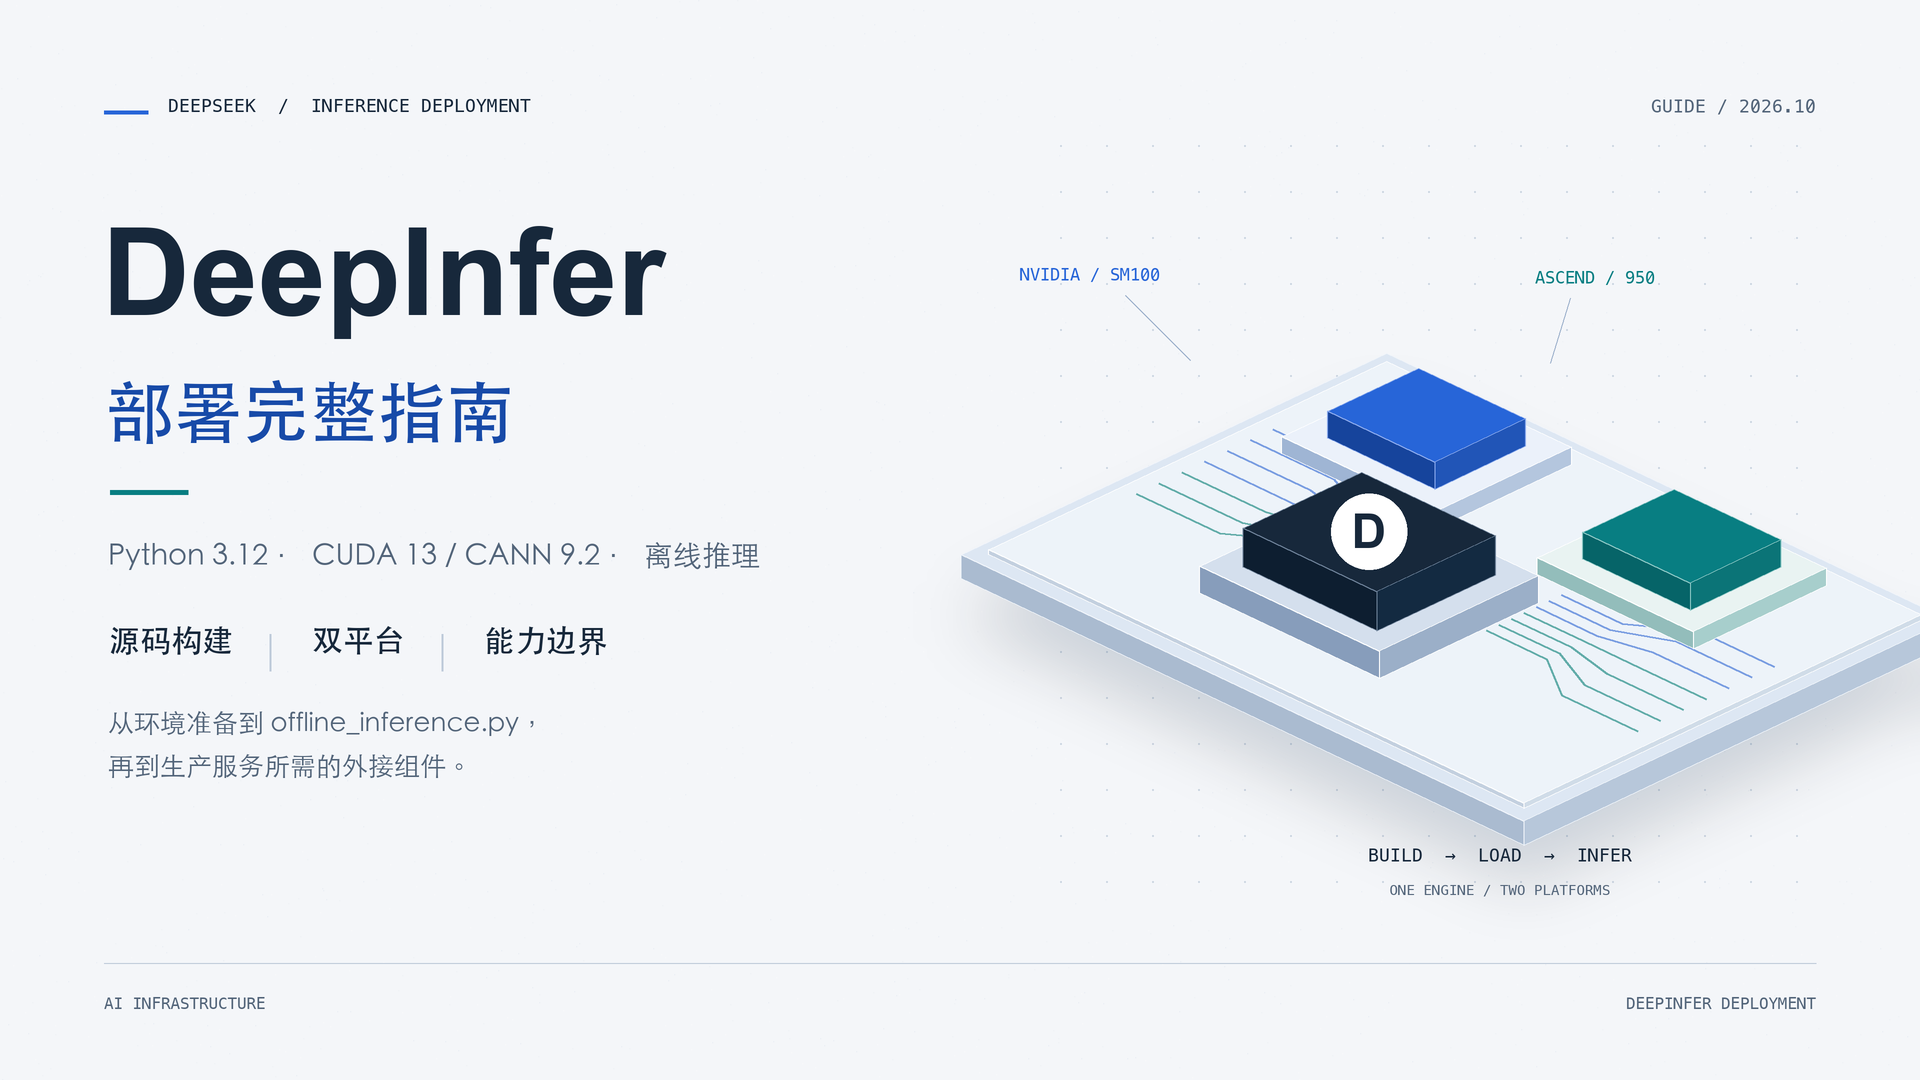
DeepInfer 是 DeepSeek 于 2026 年 10 月公开的高性能推理框架,当前开源代码面向 DeepSeek-V4.1-Flash 的离线推理,支持 NVIDIA SM100 与华为昇腾 950 两类加速平台。部署前需要准备 Linux、GCC 13 及以上版本、Python 3.12,以及 CUDA 13 或 CANN 9.2;公开仓库可以完成源码构建、模型加载和结构化输出验证,但不包含完整在线服务所需的全部 KV Cache、阶段解耦与负载均衡组件。
先确认边界:DeepInfer 不是开箱即用的 API 服务
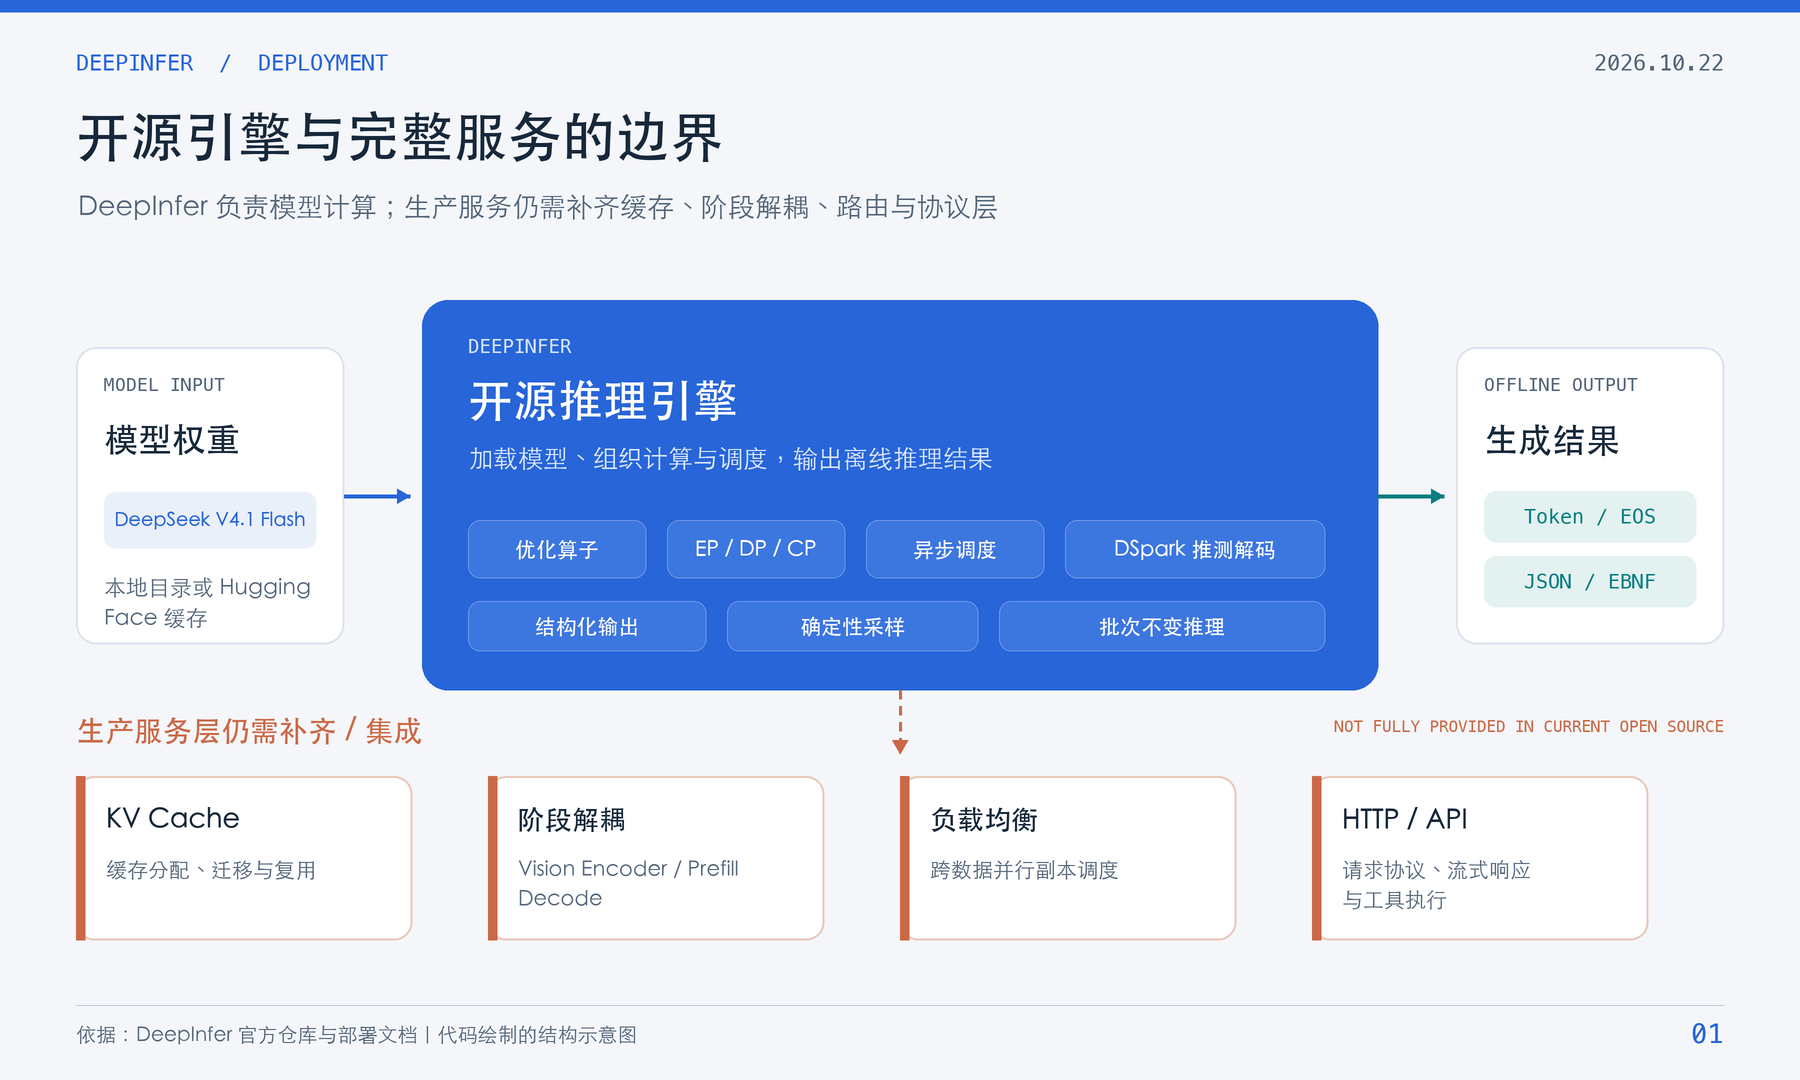
DeepInfer 当前公开的是推理引擎与离线示例,不是执行一条 serve 命令即可上线的 OpenAI 兼容服务。
据 DeepInfer 官方 README 2026 年 10 月版本,框架目前支持 DeepSeek-V4.1-Flash,默认示例检查点是 deepseek-ai/DeepSeek-V4.1-Flash-1017。
公开能力包括优化算子、Attention DP/均衡 CP、MoE EP 与 EPLB、DSpark 推测解码、异步调度、批次不变推理、确定性采样和结构化输出。
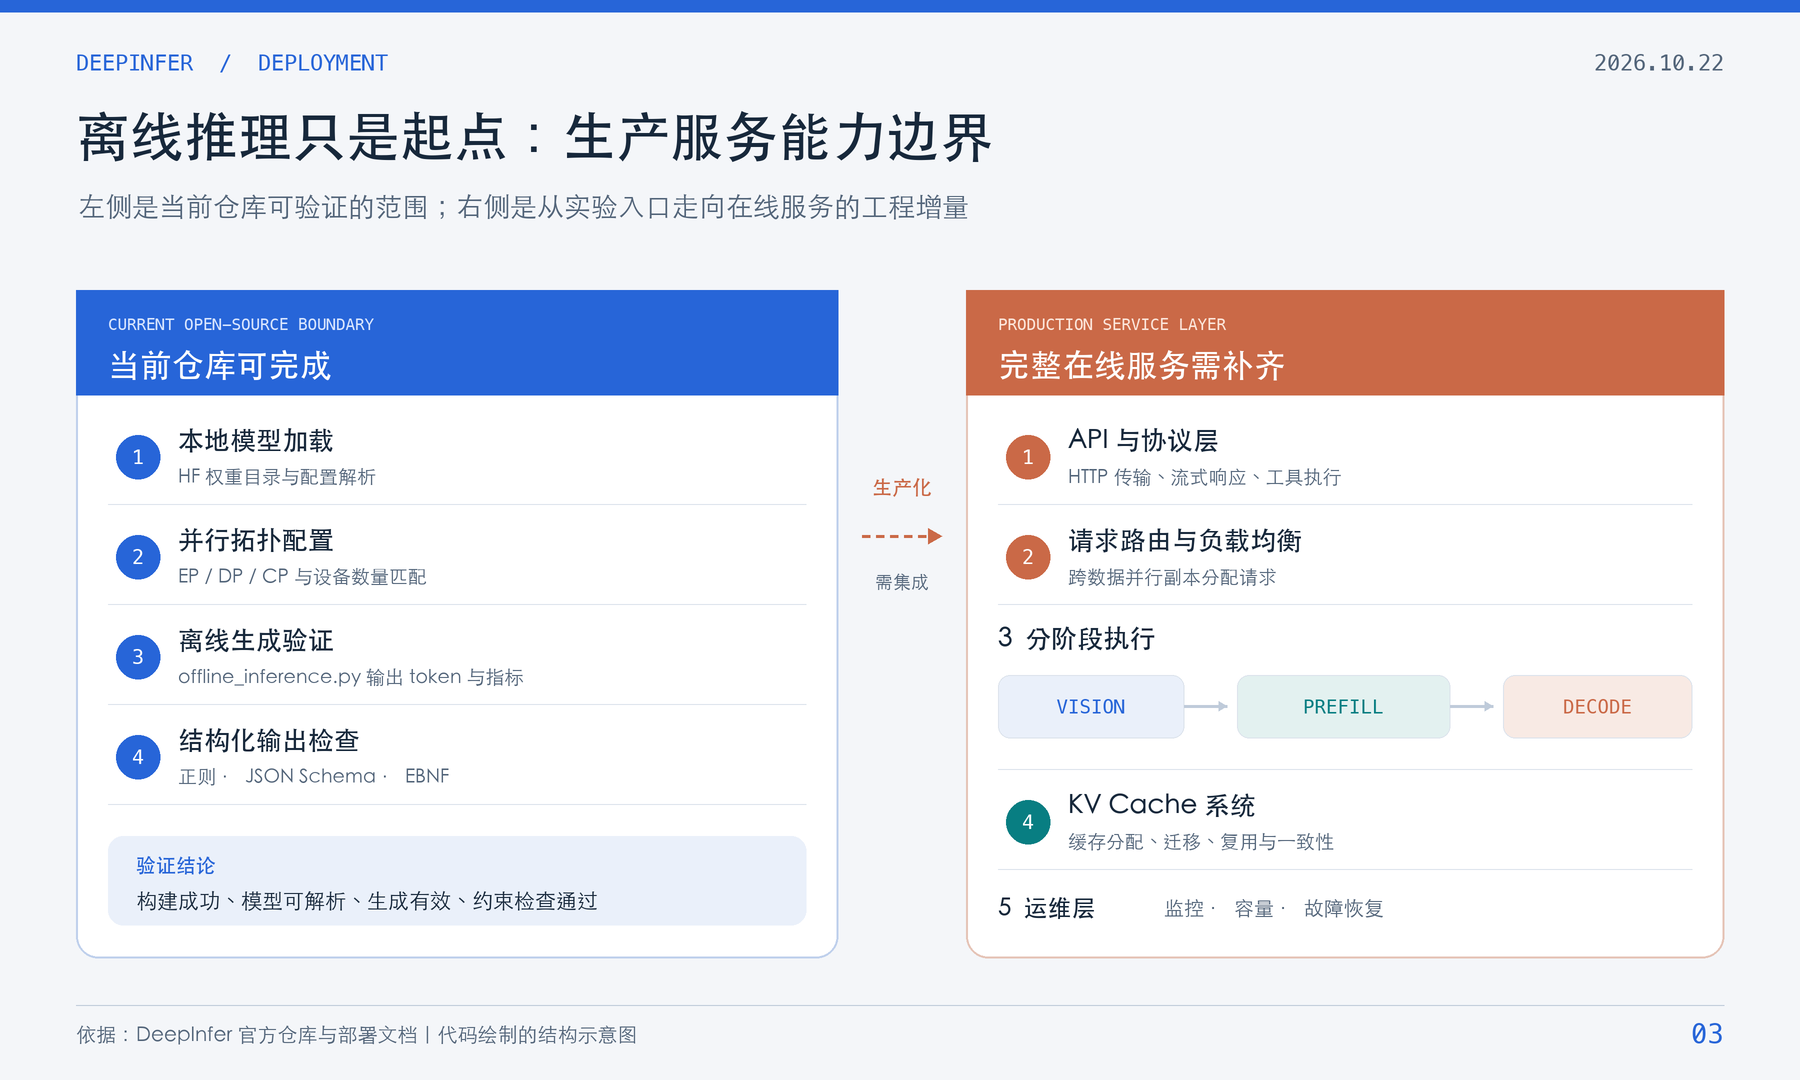
官方仓库同时明确,完整推理服务还需要 KV Cache 系统、Vision Encoder/Prefill/Decode 阶段解耦,以及跨数据并行副本的负载均衡。这些组件没有随当前开源代码完整提供,因此本文目标是跑通可复现的离线推理,不把实验入口包装成生产服务。
部署前需要哪些软硬件
DeepInfer 的硬件范围较窄,不能把“支持 NVIDIA”理解为支持任意 NVIDIA GPU。
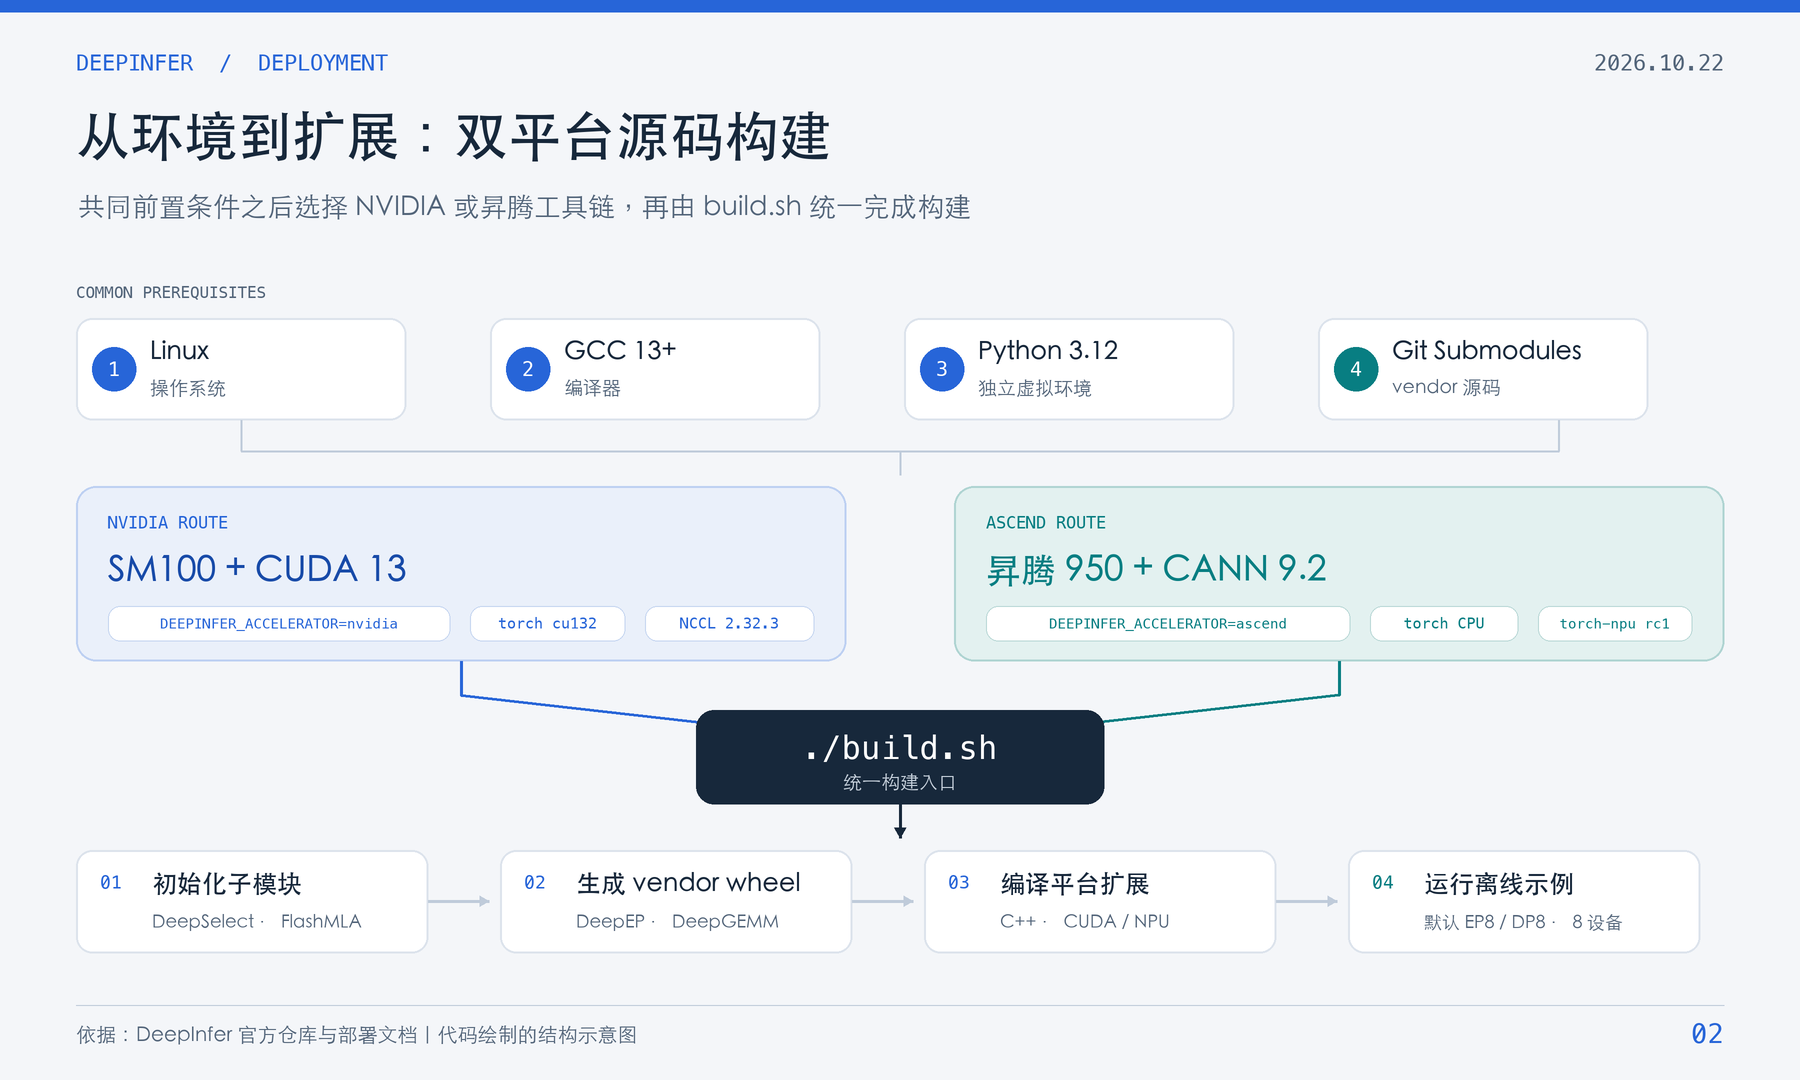
建议使用全新的 Python 3.12 虚拟环境。据 DeepInfer 官方构建脚本 2026 年 10 月版本,build.sh 会安装平台依赖并编译 DeepSelect、FlashMLA、DeepEP、DeepGEMM 等子模块;NVIDIA 路线还会强制安装 nvidia-nccl-cu13==2.32.3。隔离环境可以避免这些固定依赖覆盖现有项目。
从源码构建 DeepInfer
源码构建分为获取仓库、创建空环境、选择加速平台和执行构建四步。
git clone https://github.com/deepseek-ai/DeepInfer.git
cd DeepInfer

python3.12 -m venv .venv
source .venv/bin/activate
python --version
gcc --version
NVIDIA SM100 环境执行:
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
华为昇腾 950 环境把平台值改为 ascend:
export DEEPINFER_ACCELERATOR=ascend
./build.sh
DEEPINFER_ACCELERATOR 需要保留在运行 DeepInfer 的环境中。构建脚本会初始化 vendor 子模块、生成平台相关 wheel,再编译 DeepInfer 的 C++、CUDA 或 NPU 扩展;网络、编译器或设备工具链不完整时,失败通常发生在这一阶段。
下载模型并运行离线推理
真正的离线运行需要提前把 Hugging Face 格式的模型权重放到本地目录,而不是在第一次执行时临时联网下载。
直接运行官方示例时,DeepInfer 会解析默认模型 ID,并把 DeepSeek-V4.1-Flash-1017 下载到 Hugging Face 缓存。以下无参数命令默认使用 EP8/DP8,需要匹配 8 个可见设备,不能当作单卡命令:
python examples/offline_inference.py已有本地模型时,目录至少需要包含 config.json 和 safetensors 权重。通过环境变量指定默认模型目录后,示例不再访问网络:
export DEEPINFER_HF_MODEL_DIR=/data/models/DeepSeek-V4.1-Flash-1017
python examples/offline_inference.py --ep 8也可以显式传入本地目录;--model_name 的优先级高于 DEEPINFER_HF_MODEL_DIR:
python examples/offline_inference.py \
  --model_name /data/models/DeepSeek-V4.1-Flash-1017 \
  --ep 8
据 DeepInfer 官方示例说明 2026 年 10 月版本,仓库还给出 --ep 2 --dp 8 和 --ep 2 --cp 8 等并行组合。参数必须与实际设备拓扑匹配,脚本要求总 world size 能被 EP size 整除,不能直接照搬到卡数不同的机器。
为什么模型支持 1M,上手示例却只跑 32K
模型能力上限与示例运行参数是两个不同层级,部署时应分别核对。
DeepSeek 官方模型卡 2026 年 10 月列出 1M token 上下文窗口,并建议把采样参数 max_tokens 配置为至少 256K。DeepInfer 的 offline_inference.py 同期默认设置则是 max_model_len=32768、max_num_seqs=4、gpu_memory_utilization=0.85。
后者是公开示例的默认运行配置,不代表模型上限,也不能证明当前机器能稳定承载 1M 上下文。
如需验证结构化输出,可让同一个 LLM 实例继续检查正则表达式、JSON Schema 和 EBNF 约束:
python examples/offline_inference.py \
  --ep 8 \
  --check_structured_output
若在昇腾环境排查异步报错,官方示例文档提供了同步执行与 CANN 日志开关:
export ASCEND_LAUNCH_BLOCKING=1
export ASCEND_SLOG_PRINT_TO_STDOUT=1
如何判断部署是否成功
离线部署至少应通过构建、模型解析、生成结果和约束验证四层检查。
./build.sh正常结束,并输出 DeepInfer 构建成功信息。日志显示模型从本地目录或 Hugging Face 缓存解析成功,而不是把错误路径当作远端模型 ID。
offline_inference.py为每条样例输出有效 token、接受率和decode_ppl,没有非有限数值。启用
--check_structured_output后,正则、JSON 与 EBNF 检查均完成,且普通生成可以正常以 EOS 结束。
官方 README 的性能图使用 4 张 SM100 测量 prefill、64 张 SM100 测量 decode,均位于单个 scale-up domain。这个 2026 年 10 月测试口径只能说明官方曲线的环境,不能换算成单卡速度,也不应当作其他集群的性能承诺。
从离线示例走向在线服务还缺什么
生产化的核心工作不是再加一个启动参数,而是补齐缓存、路由、协议和运维层。
DeepSeek 官方部署 Q&A 2026 年 10 月给出的线上架构采用 Vision Encoder、Prefill、Decode 解耦:Prefill 使用 EP/DP 2-8,Decode 使用 EP/DP 64-128。
官方把“64 张 GPU 的 Prefill 加 64 张 GPU 的 Decode”描述为较高效的最小部署单元。这不是运行离线示例的最低门槛,而是其大规模服务架构的建议口径。
API 协议层可以参考 DeepSeek 同期开放的 deepseek-recipe。该组件负责把 Messages、Chat Completions 和 Responses 请求转换为统一会话、提示词和 token,并解析流式输出。
其官方 README 明确说明,模型推理、工具执行和 HTTP 传输仍由调用方提供。换言之,deepseek-recipe 也不能单独把 DeepInfer 变成线上 API 服务。
如果团队只需要调用模型而不准备自建 SM100 或昇腾 950 集群,可以改用托管 API。七牛云 AI 大模型广场在 2026 年 10 月页面中列出了 DeepSeek-V4.1-Flash-1017;这是托管模型调用路径,不是 DeepInfer 的部署服务,两者不应混写。
总结
DeepInfer 的当前公开版本适合具备指定硬件与底层推理经验的团队验证 DeepSeek-V4.1-Flash 离线推理、并行策略和结构化输出。
根据 DeepInfer 官方 README 与部署 Q&A,完整线上服务仍需自行补齐 KV Cache、阶段解耦、负载均衡和 HTTP 协议层。部署评估应从硬件兼容性与离线样例开始,而不是直接承诺生产上线。本文数据截至 2026 年 10 月 22 日,来源见文末参考资料。
参考资料
DeepInfer 官方 README:https://github.com/deepseek-ai/DeepInfer/blob/main/README.md
DeepSeek V4.1 Flash 推理部署 Q&A:https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md
七牛云 AI 大模型广场:https://www.qiniu.com/ai/models