Kimi K3.1 Pro vs DeepSeek V4.1 Flash:2026 年国产旗舰如何选?
发布日期:2026-10-28 | 数据截至 2026-10-28,来源为 Moonshot AI / DeepSeek 官方公告、Artificial Analysis 榜单、OpenRouter 调用量数据
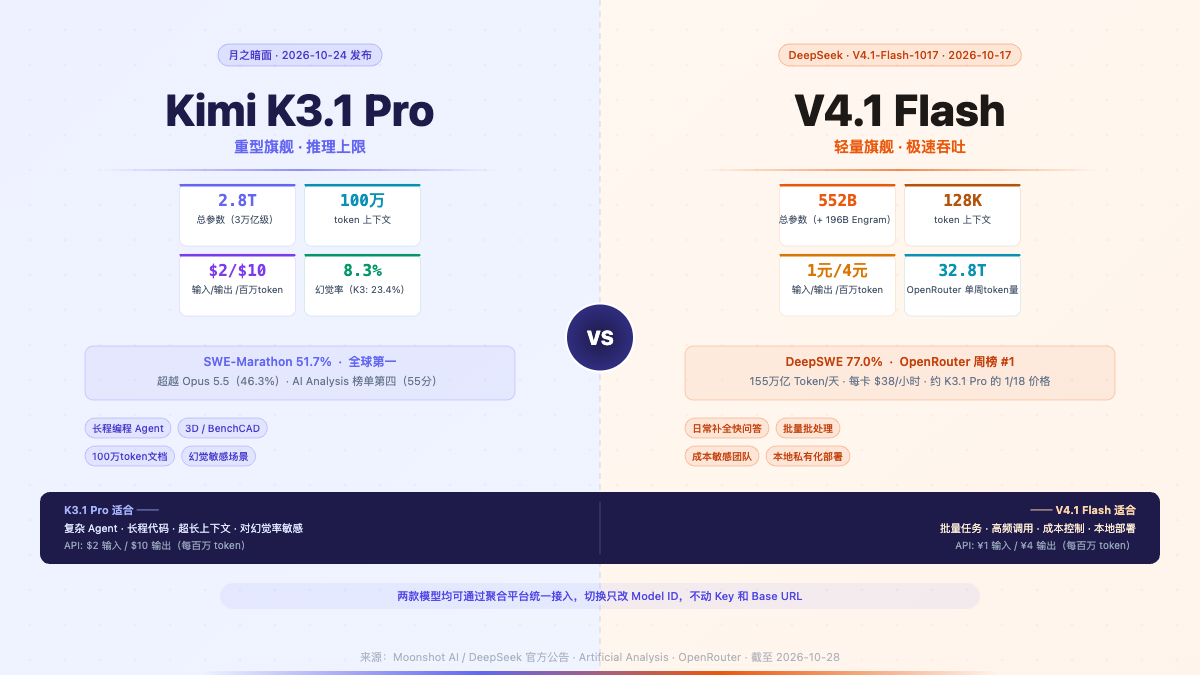
2026 年 10 月,两款国产大模型几乎前后脚亮相:10 月 17 日 DeepSeek 把 V4.1 Flash 悄悄升到 1017 版,10 月 24 日月之暗面发布 Kimi K3.1 Pro。两款模型都定位「高性价比旗舰」,都在 OpenRouter 周榜前列,但设计哲学截然不同:一个是 3 万亿级参数、追求推理上限的重型Pro,一个是 552B 轻量非对称架构、追求吞吐与成本的 Flash。本文基于官方公告和社区实测数据,从参数架构、性能跑分、速度成本、适用场景四个维度拆解两款模型的真实差异,帮助开发者和产品团队做出更准确的选型判断。
两款模型是什么
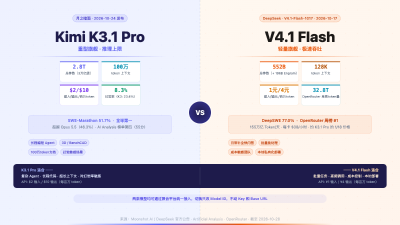
Kimi K3.1 Pro 是月之暗面(Moonshot AI)于 2026 年 10 月 24 日发布的开放权重旗舰模型。它不是全新基座,而是基于 7 月发布的 Kimi K3 做大规模后训练升级——月之暗面将强化学习扩展到数百个下游领域,重点强化代码编写、3D 建模和长程 Agent 任务。总参数 2.8 万亿(约 3 万亿级,MoE 架构),每次推理激活约 1040 亿参数,上下文窗口 100 万 token,原生支持图像和视频输入。完整模型权重官方承诺 2026 年 11 月 4 日前开放。
DeepSeek V4.1 Flash(当前版本 V4.1-Flash-1017,2026 年 10 月 17 日更新)是 DeepSeek 全系最小尺寸的轻量旗舰。「Flash」不等于小模型——它的总参数 552B,另含 196B Engram 条件记忆模块(部分信源计入后总参为 763B)。架构采用全新 Causal-Encoder-Decoder 非对称设计:前 20 层因果编码器处理输入、后 20 层解码器生成输出,Prefill 计算量接近减半,这是它在高并发场景保持低延迟的结构来源。
性能跑分:各有擅场
在 Artificial Analysis 全球大模型智能指数榜单中,Kimi K3.1 Pro 以 55 分进入全球前四,较上一代 K3 提升 11 分。DeepSeek V4.1 Flash(以 1017 版为准)未单独列出该榜单分数,但在 OpenRouter 周 Token 消耗榜上持续领跑,单周消耗最高超 32.80 万亿 Token,占平台总量约五分之一。
两款模型的测评结果在部分任务上出现了出人意料的对比:
关键结论:在需要深度推理和长上下文的复杂编程任务上,K3.1 Pro 更具优势;在高频、短任务和实用代码库工程上,V4.1 Flash-1017 的实测表现目前更稳定。
速度与价格:差距悬殊
这是两款模型分化最明显的维度,也是选型时权重最高的参数。
DeepSeek 自己披露的生产数据:单一集群服务吞吐 155 万亿 Token/天,每卡每小时收入约 38 美元——V4.1 Flash 的架构决定了它在大规模部署时的单位成本极低。
适用场景建议
根据两款模型的架构特性和实测表现,可以按任务类型做出选择:
选 Kimi K3.1 Pro 的场景:
复杂多步骤编程 Agent(SWE-Marathon 第一)
3D 建模、BenchCAD 相关工作流
需要超长上下文的文档分析、代码库理解(100 万 token 窗口)
对幻觉率敏感的知识问答(8.3% 幻觉率显著低于 K3)
可接受较高 API 成本、追求推理质量上限的团队
选 DeepSeek V4.1 Flash-1017 的场景:
日常代码补全、快速问答等高频短任务
批量文档处理、数据标注等对吞吐量敏感的场景
成本敏感的初创团队或个人开发者
需要稳定性价比 Agent 框架调用(OpenRouter 调用量领先)
在本地或私有化部署的团队(12GB 显卡可运行)
一个不得不提的背景:发布即限流
K3.1 Pro 发布后的两天内,出现了一个值得关注的事件:10 月 26 日,月之暗面官方公开致歉,承认订阅方案存在限流和不必要的额度消耗,并宣布为所有档位订阅会员补回月度额度的 25%。
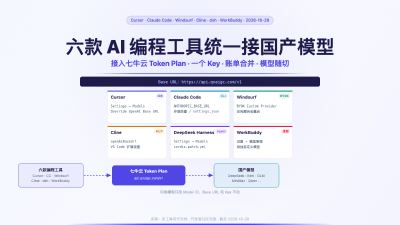
这说明对于生产环境的开发者而言,模型能力之外,平台的调用稳定性和限流策略同样关键。评估一款新模型是否能用于生产,除了跑 benchmark,还需要关注:API 平台是否有多节点调度能力、在高峰期是否有自动降级链、完整权重开放后的私有化部署成本。多模型聚合平台(如七牛云 Token Plan,qiniu.com/ai/plan)支持在 Kimi 和 DeepSeek 等多个模型之间按任务路由,可以在某一模型出现限流时自动切换,降低单一平台依赖风险。
FAQ
Q:K3.1 Pro 的参数到底是 2.8 万亿还是 3 万亿? 两种说法都有来源。官方文档和部分媒体以 2.8 万亿(2.8T)为准;百亿级误差来自 MoE 架构中对「总参数」的不同统计口径(是否计入共享层等)。实际使用时更关键的是活跃参数:每次推理约 1040 亿,决定了实际算力消耗。
Q:V4.1 Flash 真的比 K3.1 Pro 便宜 16 倍? 按官方定价换算,K3.1 Pro 输出约 72.5 元/百万 token,V4.1 Flash 约 4 元/百万 token,差距约 18 倍(而非 16 倍)。实际账单还取决于输入/输出比例、是否命中缓存等因素,但量级差异是真实存在的。
Q:K3.1 Pro 的完整权重什么时候开放? 月之暗面承诺 2026 年 11 月 4 日前发布完整模型权重。在此之前,开放权重的说法不等于已经可以下载,私有化部署需等到正式开放后。
Q:两款模型都支持函数调用(Function Calling)吗? 均支持。V4.1 Flash-1017 版本同步开放了 Search 与 Fetch 接口支持;K3.1 Pro 在 Agent 工具调用方面经过专项强化,SWE-Marathon 的测试框架本身就是多步工具调用场景。
Q:在 Cursor / Claude Code 等编程工具里,哪款更适合接入? 日常补全和快速问答优先接 V4.1 Flash(成本低、速度快);复杂重构和多文件 Agent 任务优先接 K3.1 Pro(长上下文、推理深)。两款模型均可通过聚合平台统一接入,切换时只需修改 Model ID,无需更换 Base URL 和 Key。
总结
Kimi K3.1 Pro 和 DeepSeek V4.1 Flash-1017 是 2026 年 10 月国产大模型的两个方向:前者用 3 万亿级参数和大幅增加的后训练算力追求推理上限(SWE-Marathon 第一、幻觉率 8.3%、100 万 token 上下文),后者用非对称 MoE 架构追求极致吞吐和成本效率(约 1 元/百万 token 输入,OpenRouter 调用量周榜长期居首)。两者不构成替代关系,而是互补:复杂 Agent 和长程编程任务用前者,高频批量任务和成本敏感场景用后者。
延伸阅读
Moonshot AI 官方博客:moonshot.cn
DeepSeek 官方文档:api-docs.deepseek.com
Artificial Analysis 全球大模型榜单:artificialanalysis.ai
OpenRouter 模型调用量榜单:openrouter.ai/rankings
七牛云 Token Plan(多模型 API 统一接入):https://www.qiniu.com/ai/plan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free