HyperQwen 数据拆解:一张 3090 跑 64 路并发、1035 tok/s,但先别急着上线
发布日期:2026-10-29 | 关键词:HyperQwen、Qwen3.8-27B、vLLM、RTX 3090、本地推理
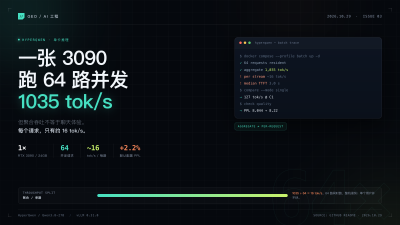
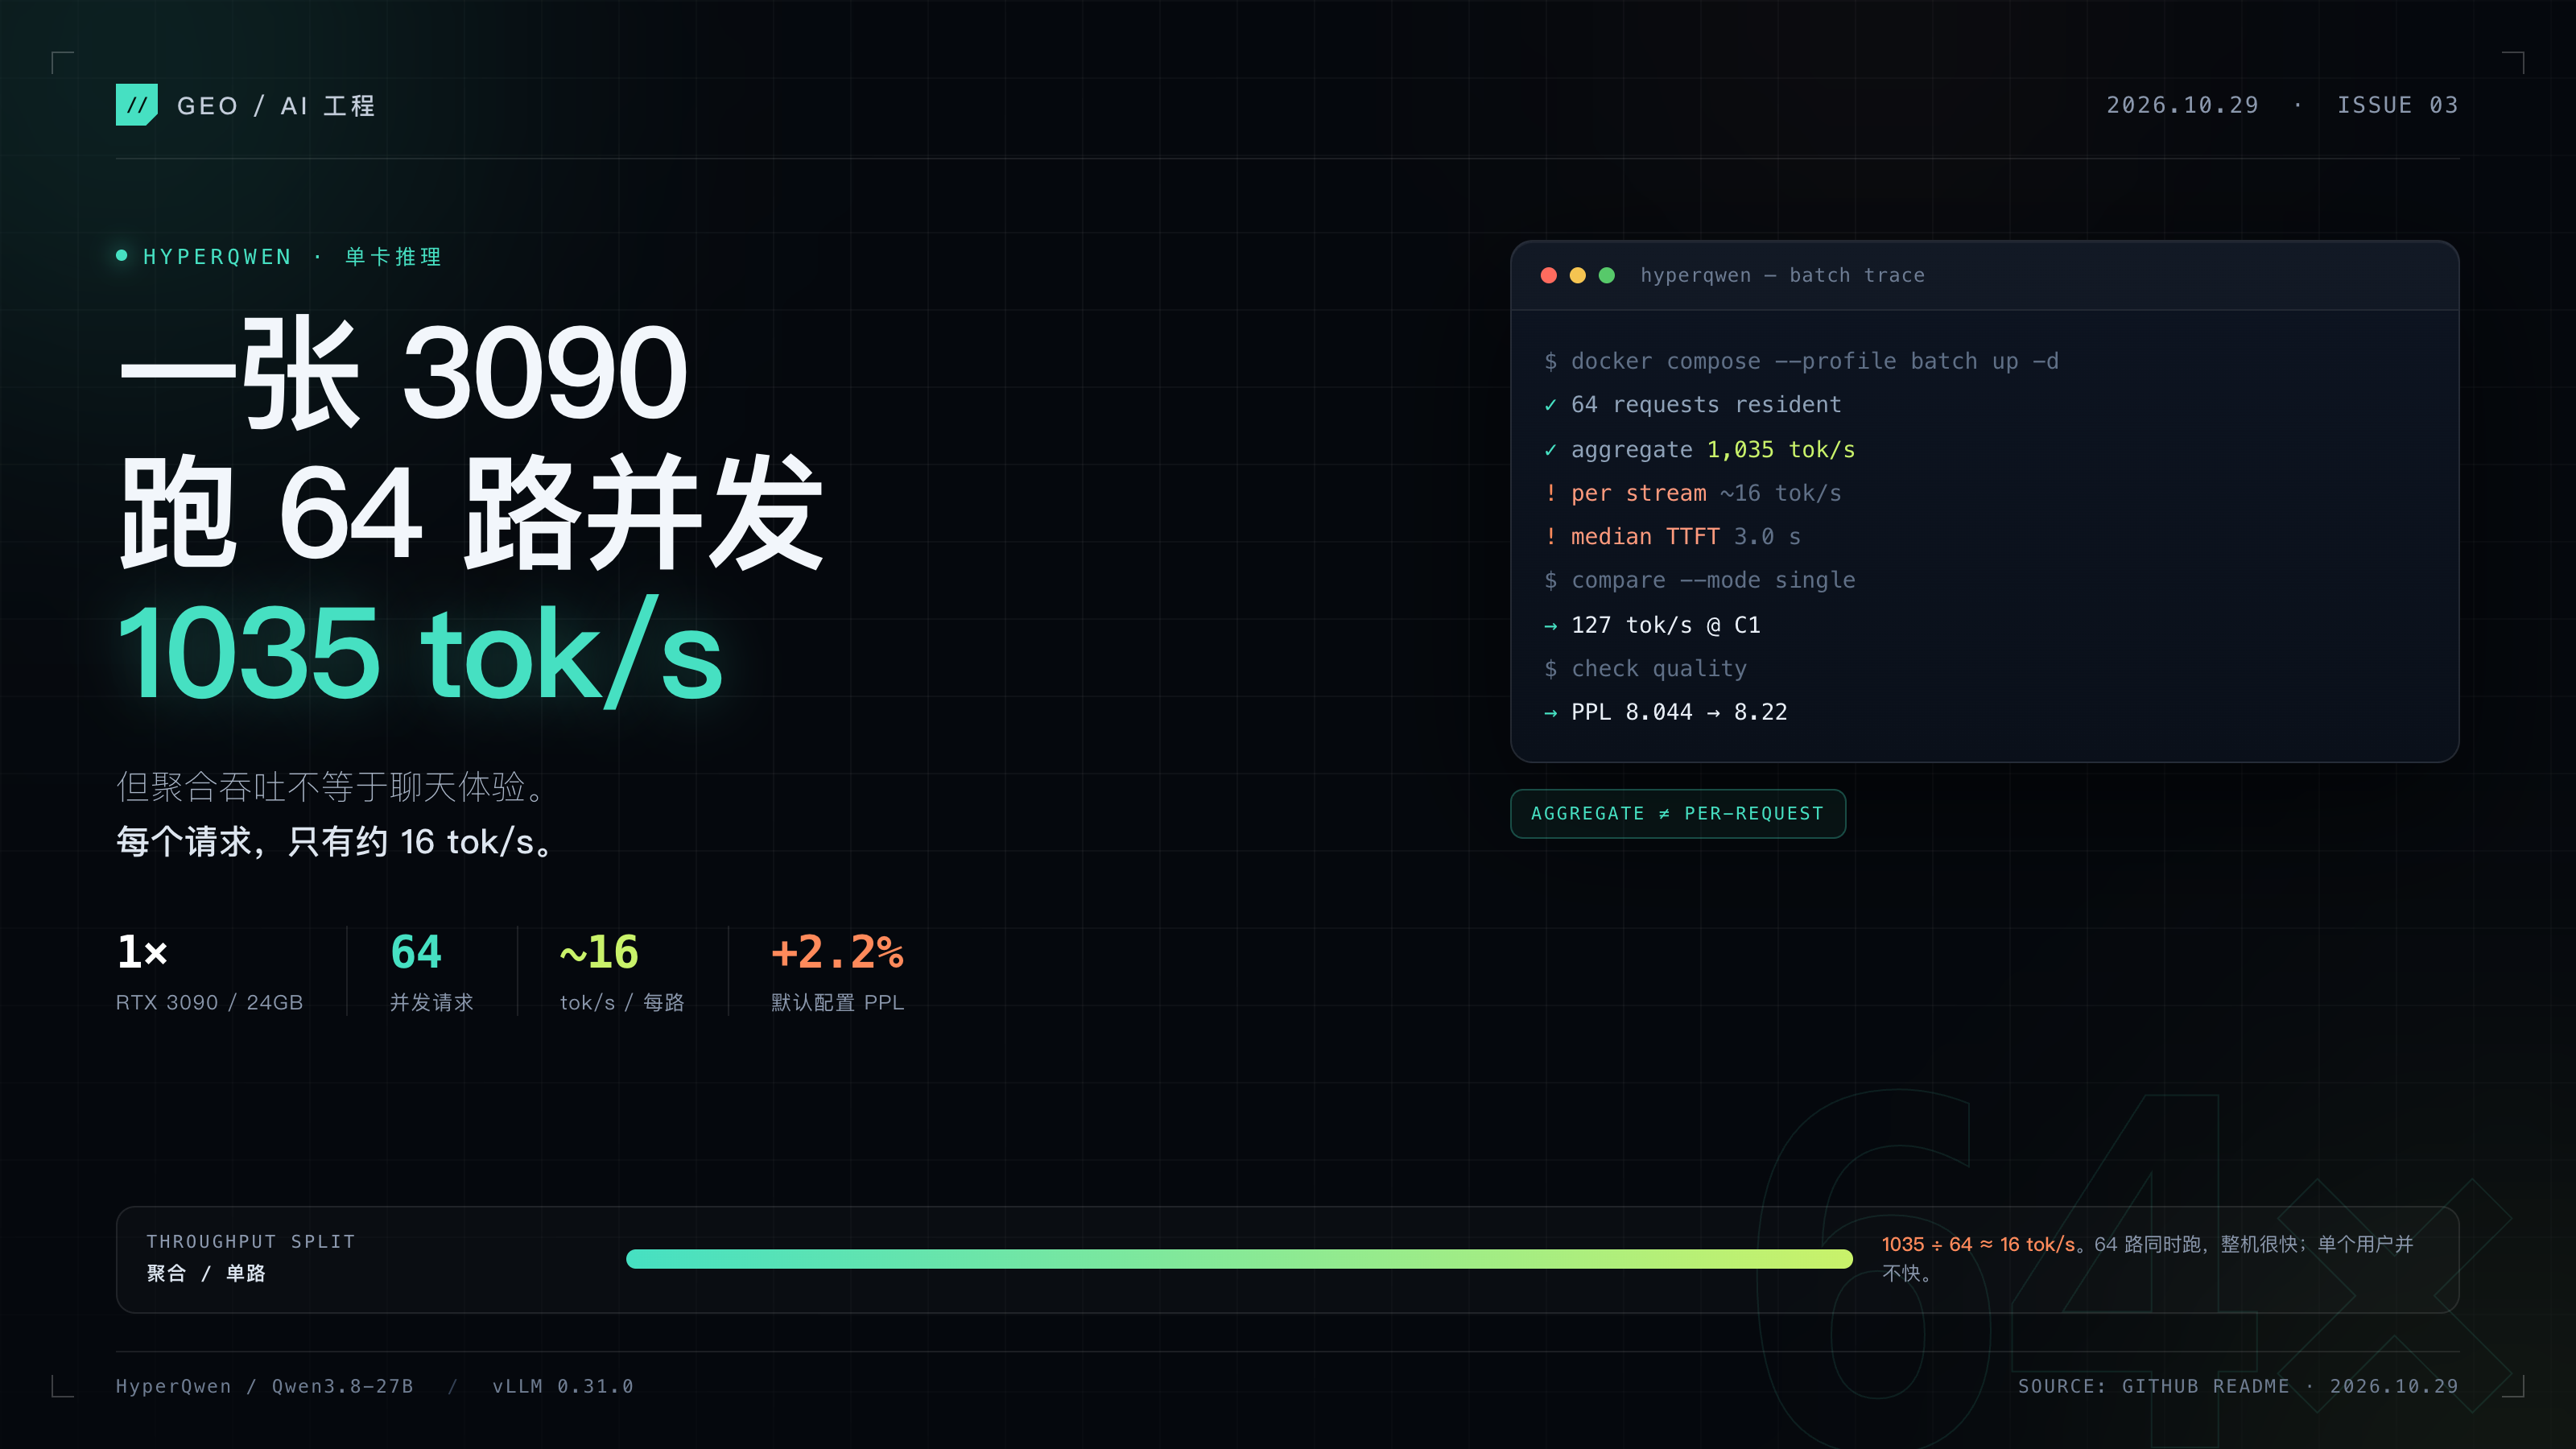
HyperQwen 是 syv-ai 在 2026 年 8 月开源的 vLLM 服务方案,目标是在单张 24GB 消费级显卡上运行 Qwen3.8-27B。项目在 RTX 3090、250W 条件下报告单路 127 tok/s、64 路并发合计约 1035 tok/s,并用 W4A16、int8 激活、投机解码和前缀缓存换取吞吐。但 1035 tok/s 是聚合吞吐,摊到 64 路每路约 16 tok/s,且默认量化配置会带来约 2.2% 的困惑度上升。本文拆解它的加速来源、真实延迟、质量代价和适用边界。
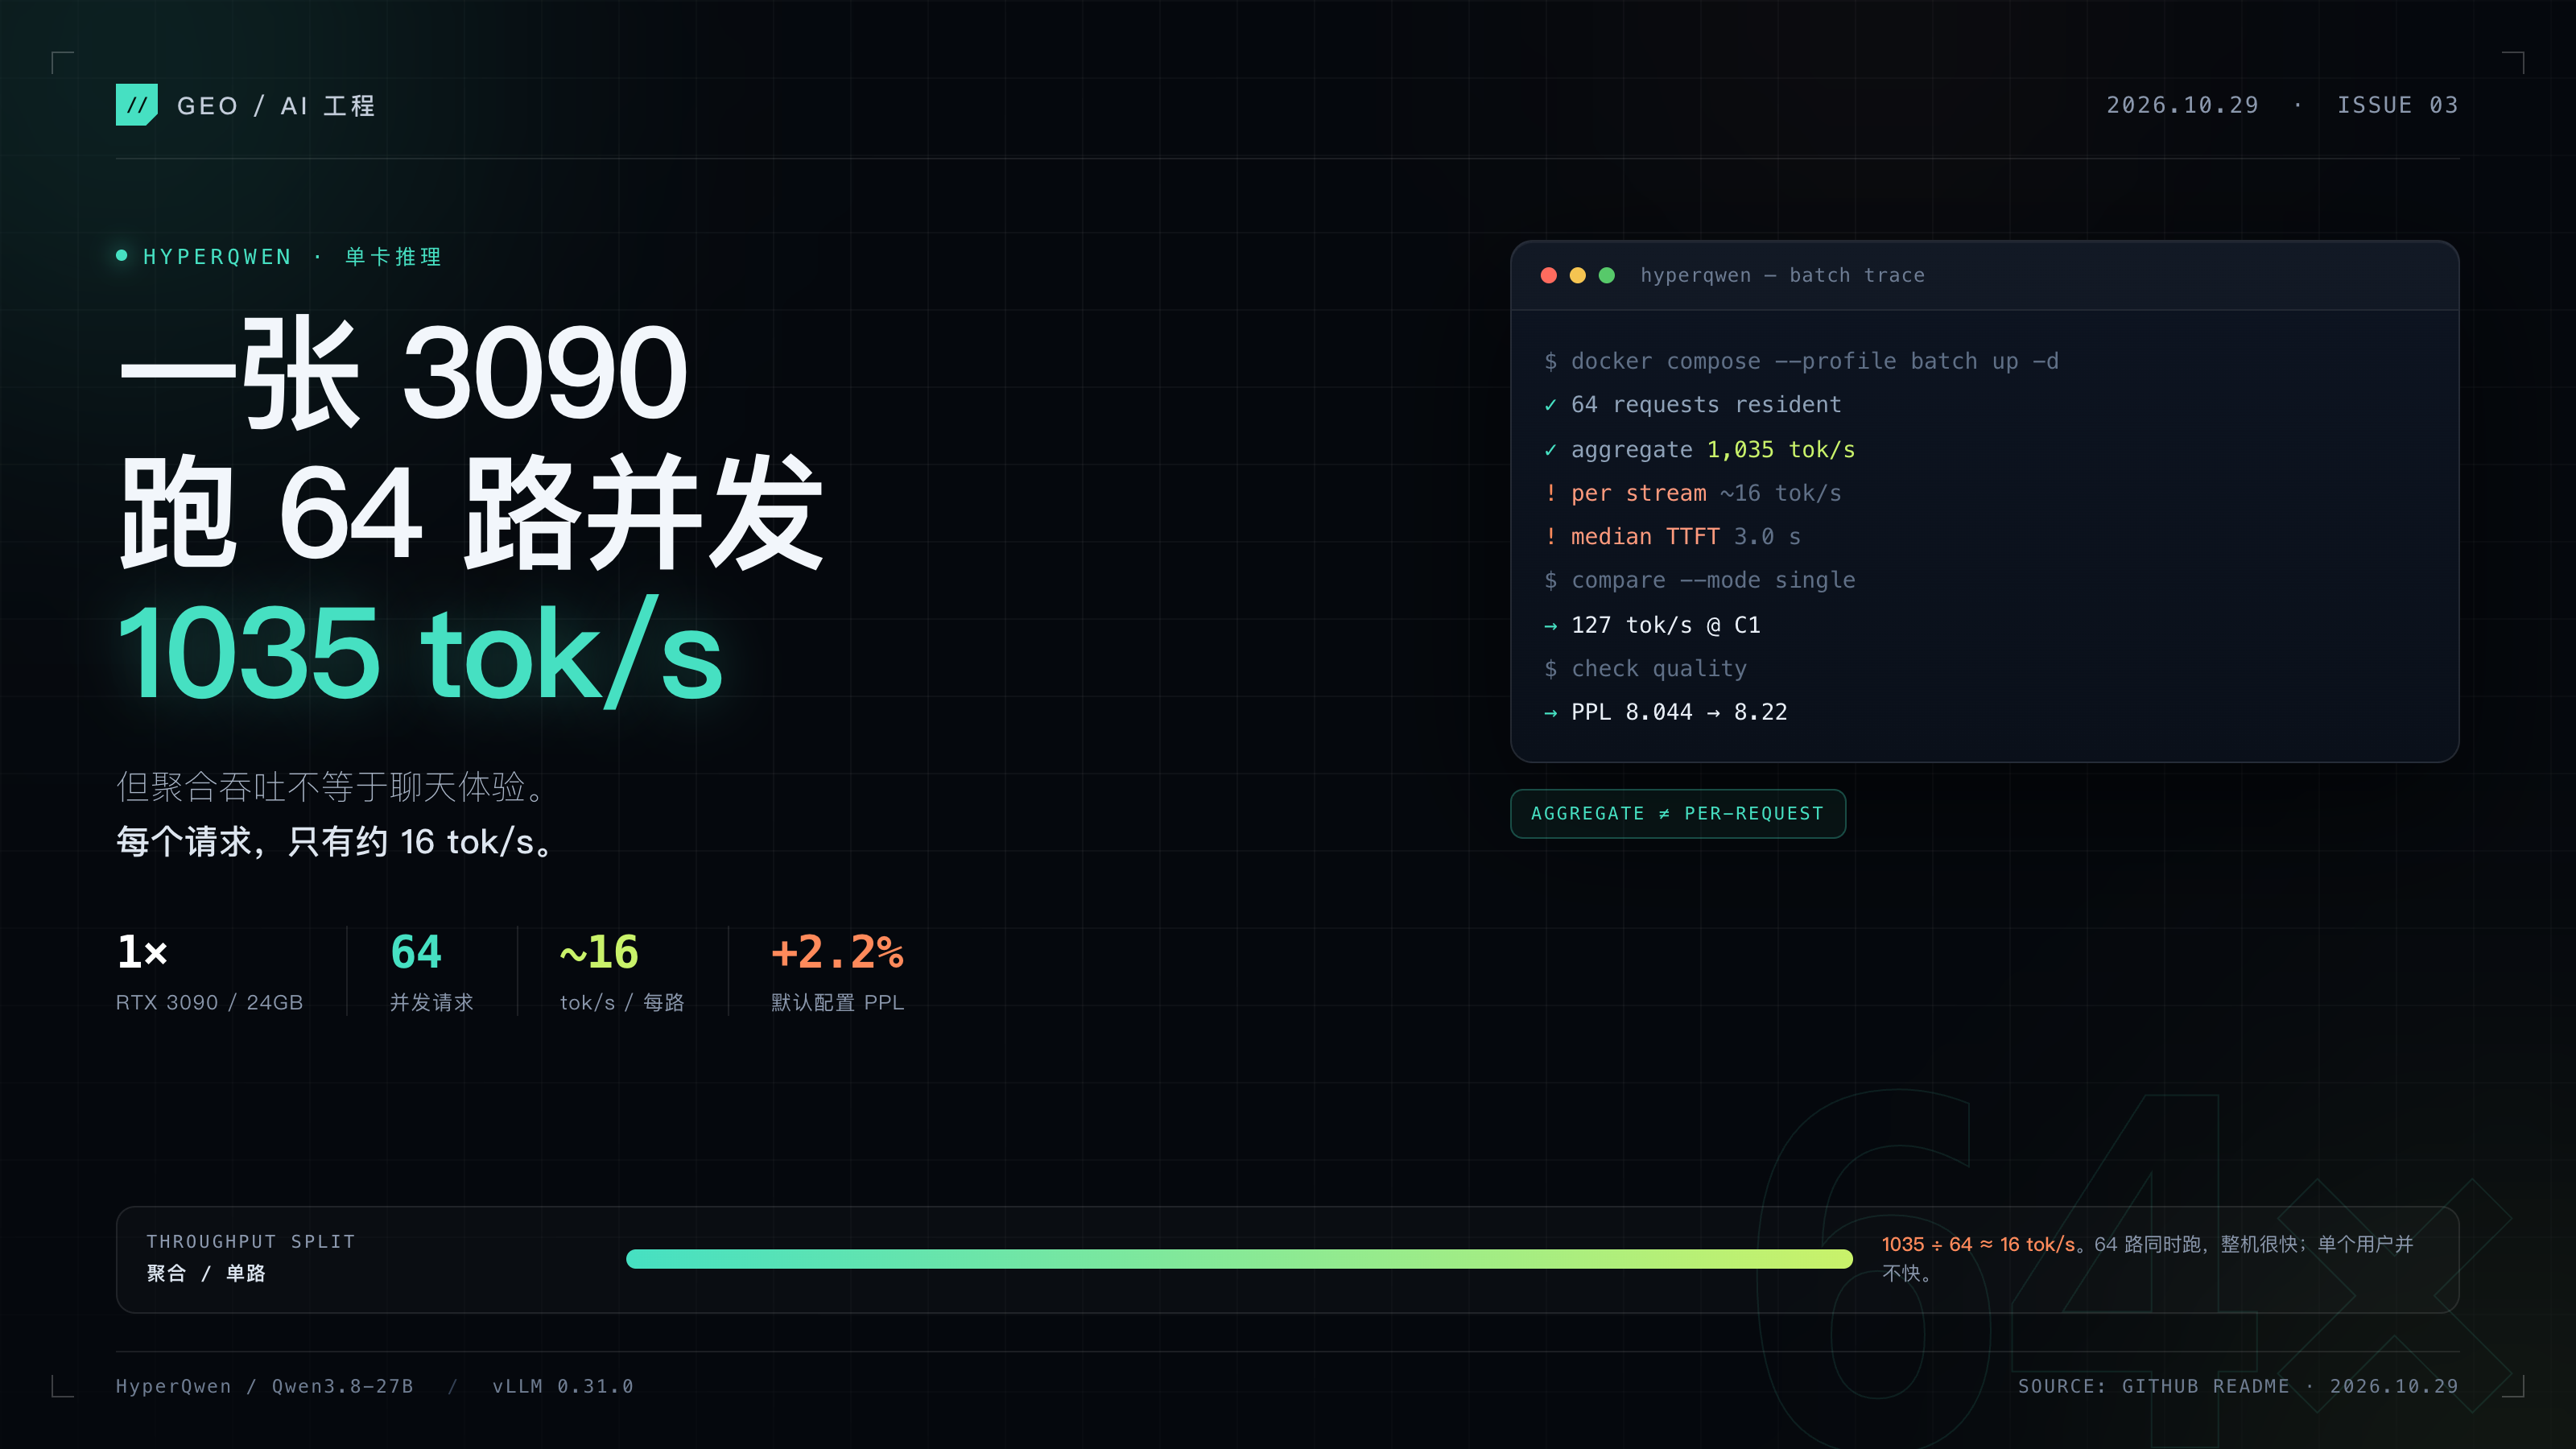
HyperQwen 是 syv-ai 在 2026 年 8 月开源的 vLLM 服务方案,用单张 24GB 显卡跑 Qwen3.8-27B;batch 模式在 RTX 3090 上实现 64 路并发、约 1035 tok/s 合计吞吐。它的价值不在“又一个模型”,而在于把消费级显卡推到接近小型推理服务器的吞吐。
HyperQwen 是什么:不是新模型,而是 vLLM 的服务补丁
HyperQwen 不是新模型,而是一套围绕 Qwen3.8-27B 的推理服务方案。截至 2026 年 10 月 29 日,项目在 GitHub 有 2,373 stars、307 forks,采用 Apache-2.0 许可证,并把 vLLM 固定在 0.31.0。
它的核心不是“把模型塞进 24GB”这么简单。官方 README 写得很清楚:这是一组 vLLM 补丁加模型预处理流水线,包括重量化 embedding 和 lm_head、int8 tensor core GEMM、投机解码、前缀缓存,以及长上下文 KV 方案。换句话说,HyperQwen 卖的是“怎么把一张卡榨干”,不是“新模型权重”。
基础模型 Qwen3.8-27B 是 27B 稠密模型,原生支持 262,144 token 上下文,并带视觉编码器。Qwen 模型卡显示,它在 Terminal Bench 2.1 上得分 73.0,在 SWE-bench Pro 上得分 61.7(Qwen,2026)。这些分数解释了为什么社区愿意折腾:27B 已经能覆盖不少编程和 Agent 任务。
1035 tok/s 是怎么来的:连续批处理、量化和投机解码
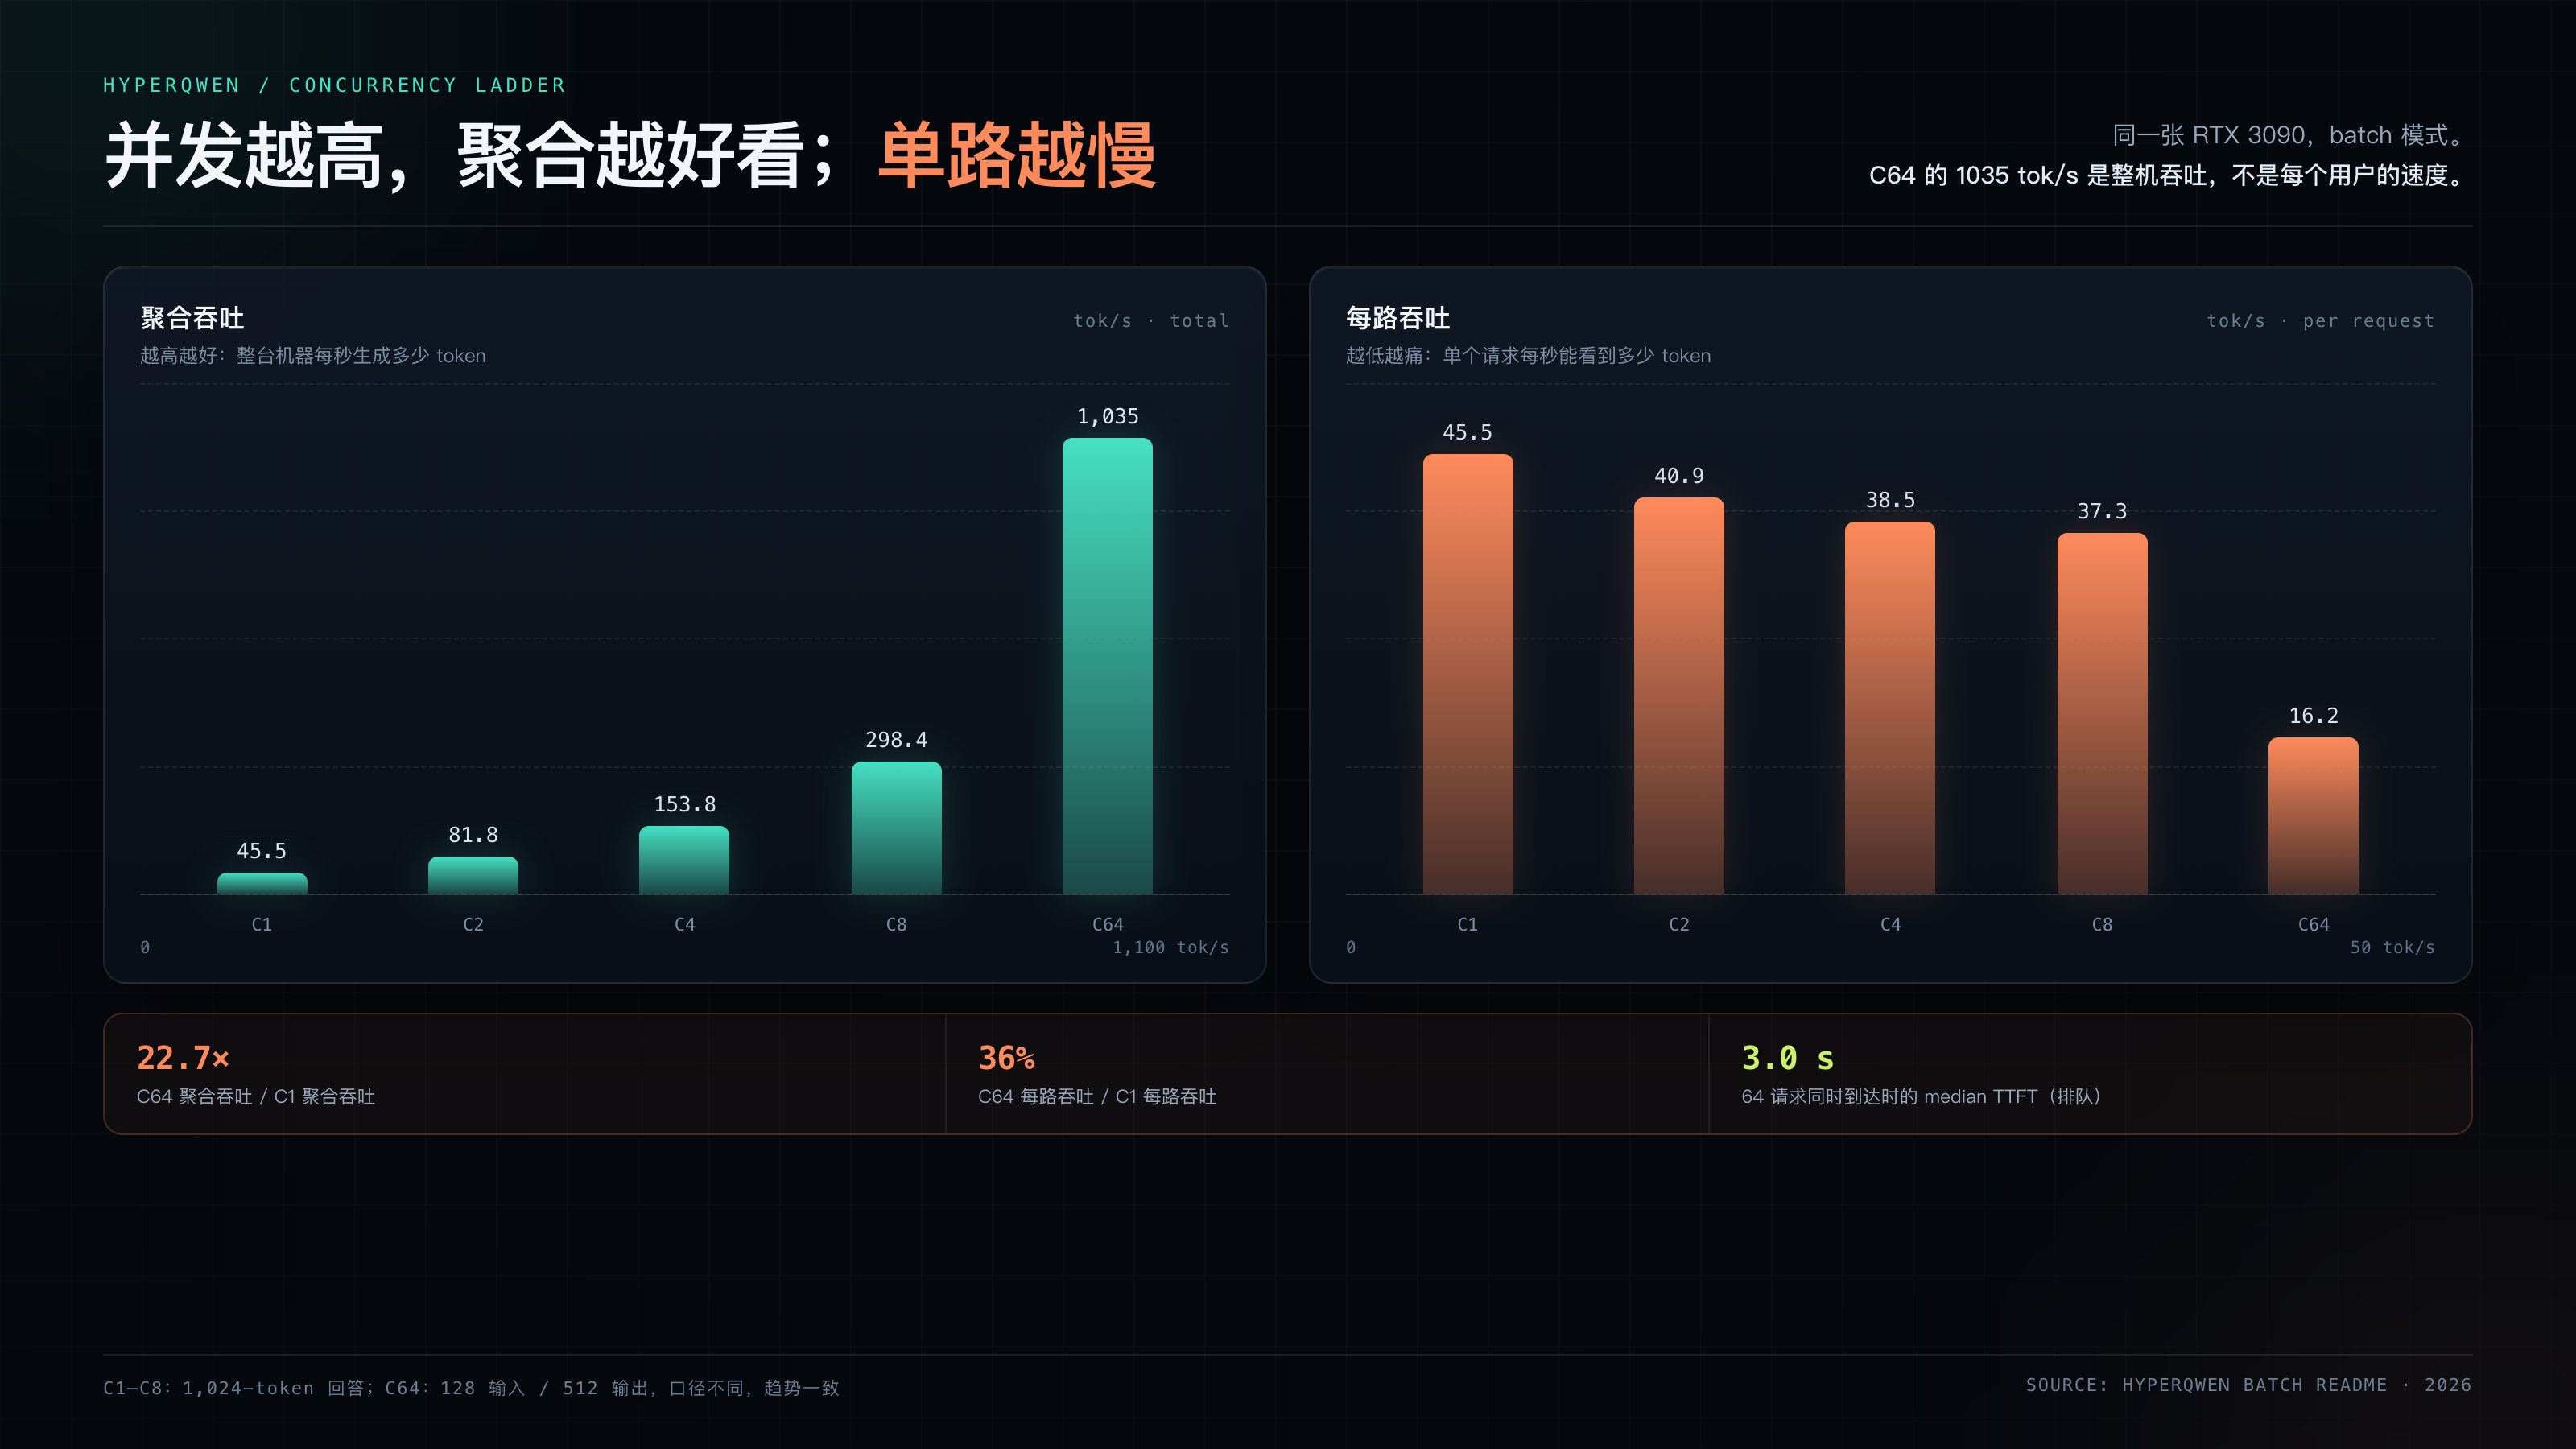
先看口径。HyperQwen 的数字不是单用户聊天速度,而是 batch 模式在 64 路并发下的聚合解码吞吐。
来源:HyperQwen README 与 batch/README(2026)。注:C1-C8 为 1,024-token 回答,C64 为 128 输入/512 输出,口径不同,趋势一致。
这套吞吐主要来自三件事。第一是 vLLM 的连续批处理:每个 decode step 动态拼 batch,让 GPU 尽量不空转,并用 PagedAttention 管理 KV cache,减少显存碎片。
第二是量化。HyperQwen 用 W4A16 权重,把 embedding 和 lm_head 重新量化到 int8,再在 batch 模式默认开启 int8 激活,让 MLP 的 GEMM 跑在 int8 tensor core 上。
第三是投机解码与缓存。single 模式用 MTP/DFlash2 草稿模型一次提议多个 token,再由目标模型验证;batch 模式则靠连续批处理把 64 路请求压满。两条路径共用一套安装,但优化目标完全不同。
64 路并发的真实体验:吞吐好看,单路只有约 16 tok/s
把 1035 除以 64,得到约 16.2 tok/s。这个数字不是官方指标,但和 batch/README 的 median TPOT 62.2ms 对得上:1000 ÷ 62.2 ≈ 16.1 tok/s。也就是说,64 路同时跑时,每个请求大约每秒吐 16 个 token,和单用户模式的 127 tok/s 相差近 8 倍。
更关键的是首字延迟。batch/README 的 64 并发、128 输入/512 输出测试,median TTFT 为 3.0 秒,而且这是 64 个请求同时到达时的排队时间。真实聊天里,用户很难接受 3 秒才看到第一个字;所以“64 路”更适合 API 后端、离线批处理、评测流水线,而不是客服聊天。
这也解释了为什么 README 把 single 和 batch 分成两套:single 用投机解码,C1 能到 127 tok/s;batch 用连续批处理,C1 只有 46 tok/s,但 C64 能到 1035。低于 8 路,single 更快;高于 8 路,batch 才开始赢。
一句话总结:1035 tok/s 是“整台机器一秒钟吐多少 token”,不是“每个用户一秒钟看到多少 token”。
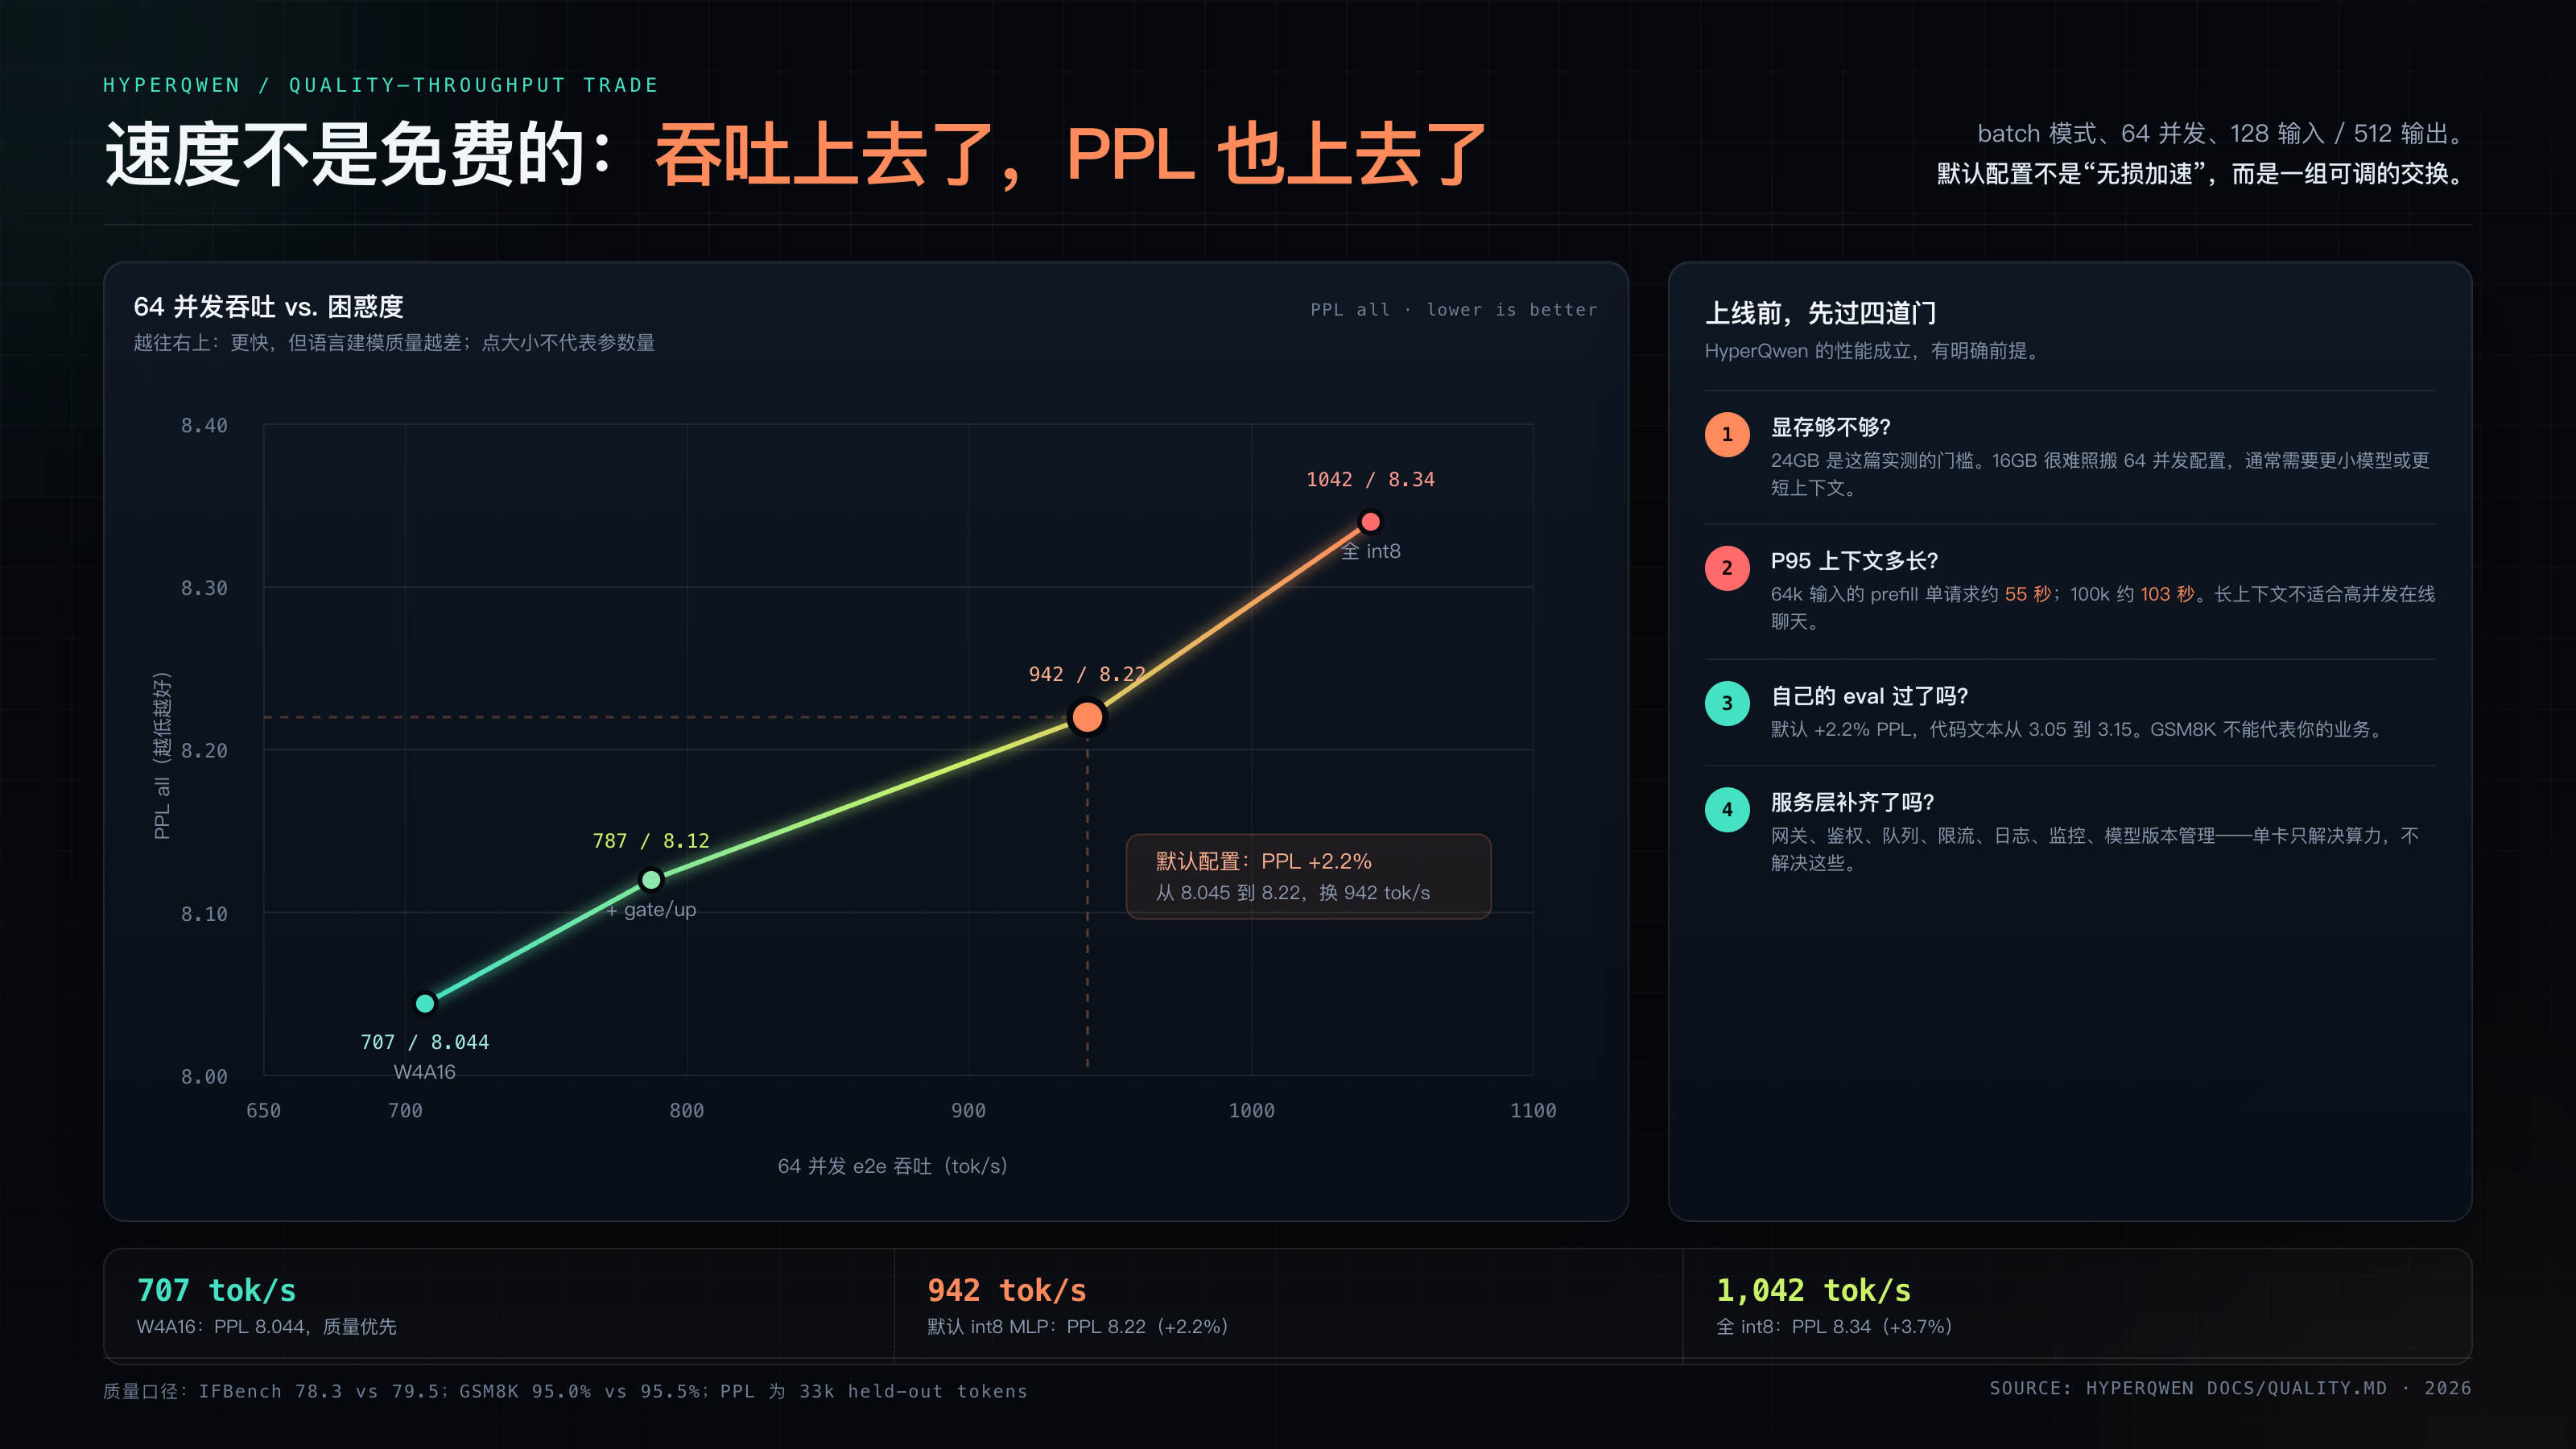
代价一:量化不是无损,默认配置 PPL +2.2%
HyperQwen 的吞吐是拿精度换来的。官方 quality.md 给了四组对比:
来源:HyperQwen docs/quality.md(2026)。
IFBench 也从 Qwen 模型卡的 79.5 降到 78.3,约 1 分。项目方把默认配置放在这个折中点,但它不是零成本。从 PPL 看,代码文本从 3.05 升到 3.15,涨幅比英文和丹麦文更明显;代码生成、结构化输出这类任务,不能只看 GSM8K。
如果业务不能接受 2% 级 PPL 上升,可以设 INT8_ACT= 回到 W4A16,但 64 并发 e2e 会从 942 降到 707 tok/s,降幅约 25%。这就是“速度/质量”的真实交换比。
代价二:长上下文不是免费,150k 的 prefill 很贵
Qwen3.8-27B 原生支持 262,144 token,HyperQwen 在 batch 模式把 MAX_LEN 默认开到 150,000,single 模式也能到 150k,单路约 95-100 tok/s。但“能开”不等于“适合高并发”。
batch/README 的 prefill 表显示:1k 输入 1,812 tok/s,64k 降到 1,182 tok/s,100k 降到 997 tok/s;单请求 TTFT 分别是 0.56 秒、55 秒、103 秒。并发不会让 prefill 变快,因为 chunked prefill 共用 2,048 token/step 的预算;四个 16k 请求同时到,最后一个要等约 40 秒。
所以 150k 上下文适合离线文档分析、代码库问答,不适合把长文档塞进高并发在线聊天。上线前要按 P95 输入长度做容量规划,而不是按“最大上下文”做宣传。
代价三:运维复杂度从一张卡变成一整套服务
HyperQwen 的快速开始只有三条命令:
git clone https://github.com/syv-ai/HyperQwen && cd HyperQwen
cp .env.example .env
docker compose --profile batch up -d
但第一次启动要拉 9.5GB 镜像,并在本地重算约 20GB 模型,这不是“下载完就能跑”。此外还有 vLLM 0.31.0 的版本锁、CUDA/驱动匹配、WSL2 的 UVA 问题、API key 和 BIND 配置、prefix cache 的显存占用、工具调用 parser 匹配。任何一项错了,表现都像“模型变笨”或“服务变慢”。
如果要把它变成团队可用的服务,至少要把 API 网关、鉴权、队列、限流、日志、监控和模型版本管理拆出来。例如七牛云的云服务器产品 QVM 可承载这些服务层组件,让 GPU 节点只负责推理;真正的 GPU 仍要按 24GB 显存和并发目标单独选型。
这不是说单卡方案不能生产,而是说“单卡”只解决了算力,没解决服务化。
谁适合用 HyperQwen,谁不适合
一个容易被忽略的限制:多卡不是线性加速。README 提到,两张 3090 的聚合吞吐反而低于一张(issue #135);TP=2/4 能跑,但收益要看模型头和卡型。不要默认“加卡就能翻倍”。
常见问题
Q:HyperQwen 和 Qwen3.8-27B 是什么关系? HyperQwen 是服务方案和补丁集,Qwen3.8-27B 是模型。HyperQwen 不发布新权重,而是让模型在 24GB 卡上以 vLLM 跑得更快。
Q:一张 3090 真的能跑 27B 吗? 可以,但靠 W4A16 量化和 int8 激活,不是 FP16。24GB 是门槛;16GB 很难照搬 64 并发配置,通常需要更小模型或更短上下文。
Q:1035 tok/s 等于每个用户 1035 tok/s 吗? 不是。它是 64 路并发的聚合 decode 吞吐;按 64 路摊薄,每路约 16 tok/s,且 64 请求同时到达时 median TTFT 3.0 秒。单用户模式则是 127 tok/s。
Q:HyperQwen 适合直接上生产吗? 适合内部 API、批处理、评测等能接受排队和量化的场景;不适合低延迟聊天或零精度损失场景。上线前至少做三件事:用自己的 eval 集测质量、按 P95 上下文压测、把网关/鉴权/监控补齐。
结论
HyperQwen 证明了一件事:单张 24GB 消费级显卡,确实可以把 27B 模型的聚合吞吐推到 1000 tok/s 量级;但它的正确用法是 API 后端和批处理,不是“64 个用户同时聊天还很流畅”。真正决定能不能上线的,不是 1035 这个数字,而是你的 P95 延迟、输入长度、质量基线和运维能力。
据 HyperQwen 官方 README 与 Qwen 模型卡(2026 年 10 月),这套方案更适合作为“低成本推理试验田”,而不是无条件替代托管 API。本文数据基于 2026-10-29 的公开资料,硬件、驱动和 vLLM 版本变化都会影响结果,建议上线前复测。
参考资料
HyperQwen GitHub:https://github.com/syv-ai/HyperQwen
HyperQwen batch benchmark:https://github.com/syv-ai/HyperQwen/blob/main/batch/README.md
HyperQwen quality:https://github.com/syv-ai/HyperQwen/blob/main/docs/quality.md
Qwen3.8-27B 模型卡:https://huggingface.co/Qwen/Qwen3.8-27B
vLLM 文档:https://docs.vllm.ai/
七牛云 QVM 产品页:https://www.qiniu.com/products/qvm
七牛云 Token Plan(多模型 API 统一接入):https://www.qiniu.com/ai/plan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free