DeepSeek V4 Pro 与 V4.1 Flash 怎么选:2026 官方 API 名称、价格、Vision 与并发对比
发布日期:2026-11-03
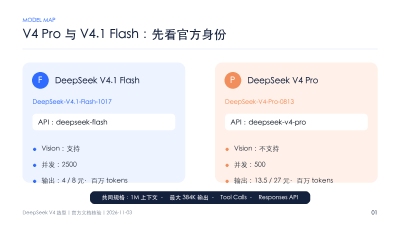
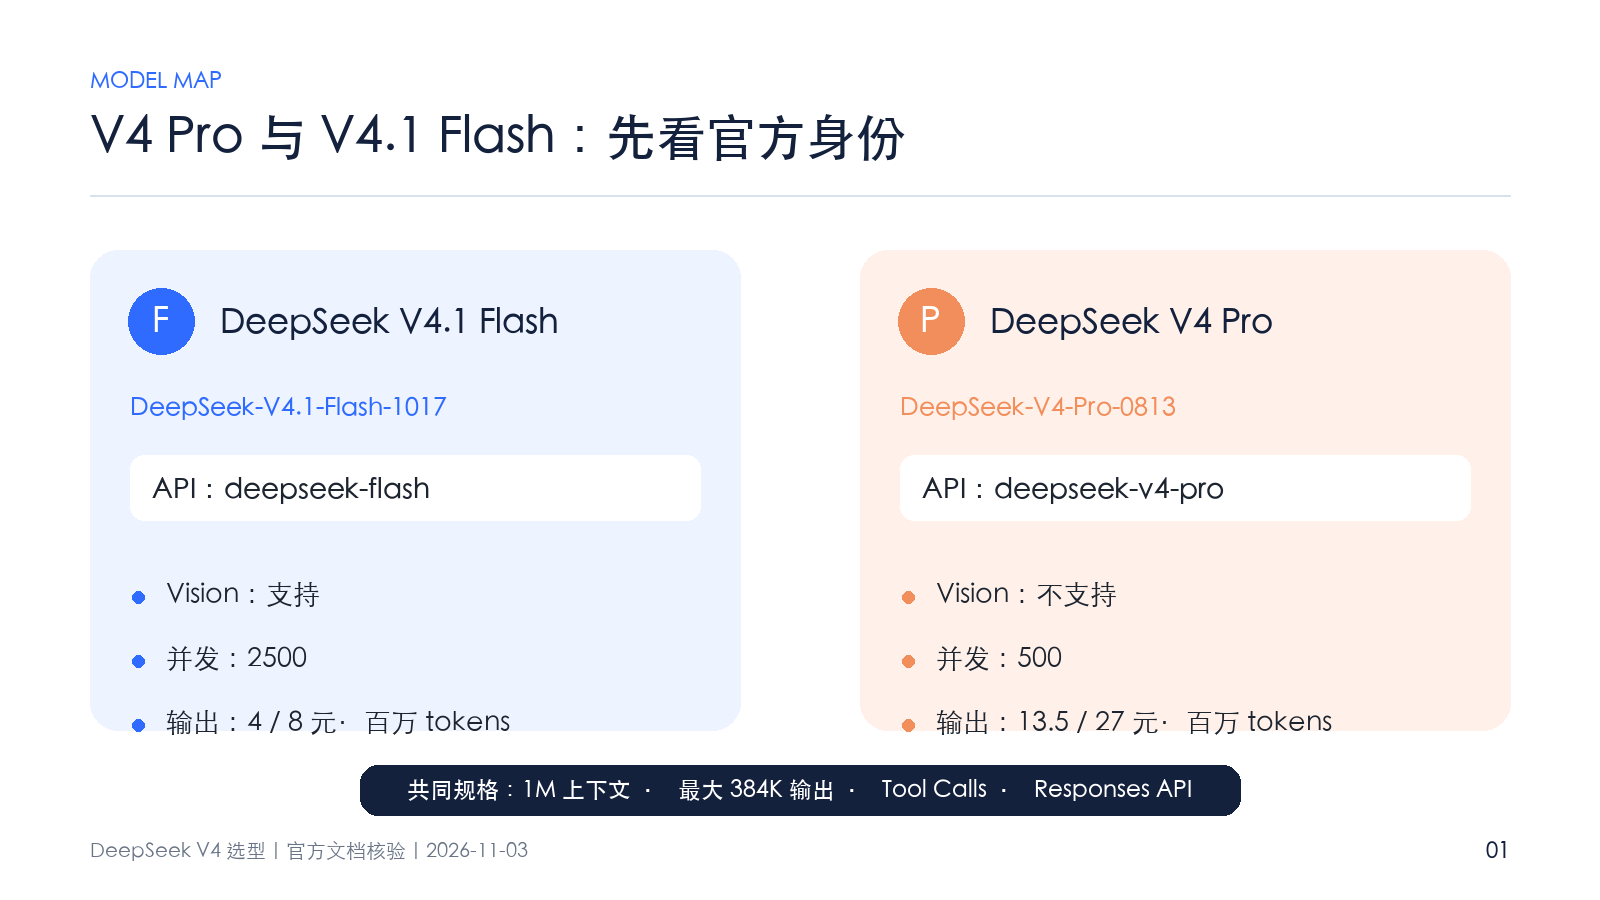
DeepSeek 官方更新日志在 2026 年 10 月将 V4.1 Flash 更新为 DeepSeek-V4.1-Flash-1017,它是通过 deepseek-flash 调用的 API 模型;V4 Pro 的官方调用名是 deepseek-v4-pro。两者均提供 1M 上下文和最大 384K 输出,Flash 支持图像理解、价格更低且并发上限更高,Pro 则应在复杂任务上通过同口径测试确认是否值得更高成本。本文按名称、规格、价格、并发、Vision 和接入代码给出选择路径,并标出旧模型名与当前服务版本的关系。
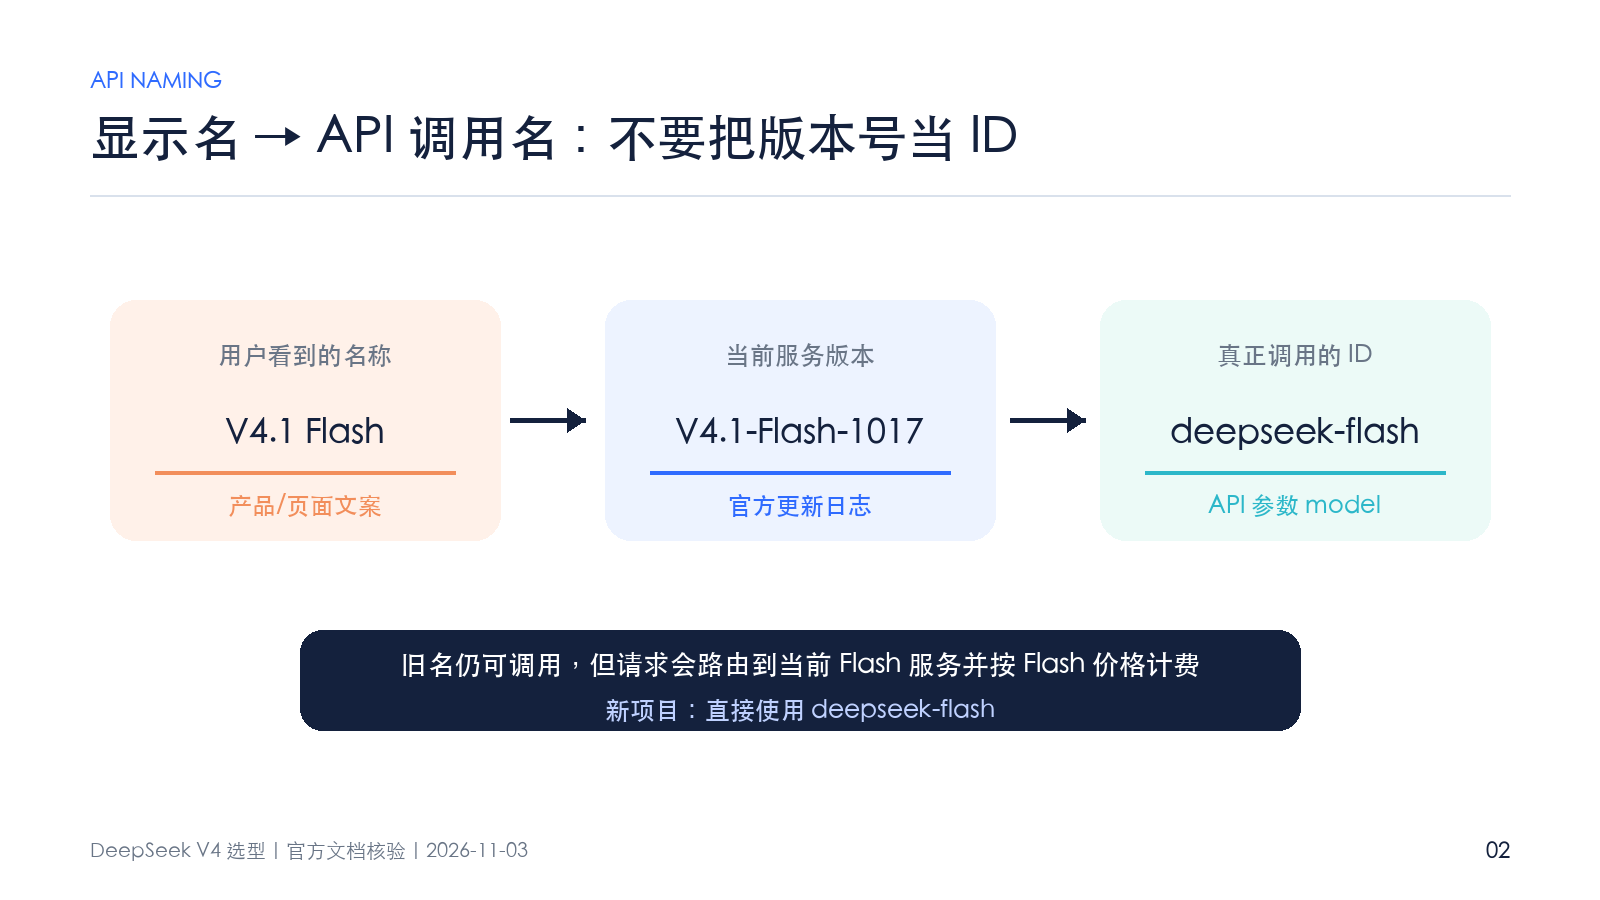
先解决名称:V4.1 Flash 的 API ID 不是 deepseek-v4.1-flash
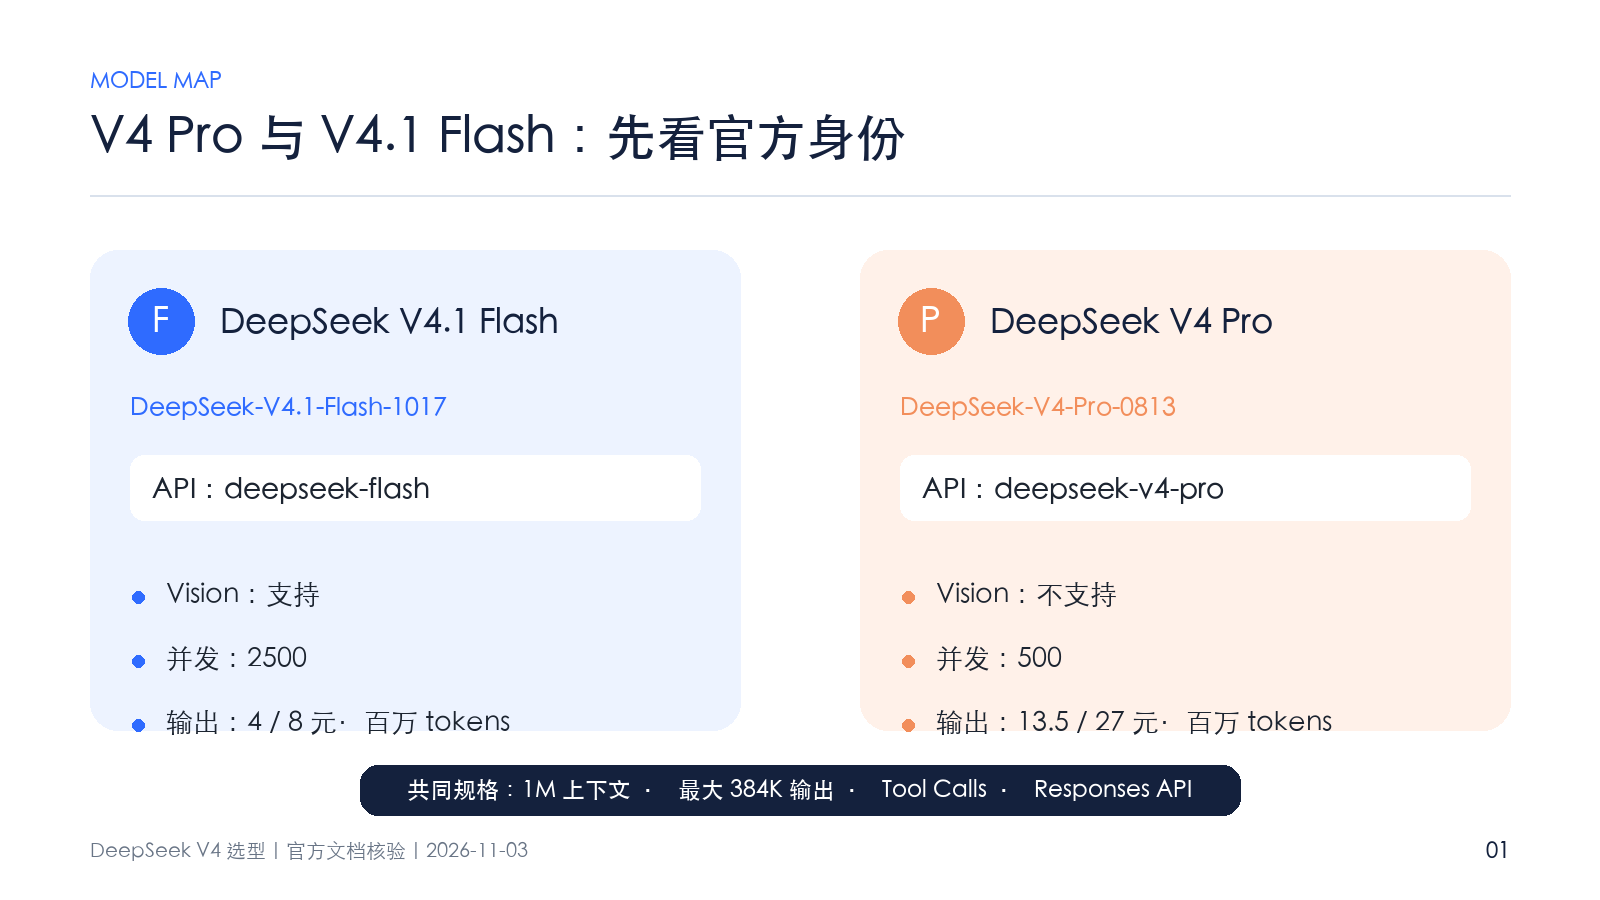
DeepSeek 官方模型表把“产品显示名”和“API 调用名”分开列出,接入时应以 API 调用名为准。
因此,配置文件或 SDK 中写 deepseek-v4.1-flash 可能导致模型不存在或路由失败。官方定价页说明,旧名 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 仍可调用,但对应请求会由 DeepSeek-V4.1-Flash-1017 提供服务,并按 Flash 价格计费。新项目直接使用 deepseek-flash,更容易与当前文档保持一致。
两个模型的通用接口规格接近,Vision 是明确差异
截至 2026 年 11 月 3 日,官方模型表显示两者都支持 1M 上下文、最大 384K 输出、JSON Output、Tool Calls、Responses API、Anthropic API 和对话前缀续写;FIM 补全均只在非思考模式下支持。也就是说,纯文本对话、长文档处理和工具调用的接入框架可以共用,通常只需要替换模型字符串并重新验证输出。
Flash 支持图像理解,Pro 当前表格标注为不支持。需要读取截图、扫描件、商品图或图表时,Vision 能力是硬条件;只处理文本和代码时,这一项不会决定接入方式,但仍要单独测试结构化输出、工具调用和长上下文任务。
价格与并发:Flash 面向高吞吐,Pro 单价更高且并发上限更低
DeepSeek 官方定价页以“每百万 tokens”为单位列出 2026 年 11 月当前价格。缓存命中输入、缓存未命中输入和输出分别计费,工作日北京时间 9:00—12:00、14:00—18:00 为高峰时段,其余时间为闲时。
Flash:缓存命中输入闲时/高峰为 0.02/0.04 元;未命中输入为 1/2 元;输出为 4/8 元;并发限制为 2500。
Pro:缓存命中输入闲时/高峰为 0.15/0.30 元;未命中输入为 4.5/9 元;输出为 13.5/27 元;并发限制为 500。
2026 年 10 月 17 日的官方更新日志确认,V4.1 Flash-1017 更新后 API 调用方式和价格保持不变。批量摘要、在线客服、检索增强生成和高并发 Agent 调度,应先核算缓存命中率、峰谷时段和输出长度,再估算月度成本;只看“模型名称”无法得到真实账单。
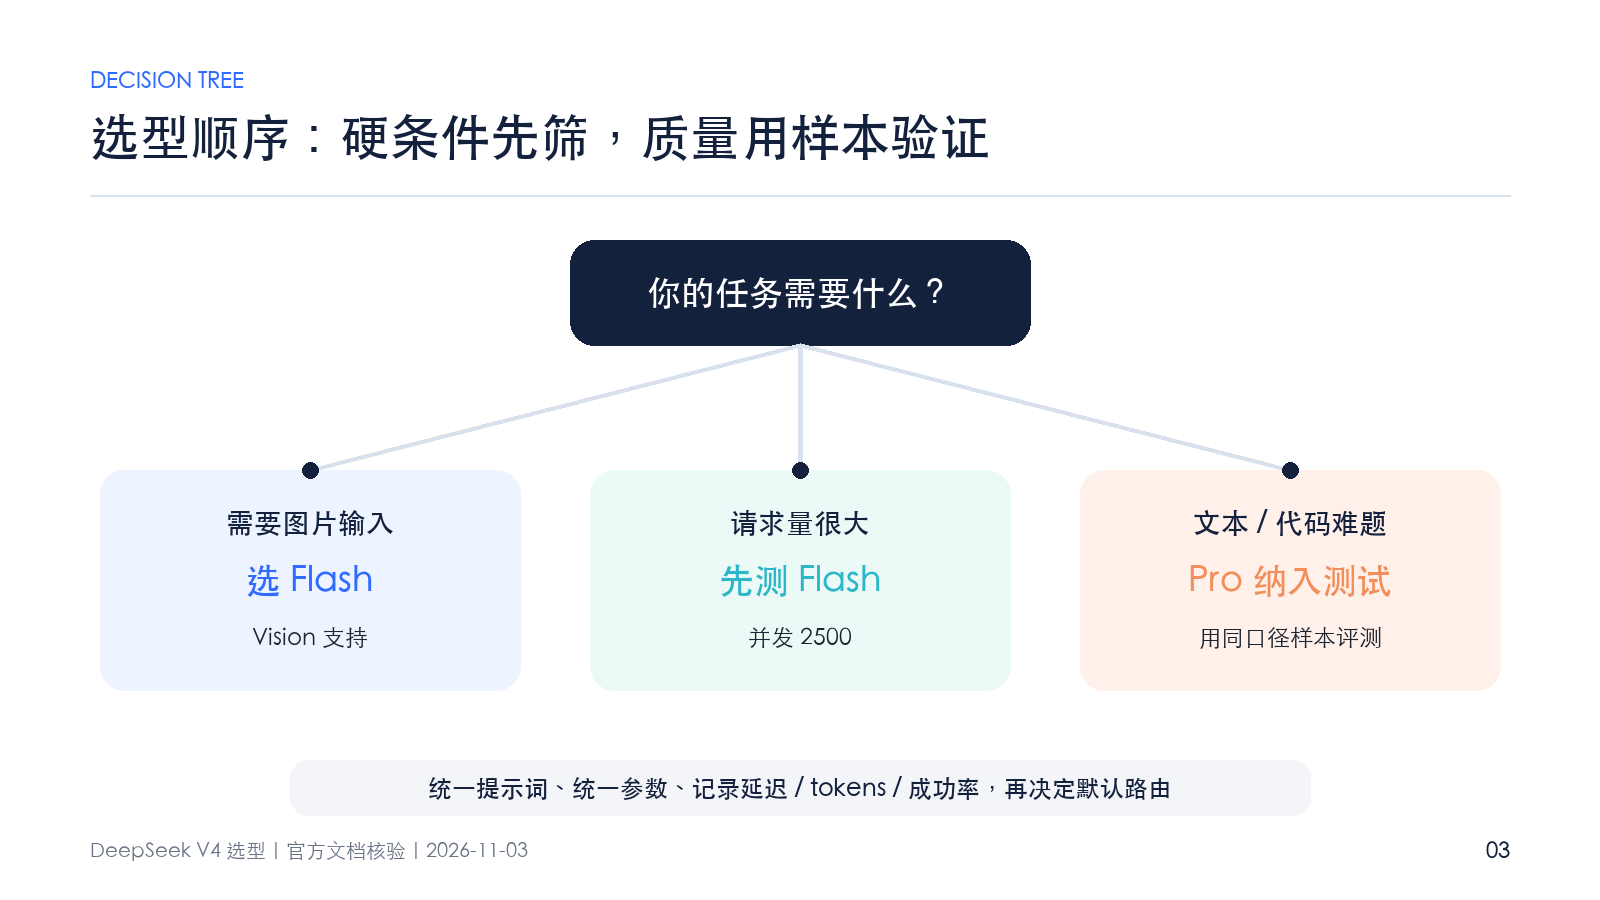
怎么选:先按任务硬条件筛,再用同口径样本测质量
可以按下面的顺序做选择:
任务包含图片输入:使用 Flash,因为官方当前能力表只给 Flash 标注图像理解支持。
请求量大或延迟预算紧:优先把 Flash 作为吞吐基线,它的并发上限为 2500,明显高于 Pro 的 500;同时用自己的峰值流量验证限流行为。
主要处理文本、代码或长上下文:两个模型都满足 1M 上下文和 384K 最大输出,先用同一批样本比较答案正确性、工具调用成功率、延迟和输出长度。
质量优先且成本可控:把 Pro 纳入高难任务测试组,但不要仅凭“Pro”后缀推断它一定更好。DeepSeek 当前价格页没有给出 V4 Pro 与 V4.1 Flash 的同口径综合排名,最终结论应来自业务样本。
混合路由:可以让 Flash 处理默认请求,把失败重试、长链路推理或人工标记的难题转给 Pro;路由条件应记录在应用日志中,便于按任务类型复盘。
用同一段代码切换两个模型
DeepSeek 官方首次调用文档提供 OpenAI 兼容格式。下面的示例使用环境变量读取密钥,不把真实密钥写进代码;将 model 替换为 deepseek-v4-pro 即可测试 Pro。
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {"role": "user", "content": "请把这段文本整理成三条要点。"}
    ],
    "stream": false
  }'
建议至少准备四组样本:普通问答、代码修改、长文档问答和工具调用;有图像任务时单独加入图片输入。每组样本固定系统提示词、温度及输出格式,记录首字延迟、总耗时、输入/输出 tokens、JSON 解析成功率和人工评分。这样得到的路由规则可以解释,也能在模型版本变化后重新回归。
三个容易踩坑的地方
把显示名当成 API ID:
DeepSeek-V4.1-Flash-1017是当前服务版本显示名,API 仍使用deepseek-flash。忽略缓存和时段:同一个模型的缓存命中与未命中价格不同,工作日高峰与闲时也不同,成本测算必须记录这两个条件。
用 Pro 发送图像:官方当前模型表把 Pro 的图像理解标为不支持,图像任务应先选 Flash 或改用已核验的图像模型。
结论
如果你的首要条件是图像理解、高并发或成本控制,当前官方规格更直接地指向 deepseek-flash;如果任务只处理文本或代码,并且你愿意为复杂任务做质量评测,可以把 deepseek-v4-pro 放进高难样本组。两者都具备 1M 上下文和最大 384K 输出,真正的质量取舍应由同一批业务样本决定。本文数据截至 2026 年 11 月 3 日,版本、价格与能力以 DeepSeek 官方模型与价格文档及更新日志为准。
参考资料
DeepSeek API 模型与价格(官方文档):https://api-docs.deepseek.com/zh-cn/quick_start/pricing
DeepSeek API 首次调用(官方文档):https://api-docs.deepseek.com/zh-cn/
DeepSeek API 更新日志(官方文档):https://api-docs.deepseek.com/zh-cn/updates
相关文章
七牛云产品
七牛云Token Plan 企业订阅(DeepSeek低至1.2折):https://www.qiniu.com/ai/tokenplan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free