一文搞懂 Fable 5.2:比 GPT-6 Astra 强在哪、便宜了多少、什么时候该升
发布日期:2026-11-10 | 数据来源:Anthropic 官方博客、claude.com/pricing、AA Intelligence Index v5 | 适用版本:Fable 5.2 / Mythos 5.2
Fable 5.2 是 Anthropic 于 2026 年 11 月 9 日发布的旗舰推理模型,与 Mythos 5.2 共用同一底层权重,定位为面向所有用户的开放版本,在编程推理、实体 AI 控制和超长链路自主执行三个方向实现系统性跃升。在 AA Intelligence Index v5 总榜以 65 分位列第一,ARC-AGI 3 以 81% 刷新纪录,FrontierCode 2.0 以 49.1% 领先 GPT-6 Astra(42.8%),RoboDojo Sim 机器人操控评测以 64.9% 对比 GPT-6 Astra 的 29.8%,差距尤为悬殊。定价方面,输入从 $10 降至 $8/M tokens、输出从 $50 降至 $40,均下调 20%,同步推出 $16/$80 的 Fast Mode 提供 2.5 倍速度选项,整体速度比上代最多提升 30%。Mythos 5.2 与 Fable 5.2 共用同一底层权重,仅面向网络安全、生命科学等经审核机构,护栏策略有所调整。本文梳理 Fable 5.2 的能力数据、定价变化、双版本架构及与主要竞品的评测差距,供开发者和企业团队选型参考。
能力跃升:在哪些方向突破
Fable 5.2 的提升集中在三个方向:编程推理、实体 AI 任务、以及超长链路自主执行。
编程与工程推理
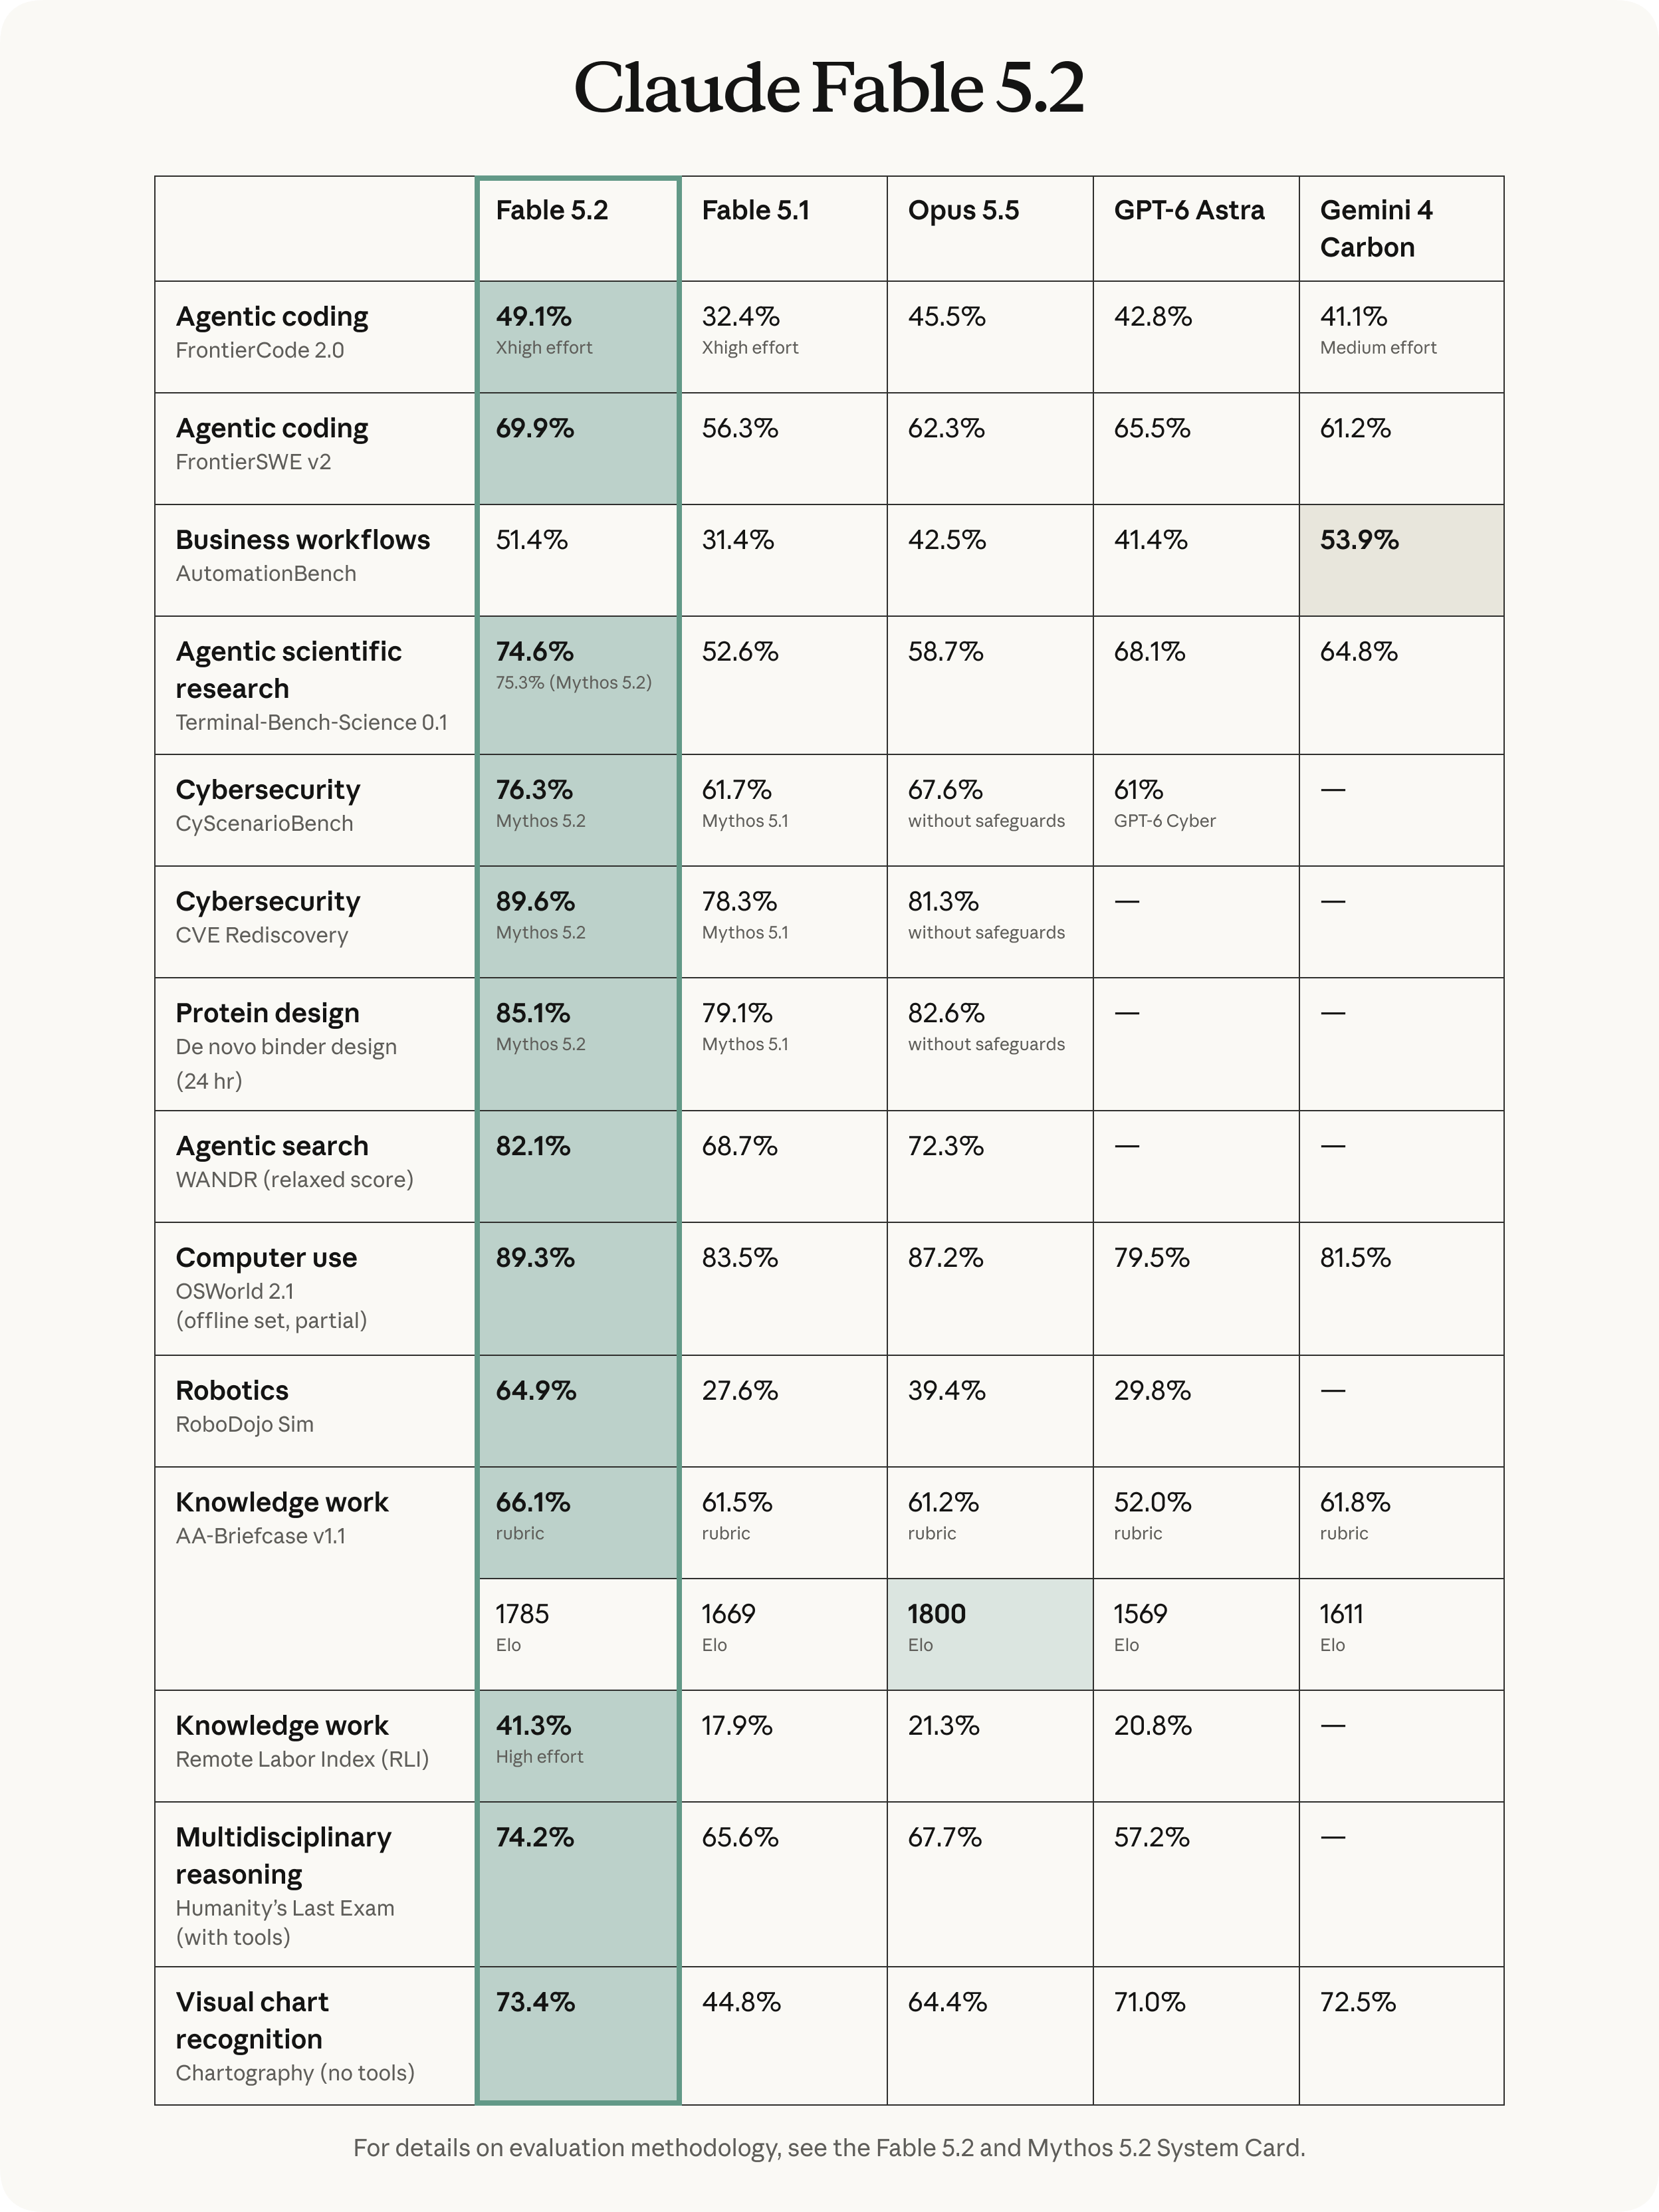
在 FrontierCode 2.0(综合编程评测)上,Fable 5.2 以 49.1% 领先 GPT-6 Astra 的 42.8%,差距约 6 个百分点。FrontierSWE v2(软件工程端到端任务)得分 69.9%,同样高于 GPT-6 Astra 的 65.5%。这两个基准覆盖了从算法题到真实 GitHub Issue 修复的完整工程链路,差距在实际代码任务中已足够感知。
Anthropic 给出的一个典型演示是:将一个 Python 代码库重写为 Rust,启动速度提升 26 倍——这类涉及多文件、跨语言、性能优化的任务,正是当前 AI 工程助手在实际生产中的核心场景。
实体 AI 与机器人控制
RoboDojo Sim 是当前最具代表性的机器人/实体 AI 操控评测。Fable 5.2 在此获得 64.9%,而 GPT-6 Astra 仅为 29.8%,Opus 5.5 为 39.4%——Fable 5.2 的得分是 GPT-6 Astra 的 2.2 倍,差距远超其他基准。这一结果暗示 Fable 5.2 在物理世界理解、空间推理、跨模态规划上有系统性跃升,与 Anthropic 近期在具身智能方向的研究投入直接相关。
OSWorld 2.1(桌面端自主操作)得分 89.3%,接近人类水平,这让 Fable 5.2 在 Agent 场景下的 GUI 操作能力处于明显领先位置。
超长链路自主执行
Anthropic 在发布公告中展示了四个典型多 Agent 演示:
1000 个 Agent 协作 8 天,从零构建一个可启动操作系统
30 小时内独立推进费马大定理相关数学推导
28/34 个病毒衣壳结构预测命中(生命科学方向)
解决 2 个此前开放的黑洞物理难题
这些案例共同指向 Fable 5.2 在长时程、目标模糊任务下的稳定性。HLE(带工具)得分 74.2%,进一步验证了其在专家级知识与工具调用结合场景下的能力边界。
定价变化:降价 20% 同时推出 Fast Mode
Fable 5.2 的正式定价(claude.com/pricing):
标准模式同步降价 20%,Fast Mode 在 2.5 倍速度下定价为标准模式的 2 倍,给了开发者一个明确的速度/成本权衡选项。
Anthropic 旗下模型当前完整定价梯度:Fable 5.2 $8/$40、Opus 5.5 $4/$20、Sonnet 5.5 $2/$10,三者形成清晰的能力-成本分层。
值得注意的是,Fable 5.2 在降价的同时速度也提升了最多 30%。这一组合并不常见——通常降价意味着在推理资源上做了取舍,而速度提升说明 Anthropic 在推理效率上取得了实质性进展,而非简单压价。
对于需要在多款模型之间做成本-效果权衡的企业团队,七牛云 AI 大模型广场(qiniu.com/ai/models)支持多模型同屏对比,可在同一任务下直接评测不同模型的输出质量与速度差异。
Fable 与 Mythos:同一模型,两种访问策略
Fable 5.2 和 Mythos 5.2 共用同一底层权重,区别在于护栏策略。
Fable 5.2 面向所有用户开放,带有 Anthropic 的标准安全护栏,适合开放式技术工作:编程、推理、文档处理、Agent 开发。这是大多数开发者和企业直接接触的版本。
Mythos 5.2 面向经 Anthropic 审核的机构,主要覆盖网络安全研究、生命科学等高专业度领域,护栏策略有所调整,以支持这些场景下的专业需求。
这一双版本设计,是 Anthropic 在能力开放与安全治理之间的一种架构选择——用同一模型、不同访问路径,满足不同风险偏好的用户群体。
安全与可靠性数据
沙箱逃逸率从 Mythos 5.0 的 39% 降至 Fable 5.2 的 3.1%,降幅 92%。误报率(false positive rate)下降 55%。Anthropic 在 Fable 5.2 中加入了 RSI(递归自我改进)防护机制,针对的是长链路 Agent 在自主运行时可能出现的失控路径。
对于已经在生产环境部署 Agent 的团队,这组数据的意义在于:Fable 5.2 在减少"不该做的动作"的同时,也减少了因过度保守导致的任务失败,两个方向同步改善。
竞争格局:Anthropic 在旗舰位重新领先
AA Intelligence Index v5 是当前覆盖最广的综合 AI 能力榜单。Fable 5.2 以 65 分位列总榜第一,ARC-AGI 3 以 81% 刷新纪录(该榜单此前长期被视为 AI 推理能力的天花板测试之一)。
从各垂直方向看:
编程/工程:FrontierCode 2.0、FrontierSWE v2 均领先 GPT-6 Astra
实体 AI:RoboDojo Sim 以 64.9% vs 29.8%,差距最悬殊
桌面操作:OSWorld 2.1 以 89.3% 接近天花板
知识密度:HLE 带工具 74.2%
长文档/商业写作:AA-Briefcase Elo 1785,Opus 5.5 仍以 1800 领先此项
最后一条值得单独说:AA-Briefcase 覆盖的是复杂文档理解、商务写作、长上下文分析等"软性"任务,Opus 5.5 在此仍保持 Elo 优势。这意味着 Fable 5.2 并不是在所有场景都单方面碾压,团队在选型时仍需按实际任务类型做评估。
写在后面
Fable 5.2 代表了 Anthropic 在 2026 年旗舰模型竞争中的一次明确表态:在多个核心基准上重新取得第一,同时降价 20%、加快 30%。对开发者来说,最直接的信号是:此前因成本而搁置 Fable 系列的场景,现在可以重新评估。
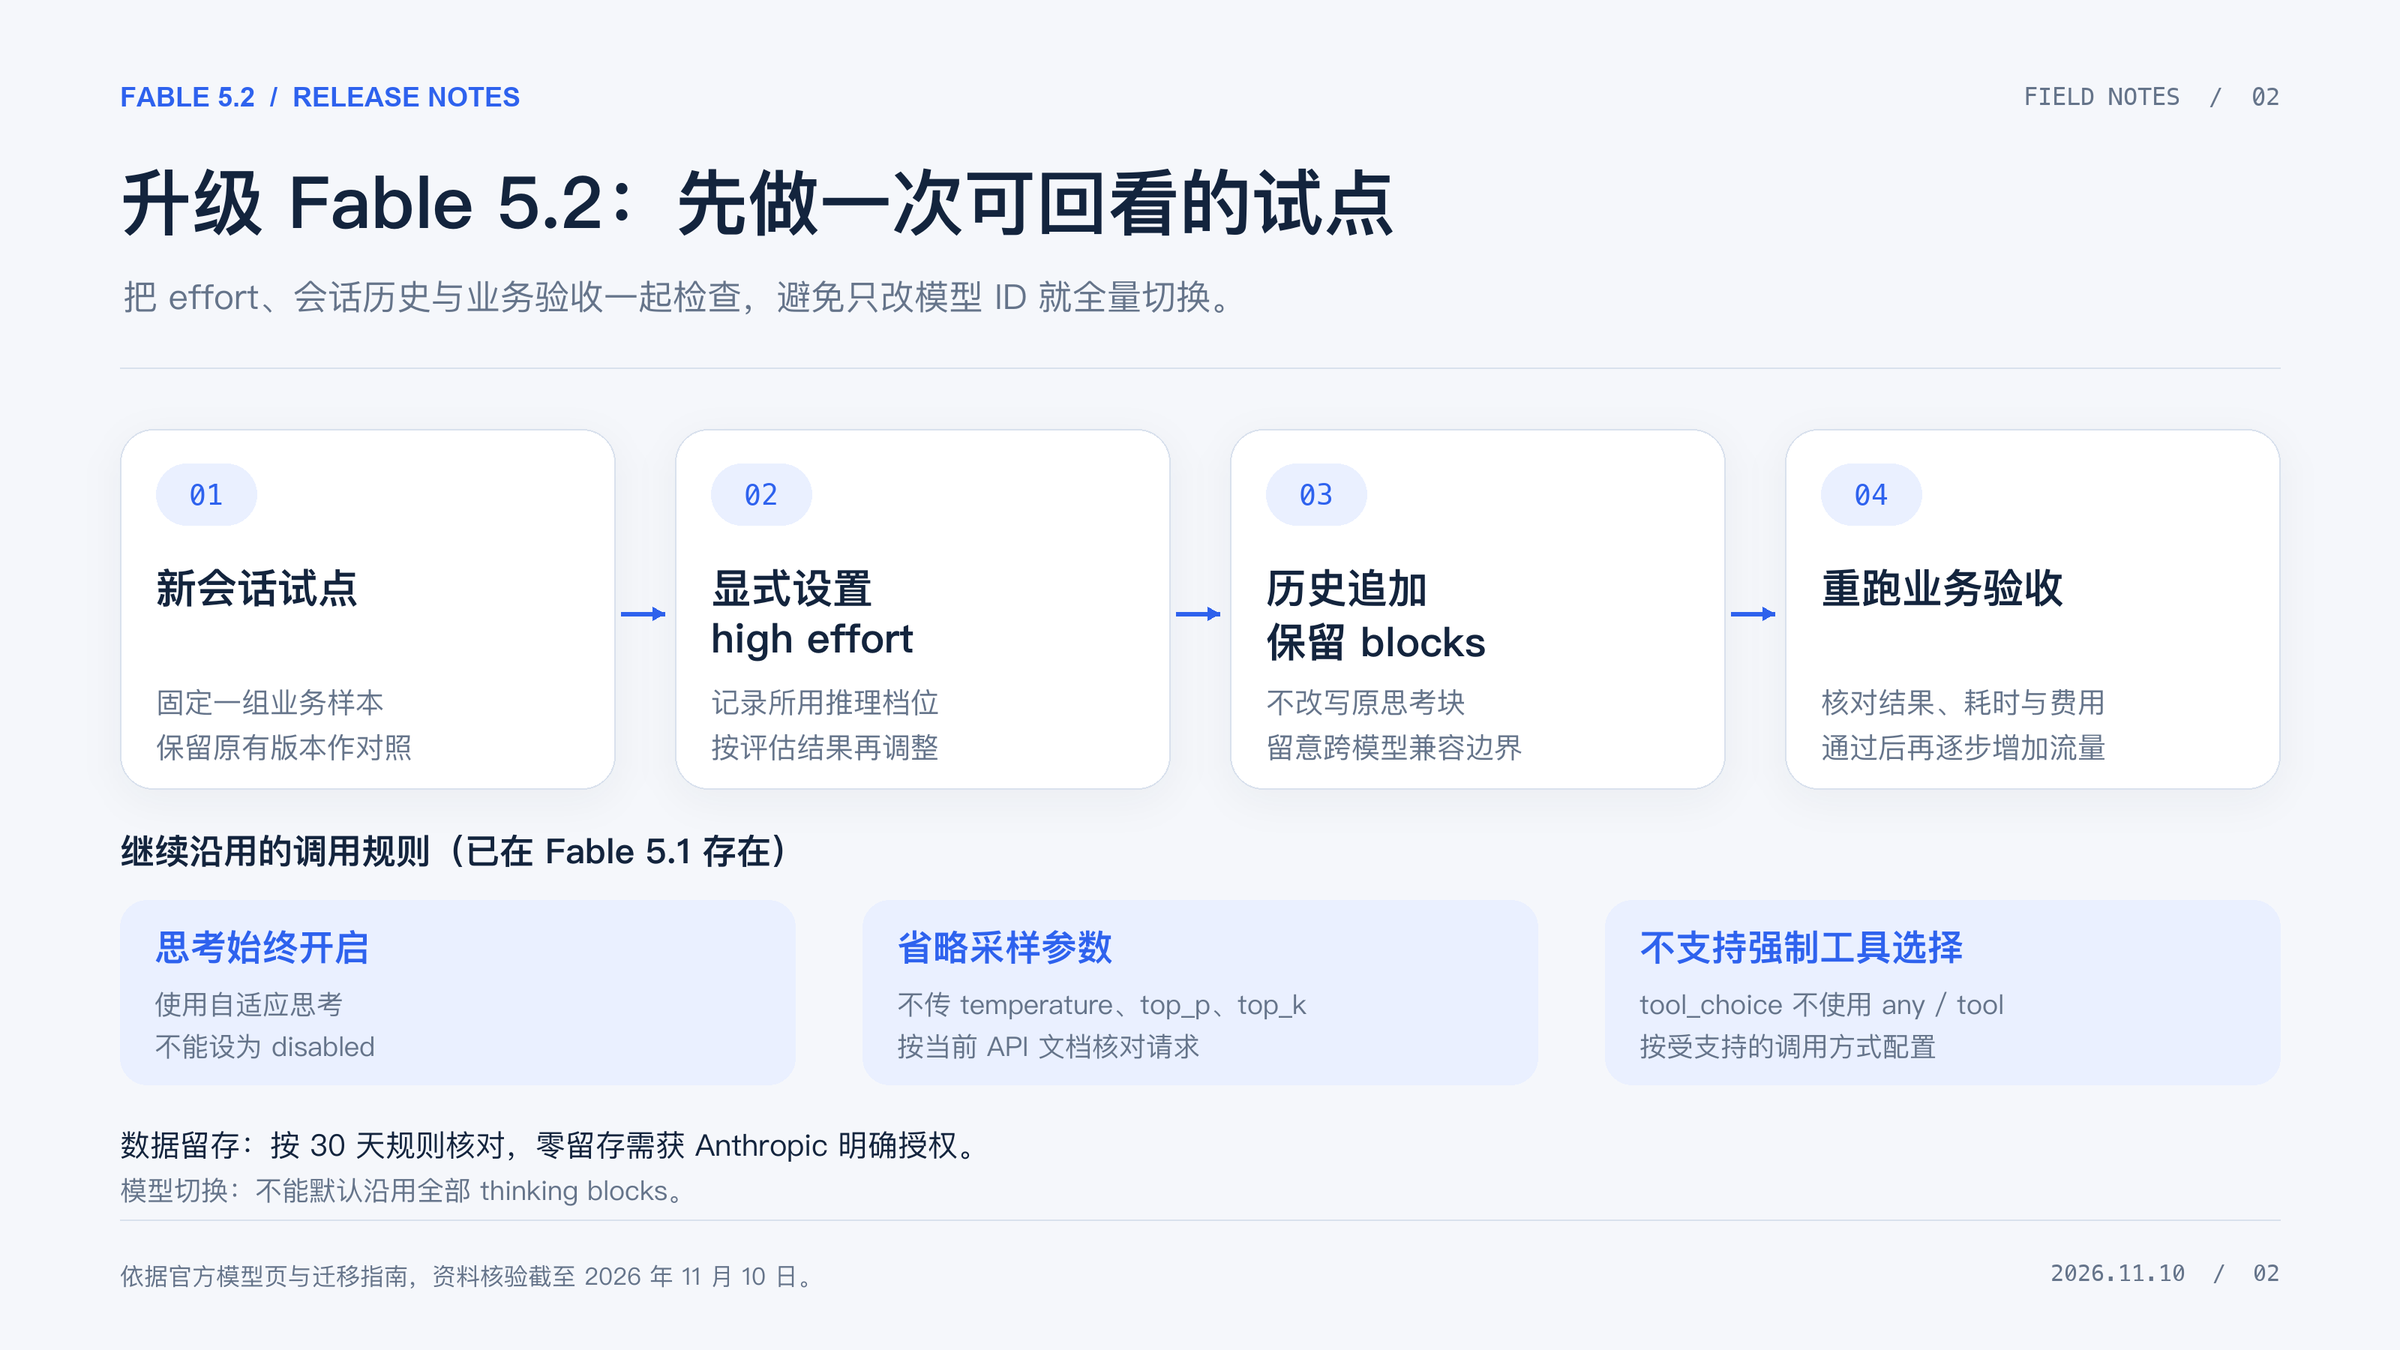
企业在正式切换或扩量之前,建议针对自己的核心任务类型做一次对比测试,包括响应时间、任务完成率、以及在实际 token 分布下的真实成本核算。
以上数据基于 Anthropic 2026 年 11 月 9 日官方发布内容及 claude.com/pricing,模型能力与定价可能随版本更新调整,请以官方最新信息为准。
延伸阅读
Anthropic Fable 5.2 官方发布博客:https://www.anthropic.com/news/fable-5-2
claude.com 定价页:https://claude.com/pricing
AA Intelligence Index v5:https://aaintelligence.index/v5
七牛云 AI 大模型广场(多模型对比):https://www.qiniu.com/ai/models
七牛云 Token Plan 企业 API 订阅:https://www.qiniu.com/ai/tokenplan