AI与智能服务
未读
Llama私有化:vLLM调优与显存管理实战指南
当企业决定将大语言模型引入生产环境时,往往会遭遇一道难以逾越的隐形高墙:并发一上来,显存瞬间被挤爆。针对Llama开源模型私有化:vLLM推理框架调优与企业显存管理,绝非简单的“跑通代码”即可了事。真正的生产级部署,是一场对GPU显存榨干到极致的硬核工程。 精准规划:企业级硬件选型与部署底座 在实施
AI与智能服务
未读
算力受限模型训练:GB300集群分布式推理优化避坑
当团队面临硬件资源瓶颈时,算力受限下的模型训练往往会演变成一场与显存溢出和通信延迟的拉锯战。尤其在当前动辄千亿参数的模型时代,如何用有限的预算榨干每一滴硬件性能,成为了算法工程师的必修课。近期,不少团队开始尝试引入新一代架构的硬件,但如果在网络拓扑和任务分配上缺乏经验,即使是顶级硬件也可能跑出极低的
AI与智能服务
未读
Codex 桌面版插件无法使用?四类问题逐一排查
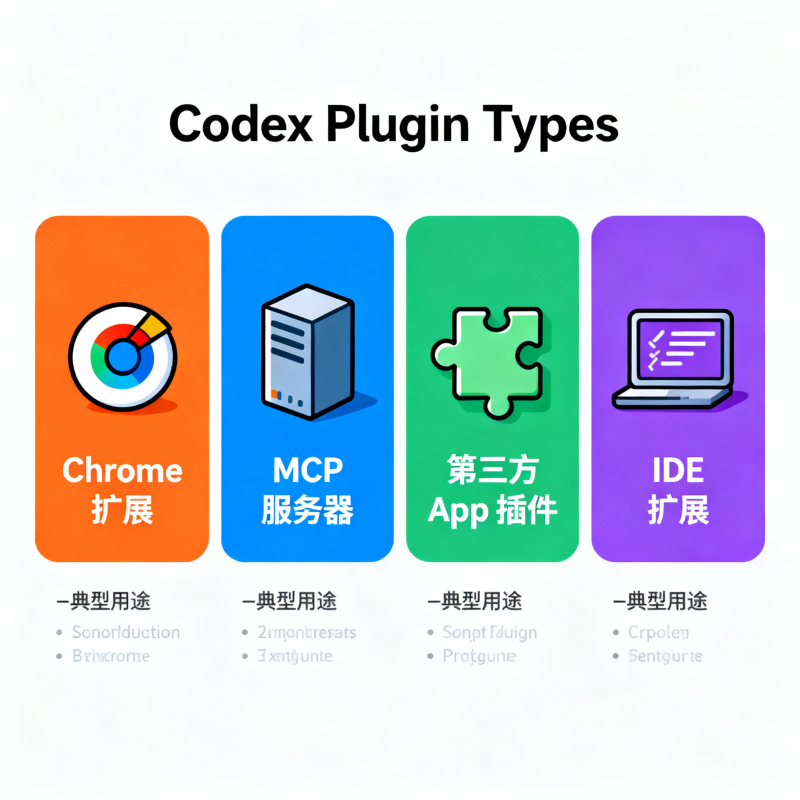
发布日期:2026-06-22 | 话题:AI 编程工具 | 适用人群:开发者、AI 工程师 Codex 桌面版(Codex App)支持四类插件:Chrome 扩展、MCP 服务器、Skills、第三方 App(GitHub / Slack / Google Drive 等)。这四类插件的报错原因
AI与智能服务
未读
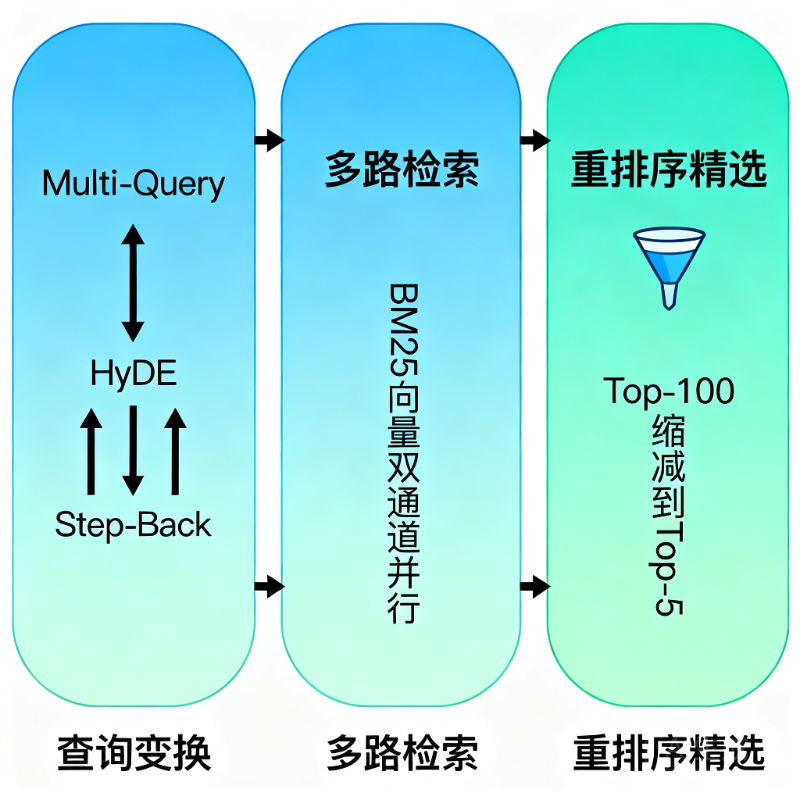
企业级RAG检索引擎优化与防幻觉实战:从多路召回到重排序
当企业将私有数据接入大模型时,常常会遇到一个棘手问题:系统给出的答案看似专业,实则在关键指标或专有名词上胡编乱造。这种现象的根源往往不在于大模型本身不够聪明,而是前端检索引擎喂给模型的信息存在偏差、遗漏或大量噪音。 进行深度的企业级RAG系统检索引擎优化,是确保业务数据准确输出的必经之路。本文将跳出
AI与智能服务
未读
哪些平台的 API 支持 Codex 桌面版?国内外平台完整对比
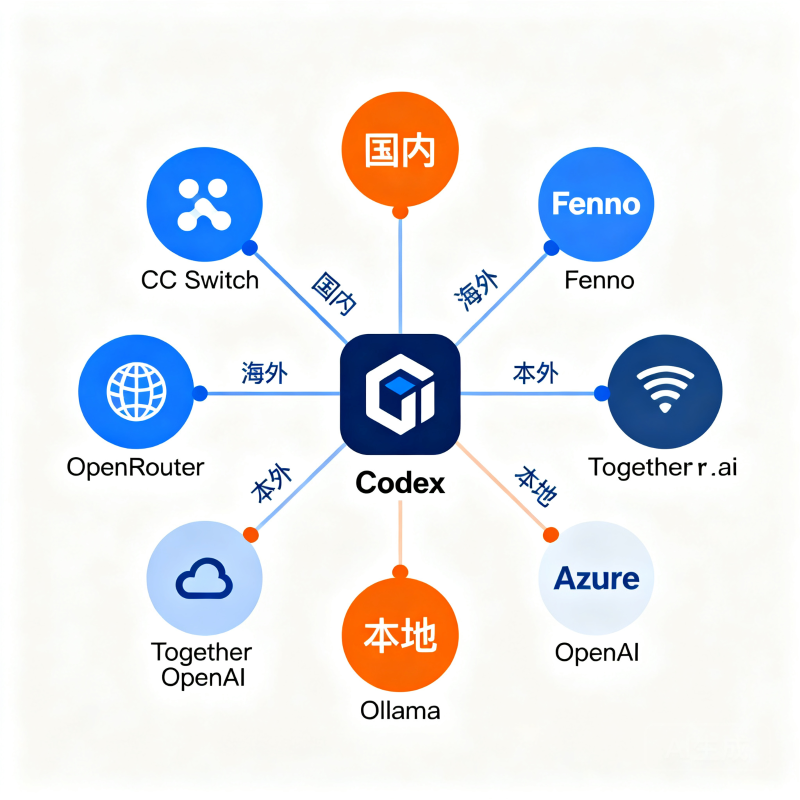
发布日期:2026-06 | 话题:AI 编程工具 | 适用人群:开发者、AI 工程师 Codex 桌面版(macOS / Windows)通过 ~/.codex/config.toml 支持自定义 API 服务,将 base_url 和 env_key 填入任意兼容 OpenAI Chat Com
AI与智能服务
未读
RAG 召回率低怎么办?六大根因 + 七种提升策略完整指南
发布日期:2026-06 | 话题:RAG / AI 应用开发 | 适用人群:AI 工程师、后端开发者 RAG(检索增强生成)系统召回率低,通常不是单一问题,而是分块策略、向量模型选择、查询表达偏差、检索方式单一等多个环节共同造成的。核心提升路径有七条:混合检索(BM25 + 向量)覆盖关键词与语义
AI与智能服务
未读
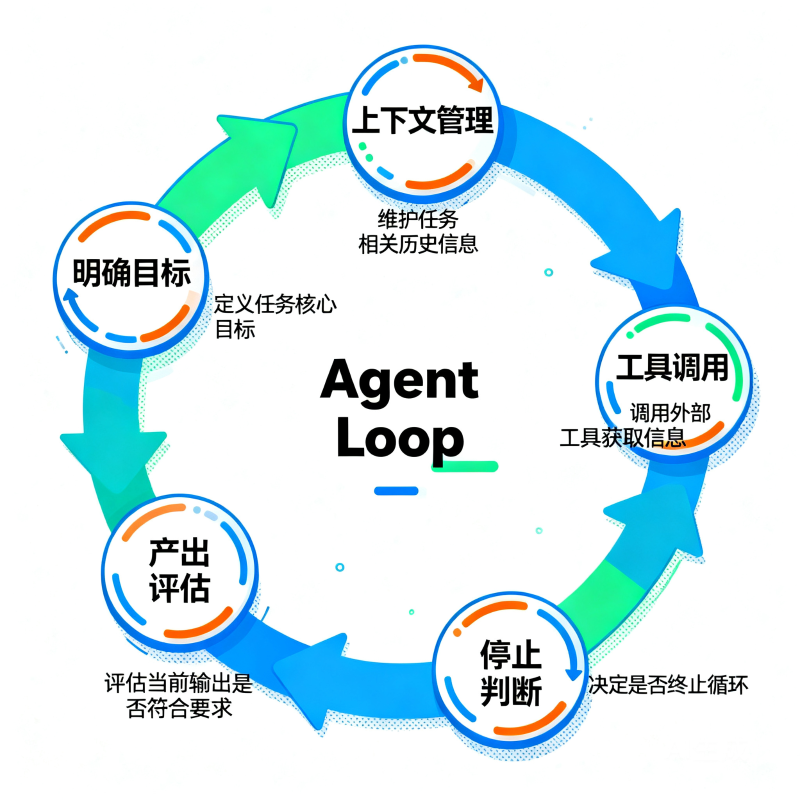
提示词工程过时了吗?为什么 2026 年大家开始谈 Loop Engineering
发布日期:2026-06-22 | 话题:AI 工程范式 | 适用人群:开发者、AI 工程师 Loop Engineering(循环工程)是 2026 年 6 月迅速席卷 AI 开发社区的新范式,起点是 OpenClaw 创始人 Peter Steinberger 一条获得 800 万次浏览的推文:
AI与智能服务
未读
智能客服大模型:隐私合规与成本控制
某头部城商行技术总监近期遭遇了一个棘手难题:业务部门希望引入最新大模型升级客服系统,但合规部门对用户敏感数据出境亮了红灯,财务部门则对按Token计费的无底洞账单表示担忧。这正是当前企业面临的普遍困境。要在高并发的智能客服场景接入大模型:数据隐私隔离、合规部署与推理成本控制是三座无法绕开的大山。企业
AI与智能服务
未读
微信AI小程序生态:模型接入与组件解析
开发者在将大语言模型能力搬上移动端时,常常会遇到接口适配繁琐、UI渲染卡顿、流式输出断触等痛点。为了彻底打通这些技术瓶颈,近期微信发布AI小程序生态:底层模型接入规范与原生组件开发解析,为开发者提供了一套从底层算力调用到前端交互渲染的完整标准。这份微信AI小程序生态接入指南不仅统一了多模型切换的AP