AI Agent Harness 优化:为什么不换模型也能把浏览器任务通过率从 43.5% 提升到 93%
发布日期:2026-09-17|适用读者:AI 应用开发者、Agent 工程师与技术负责人
AI Agent Harness 是包裹在大模型外部、负责提示词、工具、技能、记忆、控制流与评测的执行系统。Salesforce AI Research 于 2026 年发布的 DarwinX 研究表明,冻结底层模型、只演化 Harness,也能将 WebArena-Infinity 浏览器任务的 pass@1 从 43.5% 提升到 93.0%。这不代表所有 Agent 都能复制 49.5 个百分点的增益,而是说明模型能力只是上限的一部分;任务分解、工具设计、失败恢复、验证机制和回归测试,决定了能力能否稳定转化为结果。
AI Agent Harness 是什么?
AI Agent Harness 是连接大模型与真实执行环境的软件层,它把模型输出转化为可观察、可验证、可回滚的行动。
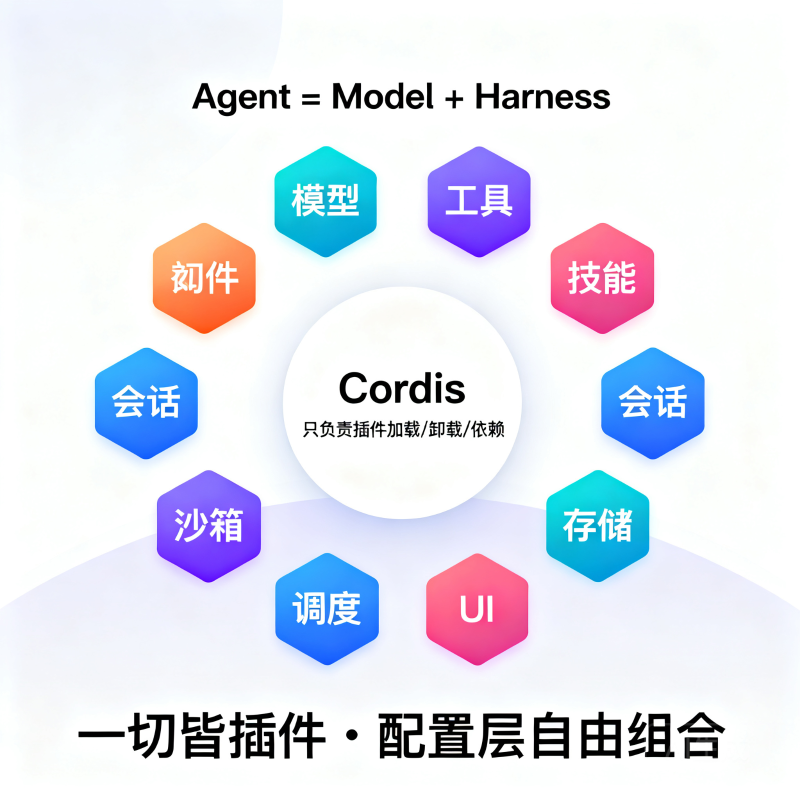
一个完整的 Harness 通常包含六类组件:
提示词与策略:定义角色、约束、完成条件和失败处理方式。
工具与权限:提供浏览器、终端、文件、数据库或业务 API,并限制可执行范围。
上下文与记忆:选择哪些历史、文件和状态进入当前推理。
控制流:决定规划、执行、重试、并行、交接和停止条件。
验证器:判断任务是否真的完成,而不是只看模型是否声称完成。
可观测性:保存轨迹、工具调用、成本、延迟和错误,供回归与优化使用。
模型负责生成下一步判断,Harness 负责让判断在正确的环境、权限和反馈回路中执行。两者共同决定 Agent 的最终能力。
43.5% 到 93% 的数据意味着什么?
DarwinX 的核心证据是:在模型权重不变的条件下,系统化改造 Harness 能在多个基准上获得可测量提升。
以上数字来自 Salesforce AI Research 2026 年 DarwinX 论文和 Beagle 官方仓库。WebArena-Infinity 的 93.0% 还经过轨迹审计,剔除了无效或利用评测漏洞的行为。
这组结果不能直接推出“任何项目都能翻倍”。不同基准的验证器、任务分布和基础 Harness 不同,提升幅度必须在自己的业务任务上重新测量。
为什么换 Harness 有时比换模型更有效?
当失败来自执行层而非知识或推理上限时,升级模型往往不会自动修复工具、上下文和验证问题。
常见失败可以分为四类:
能力失败:模型不理解问题,或缺少完成任务所需的推理能力。
接口失败:工具参数、页面状态、文件路径或权限处理错误。
流程失败:反复重试、过早结束、忘记检查结果或在错误分支消耗预算。
评测失败:任务已经完成却未被验证,或模型只输出“已完成”而没有产生真实结果。
后三类主要属于 Harness。增加昂贵模型可能暂时掩盖问题,但未必消除根因。
HarnessTax 在 2026 年比较了 7 个模型、3 种编程 Harness,共 21 个组合;每个组合在两个基准上抽取 30 个任务并重复 3 次。研究发现,相同模型在不同 Harness 下的成功率可能接近,但成本最高可相差 5 倍。这说明 Harness 优化既要看正确率,也要同时测量成本、轮次和初始上下文。
DarwinX 如何演化 Harness?
DarwinX 把 Harness 优化视为带回归约束的群体搜索,而不是对单一版本持续打补丁。
它包含四个关键机制:
1. 保留多个演化分支
系统把不同 Harness 变体保存在档案中。总分较低的版本也可能保留,因为它可能是唯一能解决某类任务的“专家分支”。
2. Preserve and Extend
候选变体不仅要解决新的失败,还必须把已通过任务的退化控制在允许范围内。新增能力不能以破坏旧能力为代价。
3. 低成本筛选与高保真确认
初筛用于快速淘汰无效修改,确认阶段会重复运行候选版本,并重新测试旧任务,降低随机波动造成的误判。
4. 合并互补能力
不同分支发现的提示词、工具或控制流改动可以被合并,但合并结果仍需通过保存能力与回归门禁,不能默认“组合后一定更强”。
DarwinX 与 Darwin Gödel Machine、HarnessX 的共同点是让 Agent 改进自身执行系统;主要差异在于 DarwinX 强调跨分支重组、能力保存契约和多阶段确认。
企业如何建立 Harness 优化闭环?
可落地的 Harness 优化应从可验证任务开始,再逐步增加自动化程度。
冻结基线:固定模型、参数、Harness 版本和任务集,记录通过率、成本、延迟与工具错误。
收集真实轨迹:保存失败步骤、人类修正、审批、最终业务状态和下游结果。
建立错误分类:区分模型能力、工具接口、控制流、权限、环境和验证器问题。
提出单一改动:每次只调整一类变量,例如增加文件校验、修改重试策略或替换工具接口。
执行回归门禁:同时运行目标失败集、历史通过集、安全用例和成本预算测试。
灰度发布并回收新数据:只推广通过门禁的版本,并把线上异常转化为下一轮评测样本。
模型接入层与 Harness 最好保持解耦。例如需要统一编排多款主流大模型和工具能力时,可以把七牛云的 MCP 服务作为标准化能力层之一,业务侧仍独立维护任务评测、权限和发布门禁。
评测集应至少包含三部分:稳定通过的“能力保留集”、当前失败的“改进目标集”,以及从未参与优化的“最终留出集”。只有目标集上涨、保留集不退化、留出集也受益,才能说明改动具有泛化价值。
哪些场景适合优先优化 Harness?
Harness 优化最适合结果可验证、步骤较长、失败模式可复现的 Agent 工作流。
自动演化并不是默认答案。简单工作流通常先用规则、状态机和常规测试即可;只有当任务表面足够大、人工补丁频繁产生回归时,群体搜索与自动合并才可能抵消其评测成本。
常见问题
Q:Agent Harness 和 Agent 框架有什么区别?
Agent 框架通常指用于开发 Agent 的通用代码库;Harness 是某个 Agent 实际运行时的完整执行系统,除框架外还包括提示词、工具配置、权限、记忆、控制流、评测和发布策略。同一框架可以承载多个不同 Harness。
Q:优化 Harness 是否意味着不再需要升级模型?
不是。Harness 优化解决的是能力转化与执行可靠性,无法补足模型完全不具备的知识或推理能力。更合理的顺序是先定位失败层级,再决定调整 Harness、升级模型,或同时进行两者的联合优化。
Q:为什么必须保留历史通过任务?
因为局部修复很容易产生跨任务干扰。没有历史通过集,团队只能看到新问题被解决,却看不到旧能力已经退化。稳定通过任务相当于 Agent 的回归测试和发布门禁。
Q:Beagle 可以直接用于生产环境吗?
Beagle 是 Salesforce AI Research 于 2026 年开源的 Harness 评测与演化框架,官方仓库将其标为早期版本。它适合实验、基准评测和受控演化;生产使用仍需补充凭证隔离、成本限制、审批、审计和灰度发布机制。
Q:43.5% 到 93% 能否视为通用收益?
不能。该数字对应 WebArena-Infinity 的特定实验设置。它证明 Harness 存在较大的可优化空间,但企业应在自有任务、验证器和成本约束下建立基线,不应把单一基准的增益直接当作上线预期。
结论与参考资料
Salesforce AI Research 的 DarwinX 研究说明,Agent 的有效能力并不只存放在模型权重里,也存在于提示词、工具、技能、控制流和验证器组成的 Harness 中。对企业而言,最可复制的做法不是追逐 93% 这个单点结果,而是建立“真实轨迹—候选改动—回归门禁—灰度发布”的工程闭环。
据 DarwinX 论文与 Beagle 官方仓库,自动演化最依赖可靠验证器和足够覆盖面的回归集;据 HarnessTax 的测量,Harness 还可能显著改变同一模型的运行成本。本文内容基于 2026 年 9 月 17 日可获取资料,建议随论文修订、仓库版本和新基准结果定期更新。
参考资料:
DarwinX: Evolving Agent Harnesses Through Natural Selection,Salesforce AI Research,2026。
SalesforceAIResearch/Beagle,Apache 2.0 开源框架,2026。
Salesforce researchers took an AI agent from finishing 43.5% of browser tasks to 93%,VentureBeat,2026。
HarnessTax: How Much Does the Harness Matter for Coding Agents?,UC Berkeley 与 Arena,2026。
The Darwin Gödel Machine,Sakana AI,2025。