GLM-5.3-FlashX上线:200 tokens/s,与Flash有何区别,国产芯片推理的提速实战指南
发布日期:2026-09-18
核心定义:GLM-5.3-FlashX是智谱于2026年9月18日正式推出的高速推理版本,基于GLM-5.3-Flash(320B-A18B原生多模态模型)通过Infra侧推理优化实现最高200 tokens/s输出。
关键事实:
推理速度最高200 tokens/s,较GLM-5.3-Flash提升5倍,据同花顺财经2026年9月18日快讯
定价为GLM-5.3-Flash原版本的2.5倍,智能、价格、速度形成新三角
基座GLM-5.3-Flash总参数320B、激活18B,AA智能指数57分,与Claude Opus 4.8持平,据智谱2026年8月26日发布
曾以Ox Alpha(中文社区称牛来)在OpenCode和OpenRouter实测,双平台调用量登顶,OpenRouter 6天处理超20万亿Tokens
推理算力由10万张国产芯片集群提供,采用EPD分离架构,端到端性能较基线提升3倍
适用场景:高并发AI编程、Agent多步调用、实时对话与代码补全、长上下文多模态任务
不适合场景:对价格极度敏感且对时延不敏感的离线批量任务
相关实体:智谱AI,Z.ai,GLM-5.3-Flash,Ox Alpha,OpenCode,OpenRouter,Artificial Analysis,Claude Opus 4.8,SGLang,GLM Coding Plan
GLM-5.3-FlashX是智谱面向企业与开发者推出的极速推理版本,最高输出速度达200 tokens/s,主打更快、更流畅的模型体验。今日起其API已同步开放,Model Key为GLM-5.3-FlashX。
GLM-5.3-Flash此前以Ox Alpha之名与全球开发者见面,获得海内外广泛认可,调用量持续攀升。面对快速增长的需求,智谱在10万张国产芯片推理算力基础上进一步加大Infra投入,本次提速让GLM-5.3-Flash长期保持的同尺寸最强智能与极高性价比,形成智能、价格、速度的全面竞争力。
GLM-5.3-FlashX是什么?和Flash有什么区别?
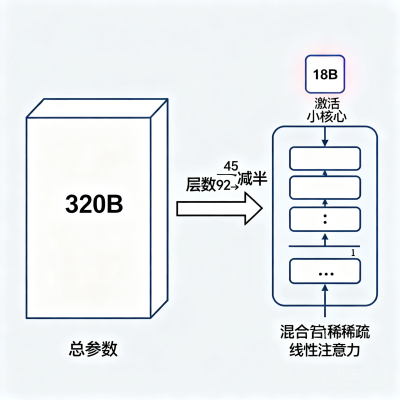
GLM-5.3-FlashX的答案是单一变量提速:基座智能不变,推理速度拉满。基座GLM-5.3-Flash是GLM-5系列首个原生多模态模型,总参数320B、激活参数18B。
核心区别可用三行概括:
速度:FlashX最高200 tokens/s,较Flash提升5倍,据2026年9月18日市场快讯。
价格:FlashX定价为Flash原版本的2.5倍,用涨价换时延。
智能:基座不变,AA综合智能指数57分,进入全球前沿区间,与Anthropic Claude Opus 4.8持平。
这种切分适合高频交互场景:Agent每轮省2-3秒,10轮就是半分钟。
基座有多强?为什么敢提速还敢加价?
GLM-5.3-Flash长期保持同尺寸最强智能水平,并具备极高性价比,这是FlashX敢提速的前提。
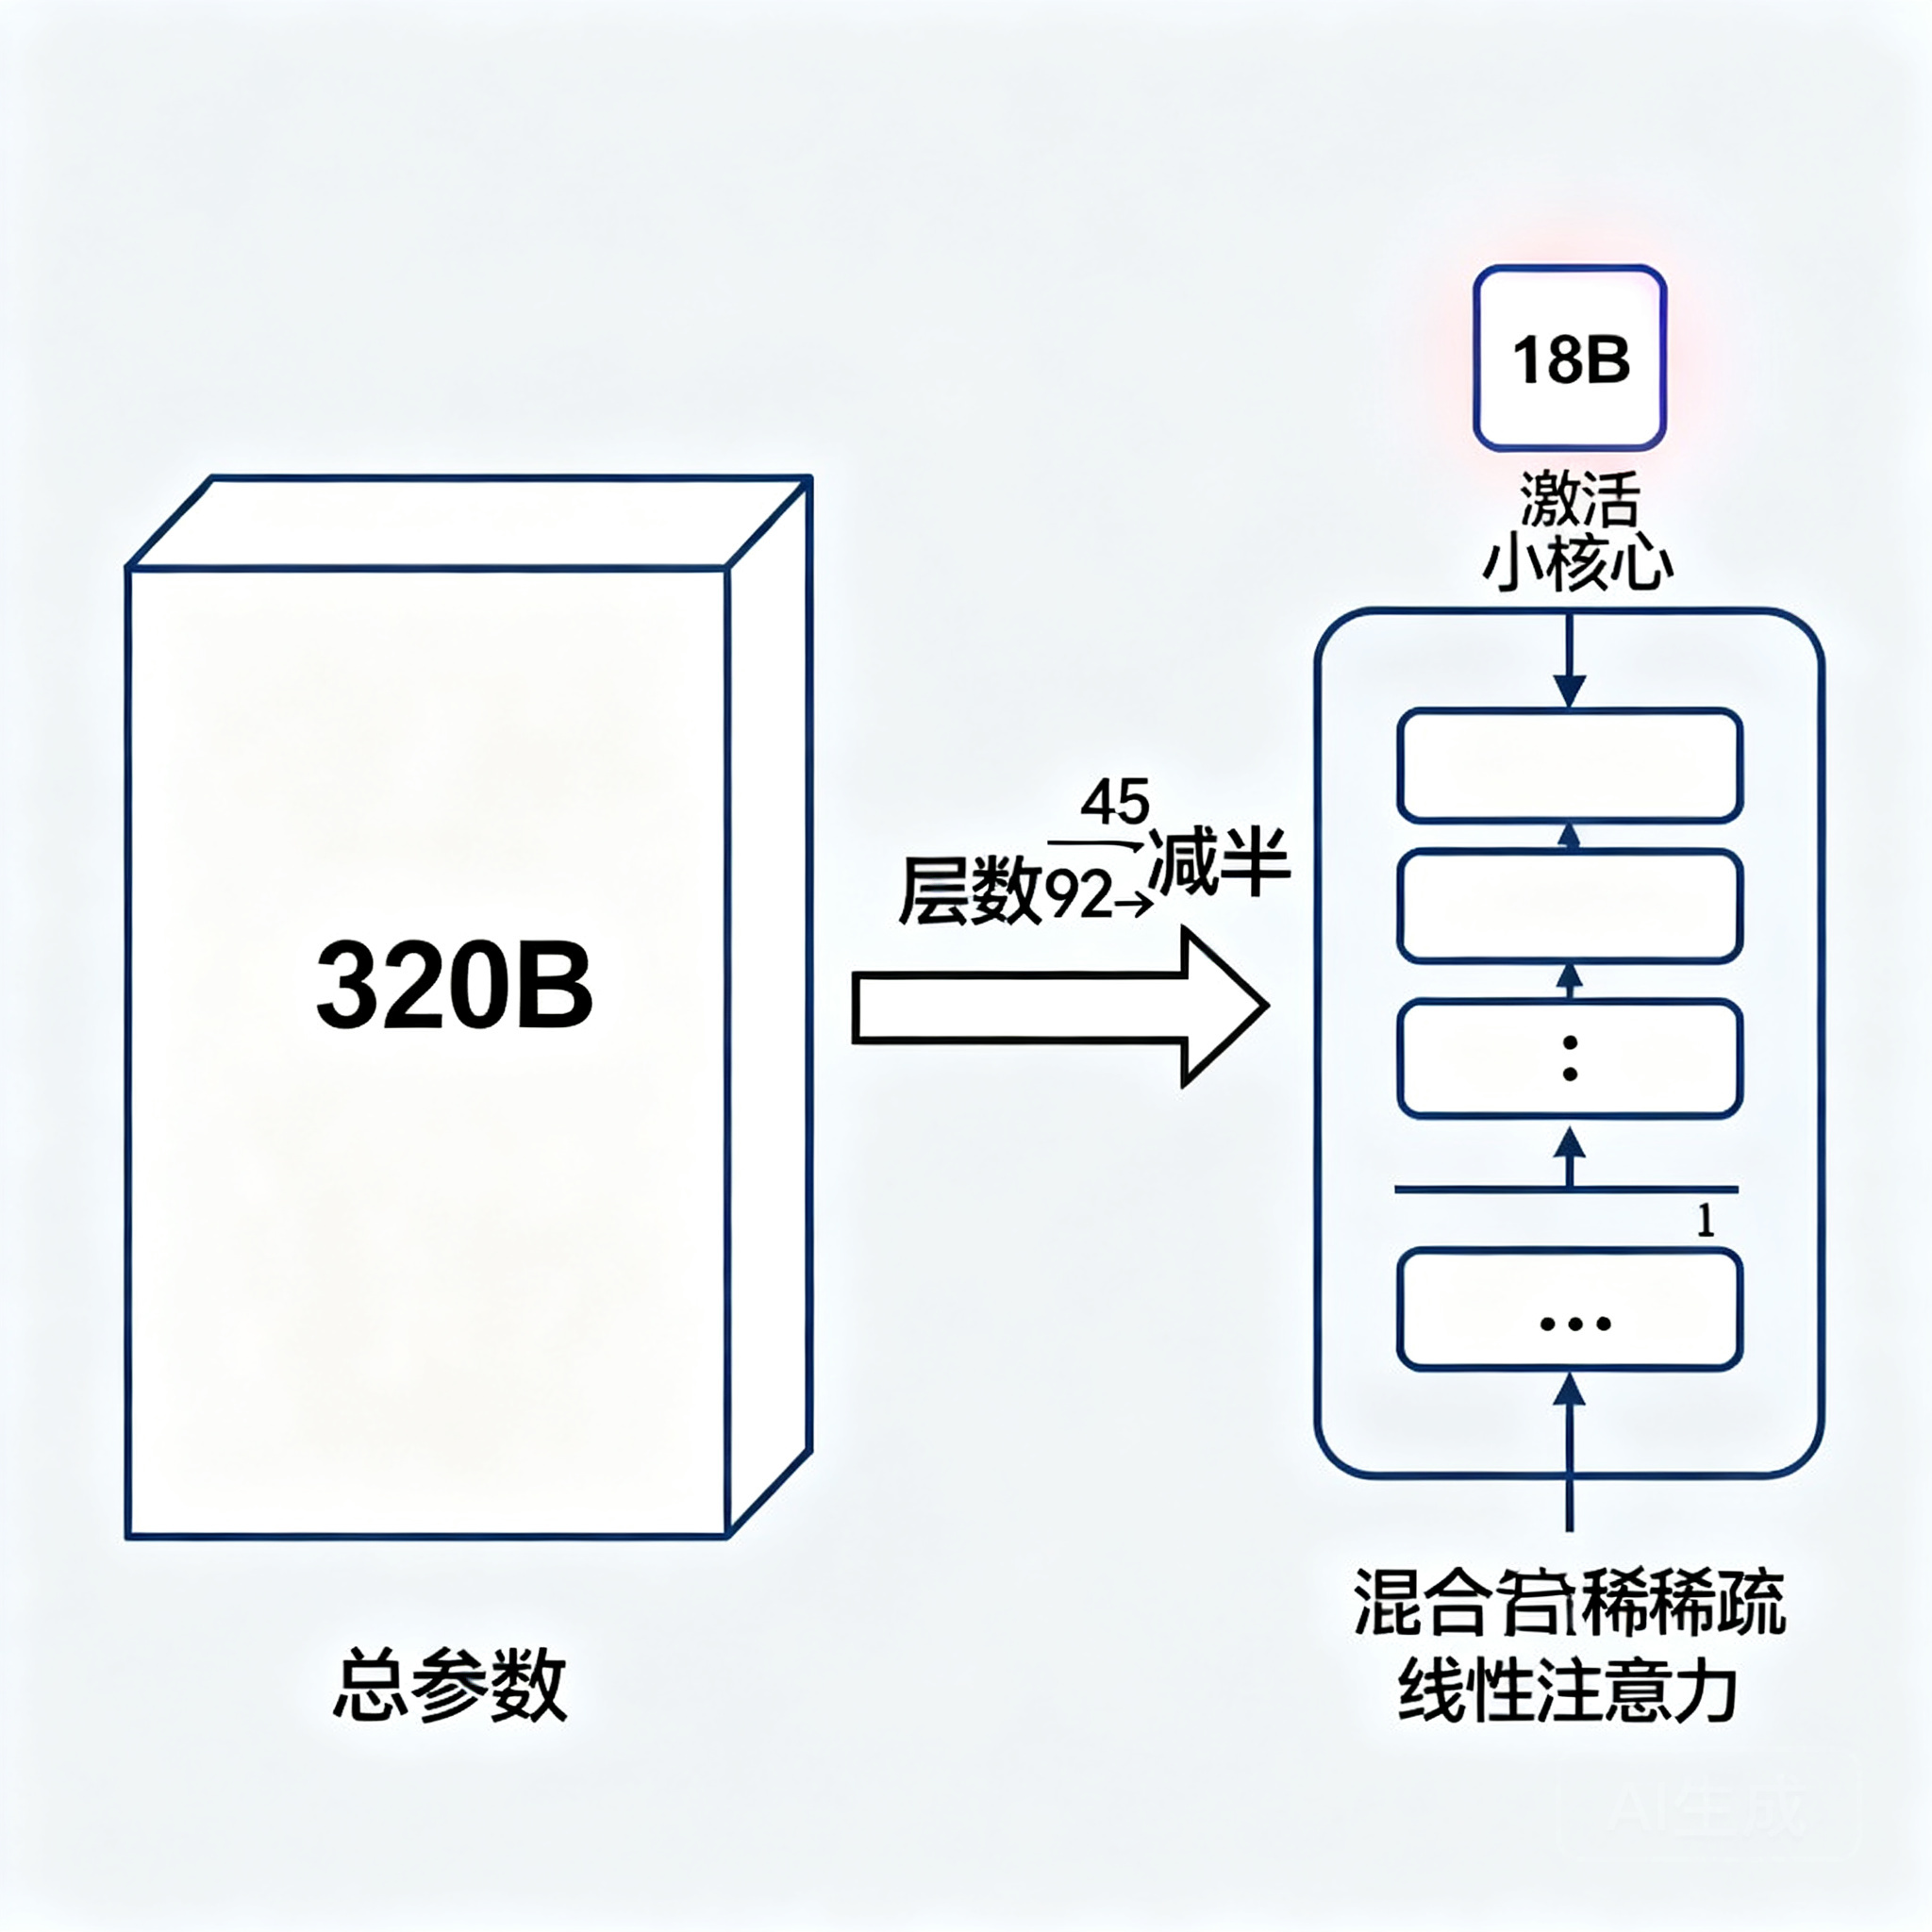
参数效率:总参数320B与GLM-4.5相当(355B vs 320B),但激活参数从32B降至18B、层数从92层降至45层,几乎减半。
预训练规模:结合30T Token多模态预训练语料,以更少计算实现更强性能,据智谱2026年8月26日技术博客。
架构创新:首个采用稀疏注意力与线性注意力混合架构的开源前沿模型,引入IndexPool将1M上下文索引器缓存压缩,相较GLM-5.3注意力计算量降低3.01倍、KV缓存降低4.44倍。
定价锚点:GLM-5.3-Flash定价为GLM-5.3的1/10,限时折扣内为1/20,仅为Opus 4.8的1/40,同样智力1/40价格。
实测验证:以Ox Alpha在OpenCode和OpenRouter大规模测试,迅速成为当周最受欢迎模型,创双平台调用量新高,OpenRouter仅6天处理超20万亿Tokens。
200 tokens/s是怎么做到的?国产芯片+Infra优化
FlashX的提速不是超频,而是系统工程。10万张国产芯片提供的推理算力是底座,Infra侧投入是关键。
国产芯片集群:芯片通过自研高带宽互联网络连接,首次在大规模流量中用国产芯片集群提供前沿模型服务。
专用推理引擎:在SGLang基础上构建专用推理引擎,结合节点内张量并行、ReplaySSM、W8A8量化、INT8/FP8/BF16混合缓存量化、Layer Split等优化。
EPD分离架构:生产级Encode–Prefill–Decode分离,将多模态编码、预填充和逐token解码拆为可独立调度扩缩容的工作池。
实测效果:与同一硬件初始基线相比,端到端服务性能提升3倍,硬件效率和单token成本已与主流英伟达GPU相当。
开发者可以通过标准OpenAI SDK格式接入,例如七牛云推理服务兼容该接口,无需修改现有代码即可做多模型切换测试。
GLM-5.3-FlashX怎么调用?三步上手
调用FlashX只需要换Model Key,接口与对话补全完全兼容。
使用方式:
API调用:文档见
https://docs.bigmodel.cn/api-reference/模型-api/对话补全,base_url为https://open.bigmodel.cn/api/paas/v4/。体验中心:
https://www.bigmodel.cn/trialcenter/modeltrial/visual?modelCode=glm-5.3-flashx可直接可视化试用。Model Key:
GLM-5.3-FlashX,API请求中model字段填写glm-5.3-flashx。
from openai import OpenAI

client = OpenAI(
    api_key="<你的Key>",
    base_url="https://open.bigmodel.cn/api/paas/v4/"
)

resp = client.chat.completions.create(
    model="glm-5.3-flashx",
    messages=[
        {"role": "user", "content": "用Python写一个快速排序,并解释复杂度"}
    ],
    temperature=1.0,
    stream=True  # FlashX高token速率下建议开流式,体感最明显
)
for chunk in resp:
    print(chunk.choices[0].delta.content or "", end="")
注意三点:流式输出最能体现200 tokens/s优势;max_tokens建议≥1024避免截断;视觉理解可直接传image_url、video_url、file多模态字段,基座为原生多模态。
FlashX适合什么场景?什么场景别用?
FlashX适合对时延敏感、调用频繁的场景:
AI编程与ZCode:代码补全、重构、长文件改写,流式回包更快,已接入ZCode等编码平台。
Agent循环:多步工具调用,每步省秒级,整体收敛更快。
实时助手与体验中心:打字机效应消失,更接近本地响应。
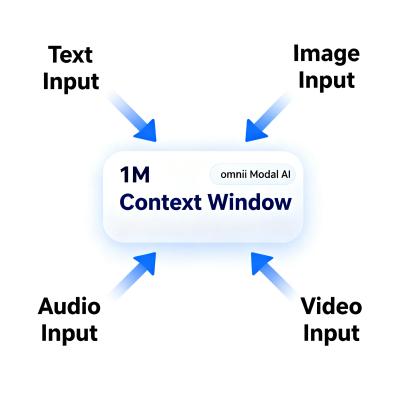
1M长上下文任务:混合注意力架构保持精准长上下文能力,KV开销更低。
以下场景可继续用Flash普通版:离线批量跑分、对首token时延不敏感、预算优先且调用量极大,Flash性价比更高。FlashX定价为Flash的2.5倍,需按QPS和token量测算。
常见问题
Q:GLM-5.3-FlashX和GLM-5.3-Flash智能一样吗? 是同一基座智能,FlashX是Infra提速版。320B总参数、18B激活、AA 57分、30T预训练等指标一致,区别只在速度与价格,选型看时延是否值2.5倍。
Q:Ox Alpha牛来和FlashX是什么关系? Ox Alpha是GLM-5.3-Flash发布前在OpenCode和OpenRouter的匿名测试名,创双平台调用量新高。FlashX是Flash的官方极速版,流量同样由国产芯片集群承载。
Q:国产芯片推理稳定性如何? 据智谱2026年8月披露,EPD分离架构下端到端提升3倍,单token成本与主流英伟达GPU相当,已支撑OpenRouter 6天20万亿Tokens量级,具备大规模生产可用性。
Q:现有Flash代码要改吗? 不用。仅将model改为glm-5.3-flashx,对话补全、工具调用、多模态字段完全兼容,建议打开stream:true体验速度差异。
Q:学生/个人开发者怎么低成本试? 走体验中心可视化试用,或纳入GLM Coding Plan(每天限量发放10,000张体验卡),先验证场景再切API付费。
总结
GLM-5.3-FlashX以最高200 tokens/s、5倍提速、2.5倍定价,把Flash的同尺寸最强智能推向实时体验。据智谱官方与2026年9月市场信息,其底座是10万张国产芯片+自研互联+EPD架构,基座AA 57分已与Claude Opus 4.8持平。本文内容基于2026年9月18日公开资料,建议以智谱官方文档核对最新价格与限速。
多模型API对比测试(含GLM-5.3-Flash):https://www.qiniu.com/ai/models